一、什么是SimCLR:简单对比学习框架
SimCLR(Simple Contrastive Learning Representations,简单对比学习视觉表征框架)是 Google Research 的 Ting Chen 等人于 2020 年提出的视觉自监督对比学习方法。它的核心思想是用极简的端到端架构——对称的对比损失 InfoNCE + 强大的数据增强 + MLP 投影头——在 ImageNet 上实现当时最优的自监督预训练效果。SimCLR 验证了「数据增强组合 + 非线性投影头 + 大 batch 训练」三要素对对比学习的关键作用,是 MoCo、BYOL 等工作的重要对比基准,也是后续 SimCLR v2 在小模型上追平有监督预训练的重要基础。
二、原理
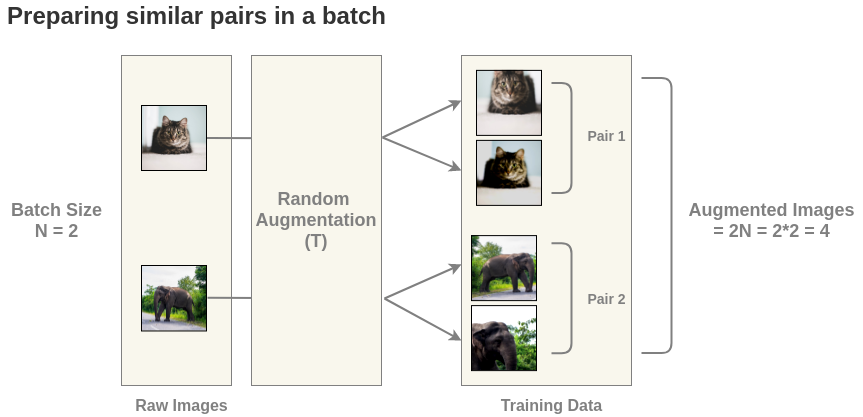
1. 数据增强组合:对同一图像先后施加随机裁剪、颜色抖动、高斯模糊等强增强,生成两路正样本视图 → 2. 双塔编码:两路视图共享同一个编码器(如 ResNet-50),得到视觉特征 h_i 与 h_j → 3. MLP 投影头:将视觉特征送入非线性 MLP 投影头,得到投影向量 z_i 与 z_j → 4. 对比损失计算:在 batch 内对所有样本两两组合,对正样本对用相似度最大化、对负样本对用相似度最小化,损失函数为 NT-Xent(归一化温度交叉熵)→ 5. 反向传播:以大 batch(典型 4096)端到端优化编码器与投影头参数 → 6. 下游使用:训练完成后丢弃投影头,保留编码器作为视觉骨干网络
三、信息卡片
| 中文名 | 简单对比学习框架 |
| 英文名 | Simple Contrastive Learning of Visual Representations |
| 缩写 | SimCLR |
| 别名 | SimCLR v1/v2、简单对比学习、SimCLR 框架 |
| 提出者 | Google Research(Ting Chen、Simon Kornblith、Mohammad Norouzi、Geoffrey Hinton) |
| 提出时间 | 2020 年 2 月(arXiv:2002.05709) |
| 所属类别 | AI 技术 > 机器学习 > 自监督学习 > 对比学习 |
| 核心技术 | InfoNCE 对比损失、组合数据增强(颜色 + 裁剪)、MLP 投影头、大 batch 训练(4096+) |
| 主要应用 | 视觉自监督预训练、半监督学习、少样本图像分类、视觉表征评估基准 |
四、历史时间线
2019-2020 年初:Google Brain 团队在 ICML 2019 发表的 CPC v2、CPC 等工作启发下,探索「极简对比学习」的可能性
- 2020 年 2 月:Ting Chen 等在 arXiv 发表 SimCLR v1 论文,把线性评估准确率在 ImageNet 上推到 69.3%(ResNet-50,batch=4096)
- 2020 年 4 月:Hinton 等公开 SimCLR 代码,单机 8 卡即可复现,引发工业界广泛跟进
- 2020 年 6 月:FAIR 发布 MoCo v2,在 MoCo 框架上吸收 SimCLR 的 MLP 投影头与强增强,把准确率推至 67.5%
- 2020 年 7 月:SimCLR v2 发布,结合自蒸馏 + 更大投影头 + 少标注微调,在仅 10% 标注下 ImageNet 达到 73.9% 准确率
- 2021 年起:SimCLR 与 MoCo、BYOL 一起成为视觉自监督三大对比基准;后续 DINO、MAE 等方法部分继承 SimCLR 的数据增强思路
五、分类
- 按版本:SimCLR v1(基础框架)vs SimCLR v2(加入自蒸馏与更强投影头)
- 按骨干网络:ResNet 系列(主流)vs ViT 系列(后续工作)
- 按增强策略:基础 SimCLR(裁剪 + 颜色)vs 强增强变体(加入高斯模糊、灰度等)
- 按损失函数:NT-Xent(归一化温度交叉熵)vs InfoNCE、Soft-NCE 等变体
- 按训练规模:单机多卡(典型 8 卡)vs TPU Pod(千卡级大 batch 训练)
六、应用场景
视觉自监督预训练:在 ImageNet 等无标注数据上预训练 ResNet-50,下游用于图像分类、检测、分割等任务
- 半监督学习:SimCLR v2 提出「自监督 + 少标注微调」流程,仅用 1%/10% 标注即可逼近全监督效果
- 少样本与零样本图像分类:自监督预训练特征在少样本场景显著优于随机初始化
- 医学影像与遥感:SimCLR 预训练在标注稀缺的 CT 影像、卫星图像分类任务中是常用基线
- 视觉表征评测:SimCLR 是后续自监督方法(如 BYOL、DINO、MAE)的事实对比基准之一
七、优缺点
- 优点:
- 框架极简:仅需「编码器 + 投影头 + 对比损失」三件套,工程实现门槛低
- 效果显著:在 ImageNet 线性评估上首次大幅超越同期有监督预训练(69.3% vs ~76% 全监督,差距迅速缩小)
- 揭示关键因素:系统验证了组合增强、MLP 投影头、大 batch 三大要素的作用,是后续研究的「教科书级」工作
- 开源生态成熟:Google 官方代码与多框架复现版本齐全,复现成本低
- 缺点:
- 依赖超大 batch:需要 4096 以上 batch 才能收敛,对显存与硬件要求高,限制了普通团队的复现
- 依赖强数据增强:增强策略对结果影响极大,换数据集往往需要重新调参
- 依赖大量负样本:在小 batch 场景性能下降明显,与 BYOL/SimSiam 等无负样本路线形成对比
- 对 ViT 不友好:原版 SimCLR 在 ViT 上效果一般,催生了 MoCo v3、DINO 等后续工作
八、常见误区
SimCLR 一定要 4096 batch(错:可以通过梯度累积、记忆库等技巧降低硬件要求,但收敛速度与最终效果可能受影响)
- SimCLR 不需要数据增强(错:组合数据增强是 SimCLR 成功的关键三要素之一)
- SimCLR v2 = SimCLR v1 + 微调(错:v2 引入了自蒸馏、更大投影头等结构性改动,不只是微调)
- SimCLR 已被新方法取代(错:SimCLR 是所有对比学习方法的「基线对照组」,其方法论仍被广泛借鉴)
九、关联概念
父概念:自监督学习、Self-supervised Learning · 自监督学习、深度学习 Deep Learning
- 子概念:对比学习、Embeddings、自监督学习、Self-supervised Learning · 自监督学习
- 兄弟概念:对比学习、Self-supervised Learning · 自监督学习、深度学习 Deep Learning、计算机视觉 Computer Vision
- 对比概念:SimCLR vs MoCo、SimCLR vs BYOL、SimCLR vs MAE、SimCLR vs 有监督预训练
- 应用相关:计算机视觉 Computer Vision、深度学习 Deep Learning、Self-supervised Learning · 自监督学习、对比学习

