一、什么是MAE:掩码自编码器
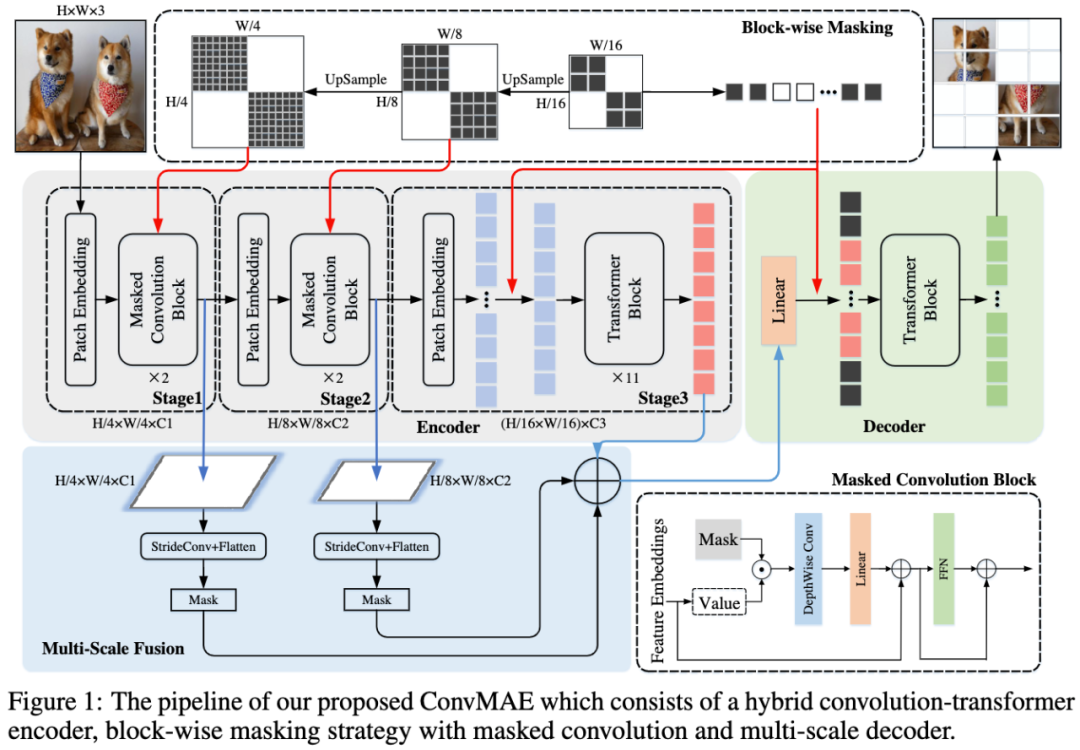
MAE(Masked Autoencoders Are Scalable Vision Learners,掩码自编码器是何恺明团队于 2021 年提出的视觉自监督预训练方法。其核心思想借鉴 NLP 领域的 BERT 掩码语言建模:对输入图像按高比例(如 75%)随机遮挡 patch,仅让 ViT 编码器对可见 patch 做编码,再用轻量解码器重建被遮挡的像素。MAE 首次把「掩码重建」范式系统性地引入视觉领域,大幅提升了 ViT 自监督预训练的效率与效果,在 ImageNet 上仅用 ViT-Large 就能达到 87.8% 的微调准确率。它也是 BEiT、SimMIM、MaskFeat 等视觉掩码重建工作的奠基性方法。
二、原理
1. 图像分块:把输入图像划分为固定大小(如 16×16)的 patch 并线性嵌入为 token → 2. 高比例掩码:随机遮挡约 75% 的 patch token,仅保留 25% 作为可见输入 → 3. 编码器:ViT 编码器仅对可见 patch token 做多头自注意力计算,得到隐层表征 → 4. 解码器:把编码后的可见 token 与被掩码的可学习 mask token 一起送入轻量 Transformer 解码器 → 5. 像素重建:解码器输出每个被掩码 patch 的像素值预测,仅对被掩码 patch 计算 MSE 损失 → 6. 下游使用:训练完成后丢弃解码器,保留 ViT 编码器作为视觉骨干,可微调或线性评估
三、信息卡片
| 中文名 | 掩码自编码器 |
| 英文名 | Masked Autoencoders Are Scalable Vision Learners |
| 缩写 | MAE |
| 别名 | 掩码自编码器、视觉 MAE、MAE 视觉预训练 |
| 提出者 | Meta AI / FAIR(何恺明 Kaiming He 等) |
| 提出时间 | 2021 年 11 月(arXiv:2111.06377) |
| 所属类别 | AI 技术 > 机器学习 > 自监督学习 > 掩码重建学习 |
| 核心技术 | 高比例随机掩码(75%)、非对称编解码器、像素级 MSE 损失、ViT 骨干 |
| 主要应用 | 视觉自监督预训练、目标检测迁移、少样本图像分类、视频自监督、3D 重建 |
四、历史时间线
2018-2019 年:Bert 式的掩码语言建模在 NLP 取得巨大成功,视觉领域出现 Split-Brain 等早期掩码工作
- 2020-2021 年:BEiT、iGPT 等工作把「掩码预测」引入视觉,但效果与可扩展性有限
- 2021 年 11 月:何恺明等在 arXiv 发布 MAE 论文,提出「高比例掩码 + 非对称编解码 + 像素级重建」的极简方案
- 2022 年 CVPR:MAE 论文获得 Best Paper Award,ViT-Huge 版本在 ImageNet 上仅用自监督预训练即达到 87.8% 微调准确率
- 2022-2023 年:衍生工作爆发——Video MAE、MaskFeat(HOG 特征重建)、SimMIM(多尺度掩码)、EVA 系列(MAE + CLIP 蒸馏)等
- 2023-2025 年:MAE 成为「视觉大模型预训练」主流路径之一,与 CLIP、DINOv2 并列为视觉基础模型三大支柱
五、分类
按重建目标:像素级重建(标准 MAE)vs 特征级重建(MaskFeat 用 HOG 特征)vs Token 重建(BEiT/iGPT 路线)
- 按掩码比例:高掩码率(75%,标准 MAE)vs 中等掩码(50-60%)vs 低掩码率(25%)
- 按骨干网络:ViT 系列(主流,ViT-Large/ViT-Huge)vs CNN 系列(ConvMAE 等衍生)
- 按解码器:Transformer 解码器(标准)vs 轻量 MLP 解码器(衍生)vs 无解码器(仅编码器,下游补全)
- 按应用场景:图像 MAE(标准)vs 视频 MAE(VideoMAE)vs 3D MAE(PointMAE 等)vs 多模态 MAE(图像-文本联合掩码)
六、应用场景
视觉基础模型预训练:MAE 是训练 ViT-Huge / ViT-Giant 级别视觉基础模型的主流方法之一(如 EVA、DINOv2 都借鉴 MAE)
- 目标检测与分割:MAE 预训练的 ViT 是 ViTDet、Mask2Former 等检测/分割模型的标准骨干
- 少样本图像分类:在标注稀缺场景,MAE 预训练比随机初始化提升显著
- 视频自监督学习:VideoMAE 把 MAE 扩展到时空维度,是视频理解大模型的常用预训练方案
- 3D 点云与跨模态:Point-MAE、Multi-MAE 等衍生工作把 MAE 范式扩展到点云、图像-文本等场景
七、优缺点
- 优点:
- 训练效率高:仅编码可见 patch,使 ViT-Large 仅需数天即可完成 ImageNet 预训练
- 可扩展到超大模型:MAE 的简单目标使其可平滑扩展到 ViT-Huge / ViT-Giant,是视觉基础模型的事实方案之一
- 下游迁移强:在检测、分割、视频等密集预测任务上,MAE 预训练特征显著优于有监督与对比学习预训练
- 框架极简:仅需掩码 + 编码器 + 轻量解码器 + 像素 MSE,工程实现门槛低
- 缺点:
- 依赖高掩码率:低掩码率场景下重建难度不足,表征质量下降
- 重建目标选择敏感:像素级 MSE 容易过拟合高频细节,需配合 HOG、Token 等特征级重建目标(MaskFeat)
- 对 ViT 之外骨干不友好:原版 MAE 假设 patch 化的 ViT 架构,迁移到 CNN 需要重新设计(如 ConvMAE)
- 微调数据需求较高:在超小样本(<1% 标注)场景,MAE 有时弱于 CLIP 等多模态预训练
八、常见误区
MAE 就是 BERT 的视觉版(错:MAE 在掩码率、非对称编解码、像素级重建等细节上做了关键改造,不能简单等同)
- MAE 一定要重建像素(错:MaskFeat 等用 HOG 特征重建效果更好,BEiT 用离散 token 重建)
- MAE 已被 CLIP/DINO 取代(错:MAE、CLIP、DINO 三大范式互补,EVA、DINOv2 等模型都融合了 MAE)
- MAE 不需要大数据(错:MAE 的优势在大数据 + 大模型上才会完全体现,小数据集上不一定优于对比学习)
九、关联概念
父概念:自监督学习、Self-supervised Learning · 自监督学习、深度学习 Deep Learning
- 子概念:深度学习 Deep Learning、Embeddings、自监督学习、计算机视觉 Computer Vision
- 兄弟概念:对比学习、Self-supervised Learning · 自监督学习、深度学习 Deep Learning、计算机视觉 Computer Vision
- 对比概念:MAE vs MoCo、MAE vs BEiT、MAE vs CLIP、MAE vs DINO
- 应用相关:计算机视觉 Computer Vision、深度学习 Deep Learning、Self-supervised Learning · 自监督学习、对比学习

