一、什么是BLIP:自举语言图像预训练
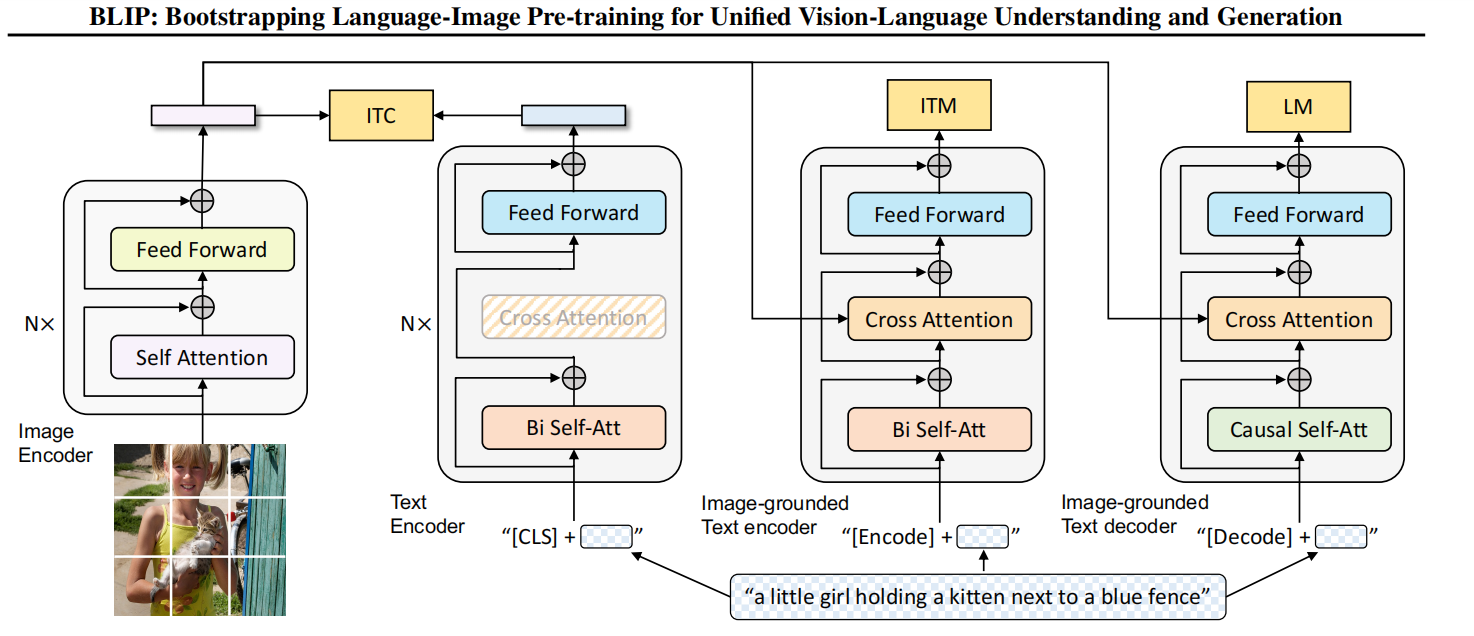
BLIP(Bootstrapping Language-Image Pretraining,自举语言图像预训练)是 Salesforce Research 于 2022 年提出的多模态视觉-语言预训练框架。它通过统一的编码器-解码器架构,同时支持图像-文本对比、图像-文本匹配、图像条件语言建模三类目标,并引入 CapFilt(Captioning + Filtering)自举机制:用网络爬取的噪声图文对训练一个 captioner 生成合成描述、用一个 filter 过滤噪声图文对,从而显著提升数据质量。BLIP 是 BLIP-2、LLaVA、MiniGPT-4 等多模态对话与问答系统的关键前置工作,也是视觉-语言理解与生成统一建模的代表方法。
二、原理
1. 统一架构:图像编码器(ViT)+ 文本编码器 + 文本解码器三模块共享,部分参数通过自注意力交互 → 2. 三类预训练目标:ITC(图像-文本对比学习,类似 CLIP)→ ITM(图像-文本匹配,二分类)→ LM(图像条件语言建模,文本生成)→ 3. 数据准备:收集网络噪声图文对(如 LAION)→ 4. CapFilt 自举:用文本解码器作为 Captioner 给图像生成合成描述、用 ITM 头作为 Filter 过滤原图文对中的噪声样本 → 5. 数据回流:把合成描述与过滤后的高质量图文对加入训练集,迭代提升数据质量 → 6. 下游使用:BLIP 预训练权重可直接用于零样本图像描述、视觉问答,或蒸馏成 BLIP-2 接入大语言模型
三、信息卡片
| 中文名 | 自举语言图像预训练 |
| 英文名 | Bootstrapping Language-Image Pretraining |
| 缩写 | BLIP |
| 别名 | 自举语言图像预训练、BLIP-1/BLIP-2、Salesforce BLIP |
| 提出者 | Salesforce Research(Junnan Li、Dongxu Li、Caiming Xiong、Steven Hoi) |
| 提出时间 | 2022 年 1 月(arXiv:2201.12086) |
| 所属类别 | AI 技术 > 多模态 > 图文预训练 |
| 核心技术 | ITC 对比学习、ITM 匹配、LM 语言建模、CapFilt 自举数据清洗 |
| 主要应用 | 图像描述生成、视觉问答、跨模态检索、多模态对话系统、多模态大模型视觉理解 |
四、历史时间线
2020-2021 年:CLIP 把图文对齐推到新高度,但缺乏生成能力;ALBEF 等工作尝试同时做理解与生成
- 2021 年底:Salesforce 团队提出「能否用 CapFilt 自举机制解决网络图文对的噪声问题」
- 2022 年 1 月:Junnan Li 等在 arXiv 发布 BLIP 论文,提出统一 ITC + ITM + LM 三目标 + CapFilt 自举的框架
- 2022 年 5 月:BLIP 在 Image Captioning(COCO)、VQA、跨模态检索等多个基准上同时刷新 SOTA
- 2022-2023 年:BLIP 衍生工作爆发——BLIP-2(2023)引入 Q-Former 把视觉特征高效蒸馏到大语言模型,是 LLaVA、MiniGPT-4 等多模态对话系统的核心组件
- 2023-2025 年:BLIP-3 / xGen-MM 等延续版本在指令微调、长上下文多模态等方向持续演进
五、分类
按版本:BLIP(原始)vs BLIP-2(引入 Q-Former)vs BLIP-3(指令微调与更长上下文)
- 按预训练目标:单目标(仅 ITC,如 CLIP)vs 双目标(ITC + ITM)vs 三目标(ITC + ITM + LM,BLIP 全部使用)
- 按图像编码器:BLIP-ViT-B/L(主流)vs BLIP-EVA(EVA 骨干大模型)
- 按下游任务:图像描述生成(Captioning)、视觉问答(VQA)、跨模态检索(Retrieval)、多模态对话
- 按数据策略:原始 LAION 噪声数据 vs CapFilt 清洗数据 vs 人工标注数据
六、应用场景
图像描述生成(Captioning):BLIP 在 COCO Captioning 等基准上是事实标杆模型之一
- 视觉问答(VQA):BLIP 在 VQA v2、OK-VQA 等基准上达到 SOTA,可回答「图中有几只狗」类问题
- 跨模态检索:BLIP 同时支持以文搜图与以图搜文,是电商与设计平台的常用方案
- 多模态大模型视觉理解:BLIP-2 的 Q-Former 是 LLaVA、MiniGPT-4、InstructBLIP 等多模态对话系统的核心视觉适配器
- AI 内容审核:BLIP 可生成图像描述并用于违规检测,是 AIGC 内容风控的常用组件
七、优缺点
- 优点:
- 三目标统一:在同一模型内同时支持对比、匹配、生成三类任务,工程复用度高
- CapFilt 自举:通过 captioner + filter 自动清洗噪声图文对,降低对人工标注的依赖
- 理解与生成兼备:相比 CLIP 只能做对齐,BLIP 同时具备图像描述与问答生成能力
- BLIP-2 适配 LLM:通过 Q-Former 高效把视觉特征蒸馏到大语言模型,是多模态 LLM 范式的奠基性工作
- 缺点:
- 训练成本高:三目标 + CapFilt 自举迭代训练,使训练流程比 CLIP 复杂得多
- 模型规模有限:BLIP 原始版本相比 GPT-4V、Gemini 等多模态大模型规模较小,长上下文与细粒度理解能力有限
- CapFilt 依赖高质量预训练模型:自举质量受 captioner 初始能力制约,若预训练差则无效
- 对中文支持弱:原始 BLIP 在中文上效果有限,需配合 ChineseBLIP 等中文衍生版本
八、常见误区
BLIP = CLIP + Captioning(错:BLIP 还包含 ITM 匹配目标与 CapFilt 自举数据清洗,结构比 CLIP 更复杂)
- BLIP 只能生成描述(错:BLIP 同时支持检索、问答、对话等任务,是统一的多模态框架)
- BLIP-2 等同于 BLIP(错:BLIP-2 引入 Q-Former 专门用于与大语言模型对齐,是 BLIP 的重大升级而非微调)
- BLIP 已过时(错:BLIP-3、xGen-MM 等延续工作活跃,多模态对话系统的视觉理解骨干仍多用 BLIP 衍生方案)
九、关联概念
父概念:多模态人工智能、多模态人工智能 · Multimodal AI、深度学习 Deep Learning
- 子概念:对比学习、Embeddings、向量检索、AIGC · 人工智能生成内容
- 兄弟概念:对比学习、Self-supervised Learning · 自监督学习、多模态人工智能 · Multimodal AI、深度学习 Deep Learning
- 对比概念:BLIP vs CLIP、BLIP vs LLaVA、BLIP vs Flamingo、BLIP vs MAE
- 应用相关:AIGC · 人工智能生成内容、生成式AI、数字人、AI智能体 AI Agent