一、什么是Hypernetworks:超网络
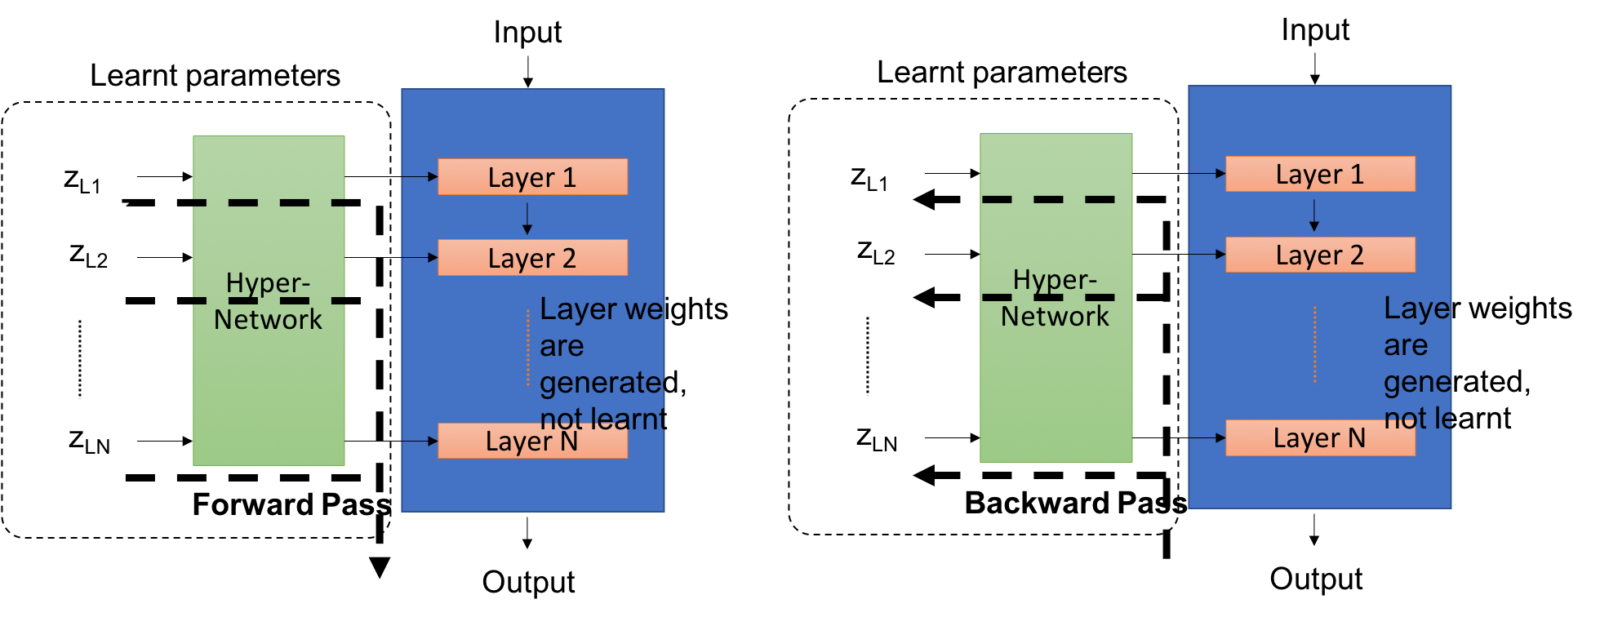
Hypernetworks(超网络)是一类用一个神经网络(hypernetwork)为另一个神经网络(主网络)生成权重的深度学习架构范式,由以色列学者 Ha 等人在 2016 年 NIPS 论文中系统化提出。其核心思想是把「网络权重」本身视为一种可学习的数据,用一个较小的外部网络根据输入或任务条件动态生成主网络参数,从而实现快速适应、跨任务迁移、模型压缩与生成式架构设计等目标。Hypernetworks 与神经架构搜索(NAS)、元学习(Meta-Learning)同属「让模型学会设计模型」的二阶优化范式,并在持续学习、贝叶斯深度学习、扩散模型条件控制等领域有重要应用。
二、原理
1. 网络分两层:主网络(main net)负责实际推理,超网络(hypernetwork)负责生成主网络的部分或全部权重 → 2. 输入条件:超网络可接收任务 ID、上下文向量或随机噪声作为输入,从而为不同任务/样本生成不同主网络参数 → 3. 权重生成:超网络通过若干全连接/卷积层把低维条件向量映射为高维权重张量 → 4. 前向推理:主网络用生成出的权重完成正常的前向计算得到输出 → 5. 二阶梯度:损失通过主网络输出反向传播回超网络,超网络权重被更新 → 6. 部署形式:训练完成后超网络与主网络可以一起部署,也可以蒸馏为单一静态网络以加速推理
三、信息卡片
| 中文名 | 超网络 |
| 英文名 | Hypernetworks |
| 缩写 | Hypernet |
| 别名 | 超网络、权重生成网络、Meta-Networks |
| 提出者 | David Ha、Andrew Dai、Quoc V. Le(Google Brain) |
| 提出时间 | 2016 年 12 月(NIPS 2016,arXiv:1609.09106) |
| 所属类别 | AI 技术 > 深度学习 > 元学习 > 动态网络 |
| 核心技术 | 权重生成网络、二阶优化、动态参数化、条件式网络、条件 BatchNorm |
| 主要应用 | 持续学习、跨任务快速适应、模型压缩、扩散模型条件控制、贝叶斯不确定性建模 |
四、历史时间线
1990 年代:Schmidhuber 等学者在「学习网络的学习」思想下提出可生成权重的元网络雏形,但受限于算力未广泛应用
- 2016 年 12 月:David Ha 等在 NIPS 发表《HyperNetworks》论文,系统化提出用一个小型 RNN 生成 CNN 主网络权重的架构
- 2017-2019 年:Hypernetworks 被扩展到视频预测、贝叶斯神经网络、持续学习等场景;与神经架构搜索(NAS)形成「数据驱动 vs 结构驱动」的两条元学习路线
- 2020 年:受扩散模型兴起影响,Hypernetworks 成为条件生成的重要工具,被用于跨域图像生成、风格迁移、3D 资产生成等任务
- 2022-2024 年:Hypernetworks 与 LoRA、Adapter、Prompt Tuning 等参数高效微调(PEFT)思想融合,出现「权重即输出」的低成本适配方案
- 2025 年:随着大模型多模态发展,Hypernetworks 被用于视觉条件控制、视频生成帧间一致性建模,成为 AIGC 基础设施之一
五、分类
按主网络结构:CNN Hypernet vs RNN Hypernet vs Transformer Hypernet
- 按输入条件:任务条件式(Task-Conditional)vs 输入条件式(Input-Conditional)vs 噪声条件式
- 按权重范围:全权重生成(计算开销大)vs 部分权重生成(如卷积核、BN 参数,主流方案)
- 按应用范式:持续学习、贝叶斯深度学习、扩散模型条件控制、跨任务快速适应、模型压缩
- 按部署形态:训练态 Hypernet(联合优化)vs 蒸馏态单一网络(推理加速)
六、应用场景
持续学习与多任务学习:超网络根据任务 ID 生成对应主网络参数,缓解灾难性遗忘,是元学习与持续学习的核心方法之一
- 扩散模型条件控制:在文生图、视频生成模型中用 Hypernet 动态注入 ControlNet、LoRA 等条件,显著降低条件控制的参数成本
- 跨域快速适应:少量梯度步即可让超网络生成适应新任务的主网络参数,是 Few-Shot Learning 的关键技术路径
- 模型压缩与稀疏化:用小规模超网络生成低秩或稀疏主网络权重,达成模型蒸馏与高效推理
- 贝叶斯深度学习:把权重视为分布并用超网络采样,实现显式不确定性建模,提升医疗、自动驾驶等高风险场景的可信度
七、优缺点
- 优点:
- 动态参数化:可根据任务/样本自适应生成权重,灵活度远超静态网络
- 参数共享高效:一个超网络可为多种主网络生成权重,天然适合多任务与持续学习
- 适配大模型条件控制:在文生图、视频生成中以极小参数增量实现复杂条件注入
- 与 PEFT 范式天然兼容:是 LoRA、Adapter 等高效微调方法的理论基础之一
- 缺点:
- 训练成本高:二阶梯度导致显存与计算开销显著大于普通网络
- 收敛不稳定:超网络与主网络耦合训练,调试难度大
- 推理延迟:未蒸馏时需先跑超网络生成权重,端侧部署不友好
- 理论研究不足:相对于传统网络,Hypernetworks 的泛化与表达能力边界仍待系统研究
八、常见误区
Hypernetworks = 神经架构搜索(错:NAS 搜索网络结构,Hypernetworks 是用网络生成网络权重,二者属于不同维度的「让模型学会设计模型」思路)
- Hypernetworks 只能用 RNN 实现(错:CNN、Transformer、MLP 等都可作为超网络,RNN 只是原始论文的选择)
- Hypernetworks 一定会拖慢推理(错:训练完成后可蒸馏为单一静态网络,推理速度与普通网络相当)
- Hypernetworks 已被 LoRA 完全取代(错:Hypernetworks 是更广义的权重生成框架,LoRA 是其参数高效特例之一,二者并非替代关系)
九、关联概念
- 父概念:深度学习 Deep Learning、机器学习 Machine Learning
- 子概念:LoRA微调、PEFT 参数高效微调、Transformer架构 · Transformer、扩散模型
- 兄弟概念:Transformer架构、Transformer架构 · Transformer、扩散模型 · Diffusion Model、深度学习 Deep Learning
- 对比概念:Hypernetworks vs 神经架构搜索、Hypernetworks vs LoRA、Hypernetworks vs 静态网络
- 应用相关:AIGC · 人工智能生成内容、扩散模型 · Diffusion Model、PEFT 参数高效微调、生成式AI

