一、什么是Neural ODE:神经常微分方程
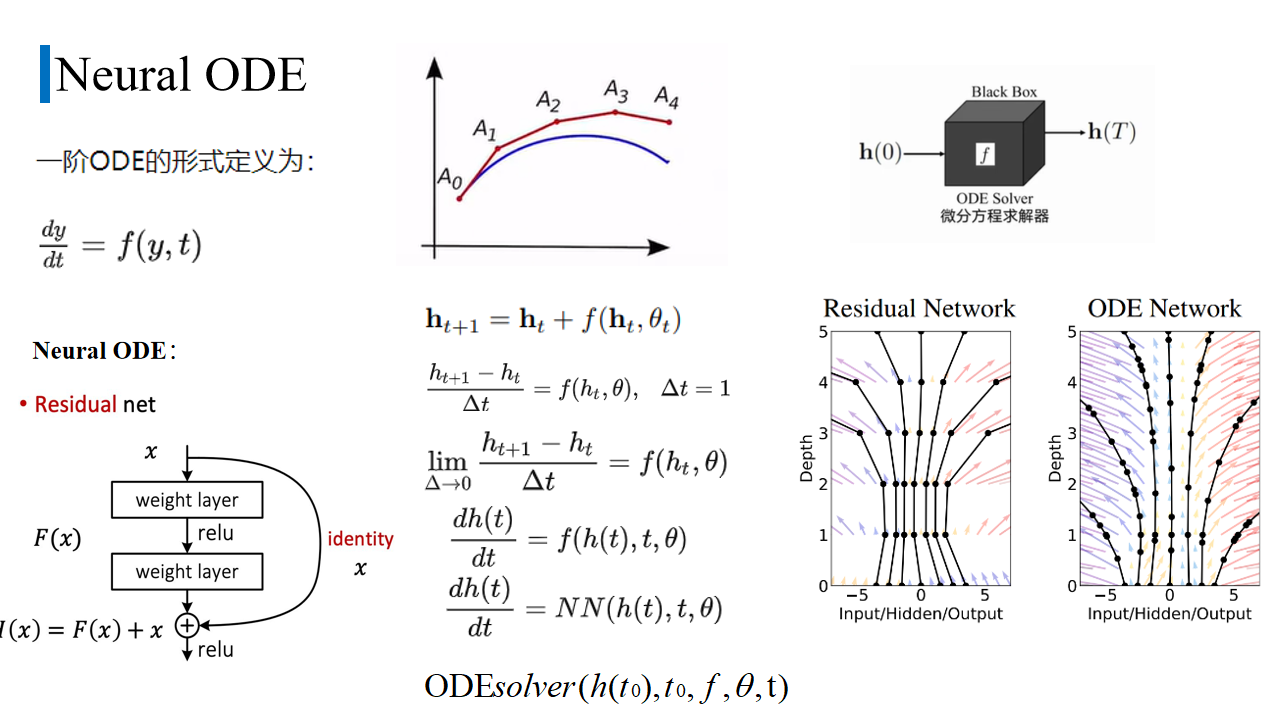
Neural ODE(Neural Ordinary Differential Equations,神经常微分方程)是 Ricky T. Q. Chen 等人于 2018 年 NIPS 提出的连续深度网络范式。它把传统残差网络(ResNet)的「离散层堆叠」重新解释为常微分方程的离散化过程,用一个神经网络学习状态向量随时间的连续导数 dh/dt = f(h, t; θ),并通过伴随灵敏度方法(Adjoint Method)以 O(1) 内存反向传播梯度。Neural ODE 是可逆网络、流模型(Normalizing Flows)与物理启发深度学习的桥梁,被广泛应用于时序建模、动力系统、分子动力学与科学计算等场景。
二、原理
1. 状态定义:把网络隐藏状态 h(t) 视为关于「深度/时间 t」的连续函数 → 2. 导数学习:用神经网络 f(h, t; θ) 学习 dh/dt,即任意时刻的瞬时变化率 → 3. ODE 求解:用 Runge-Kutta、Dormand-Prince 等自适应数值 ODE Solver 把 h(0) 演化到 h(T) → 4. 反向传播:传统反向传播需保存每层状态、内存 O(L);Neural ODE 用伴随方法只保存相邻状态端点,内存 O(1) → 5. 训练优化:基于伴随状态 a(t) = -∂L/∂h(t) 沿时间反方向求解梯度,更新 f 的参数 θ → 6. 推理部署:ODE Solver 步长可自适应控制,在精度与速度间灵活取舍
三、信息卡片
| 中文名 | 神经常微分方程 |
| 英文名 | Neural Ordinary Differential Equations |
| 缩写 | Neural ODE |
| 别名 | 神经常微分方程、连续深度网络、ODE-Net |
| 提出者 | Ricky T. Q. Chen、Yulia Rubanova、Jessica Bettencourt、David Duvenaud(多伦多大学矢量研究所) |
| 提出时间 | 2018 年 12 月(NeurIPS 2018 Best Paper,arXiv:1806.07366) |
| 所属类别 | AI 技术 > 深度学习 > 连续深度模型 > 动力系统 |
| 核心技术 | 常微分方程、伴随灵敏度方法、可逆网络、Black-box ODE Solver、自适应步长 |
| 主要应用 | 时序建模、动力系统预测、分子动力学、物理仿真、归一化流(Normalizing Flows) |
四、历史时间线
2017 年:Weinan E 等提出《A proposal on machine learning via dynamical systems》,首次把 ResNet 与 ODE 显式联系起来
- 2018 年 6 月:Ricky T. Q. Chen 等在 arXiv 发布 Neural ODE 论文,12 月获 NeurIPS 2018 Best Paper
- 2018-2019 年:Augmented Neural ODE、ANODE 等改进版相继出现,解决 ODE 流的拓扑限制问题
- 2019-2020 年:Neural ODE 与归一化流(Normalizing Flows)结合,催生 FFJORD、Neural Spline Flows 等可逆生成模型
- 2020-2022 年:Neural ODE 被广泛应用于分子动力学(OpenMM)、物理信息神经网络(PINN)、时序预测等科学计算场景
- 2023-2025 年:随着科学大模型(AI4Science)兴起,Neural ODE 思想与图神经网络、Transformer 融合,演化出 Graph ODE、Neural SDE 等变体
五、分类
按求解器:固定步长 RK4 vs 自适应步长 Dormand-Prince(DOPRI5)vs 隐式求解器
- 按增强空间:原版 Neural ODE vs Augmented Neural ODE(ANODE,增加维度)vs 输入增强版
- 按随机性:确定性 Neural ODE vs Neural SDE(随机微分方程,引入布朗运动)vs Neural CDE(受控微分方程)
- 按应用场景:时序预测、归一化流、动力系统、物理信息神经网络(PINN)、分子动力学
- 按训练方式:伴随方法反向传播(O(1) 内存)vs 离散化 checkpoint 反向传播(O(L) 内存)
六、应用场景
- 时序建模与不规则采样数据:用连续时间视角处理采样间隔不规则的时间序列,是医疗、金融时序建模的新范式
- 归一化流(Normalizing Flows):通过可逆 ODE 变换构造精确似然的生成模型(FFJORD、Neural Spline Flows)
- 动力系统与物理仿真:把物理方程与神经网络结合用于系统辨识、机器人控制、神经形态视觉等场景
- 分子动力学与药物设计:Neural ODE 与分子动力学模拟器结合,加速 OpenMM 等工具中的分子轨迹预测
- 物理信息神经网络(PINN):Neural ODE 是 PINN 处理偏微分方程与动力系统约束的关键工具
七、优缺点
- 优点:
- 内存高效:伴随方法实现 O(1) 内存反向传播,可训练超大「等效深度」网络
- 自适应计算:ODE Solver 步长自适应,可在精度与速度间灵活权衡
- 可逆性强:天然适配可逆网络、归一化流等需要精确似然的生成任务
- 科学融合度高:为动力学系统、物理仿真、分子模拟等场景提供物理可解释建模工具
- 缺点:
- 训练速度慢:ODE Solver 反复调用前向 ODE 求解器,训练开销显著大于离散 ResNet
- 对求解器选择敏感:不同 ODE 求解器精度与速度差异大,工程调优门槛较高
- 表达能力受限:标准 Neural ODE 流的拓扑能力弱于 ResNet,需 ANODE 等增强技巧
- 生态不成熟:相对 ResNet/Transformer,Neural ODE 的工业级开源工具链与预训练模型较少
八、常见误区
Neural ODE 等价于无限深 ResNet(错:Neural ODE 在连续极限下与 ResNet 等价,但实际求解器是有限步长离散化,效果与字面「无限深」并不等同)
- Neural ODE 训练更快(错:因反复调用 ODE Solver,训练通常比同规模 ResNet 更慢,优势在于内存而非速度)
- Neural ODE 只能用于时间序列(错:Neural ODE 是连续深度网络的通用范式,同样适用于图像、图等静态数据)
- Neural ODE 已被 Transformer 完全取代(错:在物理仿真、科学计算、可逆生成等场景 Neural ODE 仍是首选,与 Transformer 互补共存)
九、关联概念
- 父概念:深度学习 Deep Learning、机器学习 Machine Learning
- 子概念:Transformer架构、Transformer架构 · Transformer、扩散模型 · Diffusion Model、深度学习 Deep Learning
- 兄弟概念:深度学习 Deep Learning、Transformer架构 · Transformer、机器学习 Machine Learning
- 对比概念:Neural ODE vs ResNet、Neural ODE vs Transformer、Neural ODE vs 归一化流
- 应用相关:AI 制药、AI 制药管线、深度学习 Deep Learning、World Model · 世界模型