一、什么是Diffusion Models:扩散模型
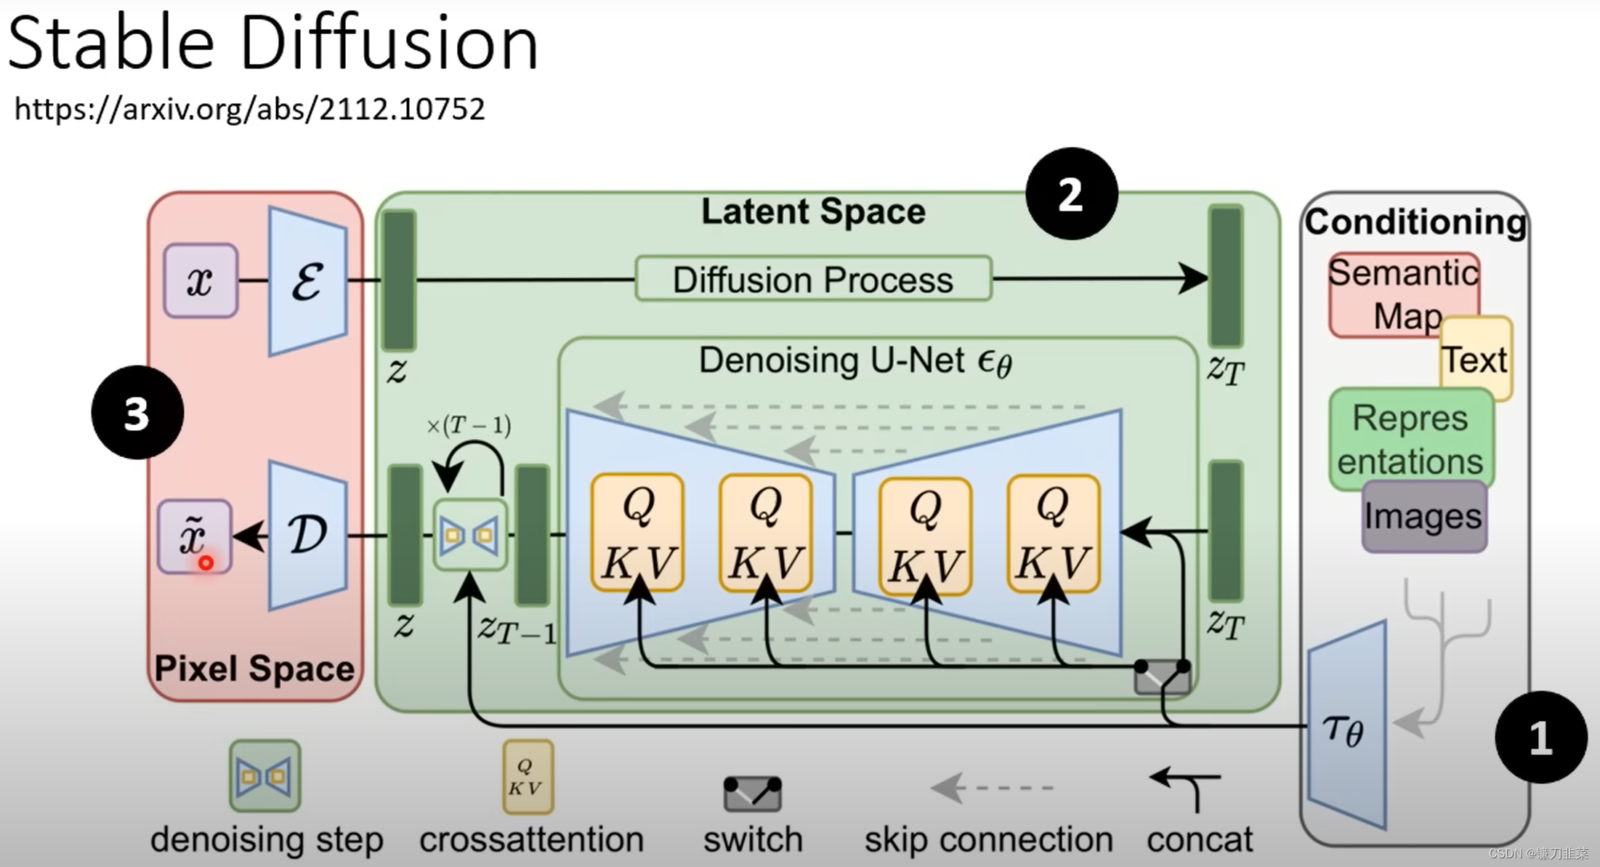
Diffusion Models(扩散模型)是一类通过「逐步加噪前向过程 + 逐步去噪反向过程」实现高质量样本生成的概率生成模型,由 Sohl-Dickstein、Song 等学者奠基,并由 Ho 等人 2020 年的 DDPM 论文推向主流。其核心思想是把数据分布到高斯噪声的扩散过程定义为前向马尔可夫链,把学习目标转化为「预测任意时刻添加的噪声」,再用反向去噪过程从随机噪声逐步恢复出样本。扩散模型在图像、音频、视频、3D 等模态上达到当时 SOTA,是 Stable Diffusion、DALL·E 2、Midjourney、Sora 等 AIGC 标志性产品的核心技术,也是当前生成式 AI 的主流范式之一。
二、原理
1. 前向扩散:对真实数据 x_0 逐步添加高斯噪声,经过 T 步得到近似纯噪声 x_T → 2. 反向去噪:训练一个神经网络 ε_θ(x_t, t) 预测每一步添加的噪声,由 x_T 逐步去噪恢复 x_0 → 3. 损失函数:最小化预测噪声与真实噪声之间的 MSE,等价于 Score Matching 与变分下界 → 4. 采样:从随机高斯噪声 x_T 出发,用 DDPM/DDIM/PNDM 等采样器逐步去噪得到新样本 → 5. 条件生成:通过 Classifier Guidance 或 Classifier-Free Guidance 把文本、图像等条件注入去噪过程 → 6. 加速采样:DDIM、DPM-Solver、Consistency Model 等通过更少步数实现高质量采样
三、信息卡片
| 中文名 | 扩散模型 |
| 英文名 | Diffusion Models / Diffusion Probabilistic Models |
| 缩写 | DM / DDPM |
| 别名 | 扩散模型、扩散概率模型、去噪扩散模型 |
| 提出者 | Jascha Sohl-Dickstein(理论奠基)、Yang Song、Jiaming Song、Stefano Ermon(Score-Based)、Jonathan Ho 等(DDPM,Google/UC Berkeley) |
| 提出时间 | 2015 年理论奠基,2020 年 DDPM 论文引爆主流 |
| 所属类别 | AI 技术 > 深度学习 > 生成模型 > 概率扩散 |
| 核心技术 | 前向加噪、反向去噪、Score Matching、噪声预测、Classifier-Free Guidance、Latent Diffusion |
| 主要应用 | 文生图、视频生成、音频合成、3D 生成、分子设计、超分辨率、图像编辑 |
四、历史时间线
2015 年:Sohl-Dickstein 等在 ICML 发表《Deep Unsupervised Learning using Nonequilibrium Thermodynamics》,首次提出扩散模型理论框架
- 2019 年:Yang Song 等发表 Score-Based Generative Modeling,提出 score 与扩散的统一视角
- 2020 年 6 月:Jonathan Ho 等在 NeurIPS 发表 DDPM 论文(arXiv:2006.11239),把图像生成质量推到 SOTA
- 2021 年:OpenAI 发布 Guided Diffusion 与 GLIDE;Latent Diffusion(Stable Diffusion 基础)由 Rombach 等在 CVPR 发表
- 2022 年 8 月:Stability AI 开源 Stable Diffusion,文生图走入消费级显卡,掀起 AIGC 浪潮
- 2023-2024 年:ControlNet、SDXL、Stable Diffusion 3 持续演进;视频扩散(Stable Video Diffusion、Sora)成为新前沿
- 2025 年:扩散模型与 Transformer、世界模型深度融合,扩展到 3D、医学影像、机器人动作生成等场景
五、分类
按理论视角:DDPM(变分下界)vs Score-Based(Score Matching)vs Flow Matching(连续正则化流)
- 按采样空间:像素空间扩散(Pixel-Space)vs 潜在空间扩散(Latent Diffusion,Stable Diffusion 主流)
- 按条件方式:Classifier Guidance vs Classifier-Free Guidance vs 无条件扩散
- 按应用模态:文生图(T2I)、文生视频(T2V)、图生视频(I2V)、音频扩散、3D 扩散、分子扩散
- 按采样加速:DDPM/DDIM/PNDM/DPM-Solver/Consistency Model
六、应用场景
文生图与文生视频:Stable Diffusion、Midjourney、DALL·E 3、Sora 等标志性 AIGC 产品的核心引擎
- 图像编辑与修复:Inpainting、Outpainting、风格迁移、ControlNet 条件控制等衍生应用
- 3D 与数字资产生成:从文/图生成 3D 模型、NeRF 加速、点云扩散等场景
- 科学与医疗:分子结构生成(AlphaFold3 衍生)、医学影像合成与增强、蛋白质设计
- 机器人与世界模型:扩散策略(Diffusion Policy)用于机器人动作生成,扩散世界模型用于强化学习
七、优缺点
- 优点:
- 生成质量高:在图像、音频、视频等多模态上达到或超过 GAN 的 FID/IS 表现
- 训练稳定:相比 GAN 没有对抗训练,训练目标简单(MSE)稳定收敛
- 条件生成灵活:通过 Guidance、ControlNet 等机制把文本、图像、结构等条件高效注入
- 理论根基深:与 Score Matching、能量模型等理论一致,研究社区持续扩展
- 缺点:
- 采样慢:传统 DDPM 需要 50-1000 步迭代,延迟高于 GAN/VAE
- 算力成本高:高质量图像生成对显存和算力要求高,移动端部署困难
- 可控性局限:细粒度控制(如手指、文字、特定人脸)仍是开放问题
- 数据偏差:模型会放大训练数据偏见,引发伦理与安全争议
八、常见误区
扩散模型 = Stable Diffusion(错:Stable Diffusion 是扩散模型的代表性开源实现,扩散模型是更广义的范式)
- 扩散模型只用于图像(错:扩散模型已扩展到视频、音频、3D、分子、机器人动作等多种模态)
- 扩散模型不需要大算力(错:高质量扩散模型训练通常需要数十到数百张 GPU)
- 扩散模型可以一次生成最终结果(错:扩散模型是迭代去噪过程,需要多步采样才能生成样本)
九、关联概念
- 父概念:深度学习 Deep Learning、生成式AI、AIGC · 人工智能生成内容
- 子概念:扩散模型 · Diffusion Model、GAN 生成对抗网络、扩散概率模型 DDPM、深度学习 Deep Learning
- 兄弟概念:GAN 生成对抗网络、扩散概率模型 DDPM、AIGC · 人工智能生成内容、生成式AI
- 对比概念:Diffusion Models vs GAN、Diffusion Models vs VAE、Diffusion Models vs 自回归模型
- 应用相关:AIGC · 人工智能生成内容、生成式AI、数字人、生成式 3D 资产

