一、什么是AI 算力调度
AI 算力调度(AI Compute Scheduling)是在多集群、多区域、多硬件(GPU/NPU/ASIC)之间对 AI 训练与推理任务进行动态资源分配、抢占、混部与弹性伸缩的中台能力。它把分散的算力抽象为统一的算力池,通过拓扑感知、队列优先级、显存碎片整理与故障迁移等机制,使昂贵的 AI 算力得到最大化利用,是企业把 GPU 集群从「项目独占」走向「平台化运营」的关键基础设施。
二、原理
1. 资源抽象与池化:把多集群异构算力抽象为统一资源池 → 2. 拓扑感知调度:NVLink、RDMA、PCIe 等拓扑亲和性调度 → 3. 队列与优先级:训练/推理/试验等多队列分时复用与抢占 → 4. 弹性伸缩与混部:在离线任务与在线推理之间做资源动态腾挪 → 5. 故障检测与迁移:节点故障自动迁移与训练任务 Checkpoint 恢复 → 6. 成本与配额治理:按项目/部门配额与 FinOps 成本归集
三、信息卡片
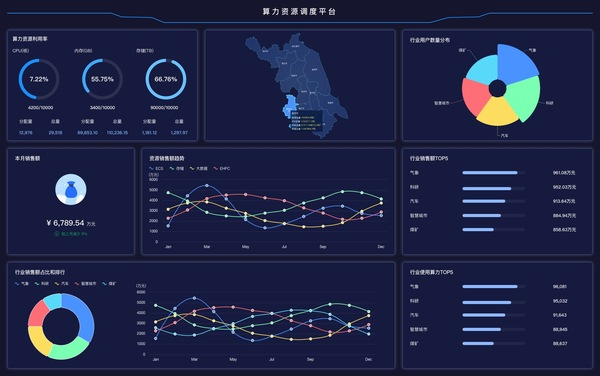
| 中文名 | AI 算力调度 |
| 英文名 | AI Compute Scheduling |
| 缩写 | Compute Scheduling |
| 别名 | AI 算力调度 |
| 提出者 | 2020 年 Volcano、Yarn on K8s 等增强 |
| 提出时间 | 2018 年 |
| 所属类别 | AI 技术 > 人工智能 |
| 核心技术 | 在多集群间动态分配 GPU/NPU 资源的中台能力 |
| 主要应用 | 在多集群间动态分配 GPU/NPU 资源的中台能力 |
四、历史时间线
- 2018 年 Kubernetes 开始支持 GPU 调度。
- 2020 年 Volcano、Yarn on K8s 等增强调度器出现。
- 2022 年随着大模型训练对万卡级集群需求爆发,拓扑感知调度成为焦点。
- 2024 年 Meta、字节等公司开源 MegaScale、BytePS 等大规模训练调度框架。
五、分类
- 基础理论层:聚焦算法、模型与数学原理
- 工程实现层:聚焦框架、平台与部署工具链
- 应用落地层:面向具体业务场景的解决方案
- 安全治理层:覆盖 AI 安全、对齐与可解释
- 生态协作层:开源社区、标准与产业链协作
六、应用场景
- 企业知识库与智能客服
- 代码辅助与研发效能提升
- 数据分析与商业决策
- 内容生成与多媒体创作
- 行业垂直场景落地
七、优缺点
- 优点:
- 提升资源利用率:通过混部与动态调度,集群利用率典型提升 30%-50% 左右
- 降低等待时间:智能排队使任务平均排队时间显著缩短
- 加速大模型训练:拓扑感知使大规模分布式训练通信开销降低约 20% 左右
- 支撑业务弹性:推理流量波动下自动扩缩容保障 SLA
- 沉淀运营数据:为算力投资决策与成本治理提供量化依据
- 缺点:
- 算力与数据门槛:高质量大规模数据与 GPU 集群成为硬性投入
- 可解释性不足:深度模型黑盒决策,难以满足强解释场景的合规需求
- 存在幻觉与偏见:模型可能产生事实性错误或放大训练数据中的偏见
- 运维复杂度上升:模型迭代、监控、版本管理带来额外工程负担
八、常见误区
- AI 能完全替代人工(错:AI 当前更适合增强而非完全替代人类决策)
- 模型越大越好(错:决定效果的是数据质量与场景适配,而非单纯参数规模)
- AI 项目可以一次性上线(错:AI 系统需要持续迭代、监控与再训练)
- AI 准确率越高越好(错:在不同业务场景下需平衡准确率、延迟与成本)
九、关联概念
- 父概念:人工智能 Artificial Intelligence、AI安全
- 子概念:AI智能体 AI Agent、AIGC · 人工智能生成内容
- 兄弟概念:AI Ops · AIOps智能运维、具身智能 Embodied AI
- 对比概念:AI Workflow · AI 工作流、AI Ethics · AI 伦理
- 应用相关:多模态人工智能 · Multimodal AI、人工智能治理 · AI Governance

