一、什么是分布式追踪Trace
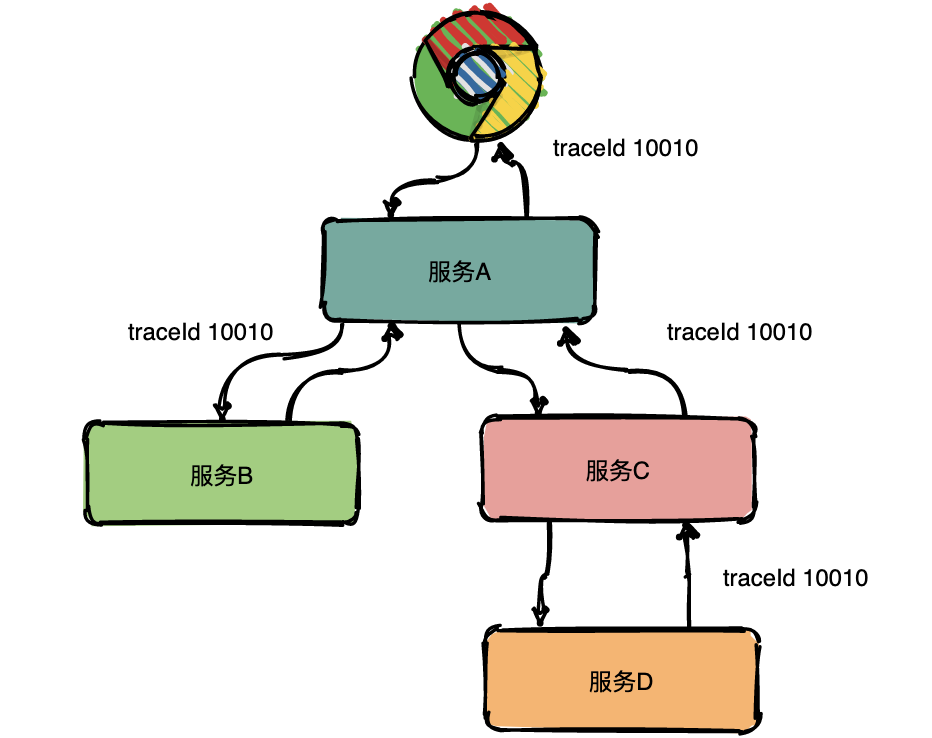
分布式追踪(Distributed Tracing)是通过 Trace ID 与 Span 跨服务还原一次用户请求完整调用链路的可观测技术,包含请求在前后端、移动端、网关、微服务、数据库、消息队列等组件间的传播路径与耗时分布。它从早期 Google Dapper 论文发展至今,已形成 OpenTelemetry 等行业标准协议,是云原生时代定位跨服务性能瓶颈与异常根因的核心手段,也是 SRE 工程师日常排查问题的「X 光机」。
二、原理
1. Trace 数据模型:Trace、Span、SpanContext 与属性规范 → 2. 埋点 SDK:自动与手动埋点,覆盖 HTTP、gRPC、DB、MQ 等协议 → 3. 采样策略:Head-based、Tail-based、自适应采样等控制数据量 → 4. 采集与传输:通过 OTLP 等协议上报到后端 → 5. 后端存储与查询:Jaeger、Zipkin、Tempo、Datadog 等后端 → 6. 分析与可视化:服务依赖图、火焰图、关键路径与异常标注
三、信息卡片
| 中文名 | 分布式追踪 Trace |
| 英文名 | Distributed Tracing |
| 缩写 | Trace |
| 别名 | 分布式追踪 Trace |
| 提出者 | 2015 年 Twitter Zipkin 与 Uber J |
| 提出时间 | 2010 年 |
| 所属类别 | IT 基础架构与开发 > IT基础架构与开发 |
| 核心技术 | 跨服务还原一次请求完整调用链路的技术手段 |
| 主要应用 | 跨服务还原一次请求完整调用链路的技术手段 |
四、历史时间线
- 2010 年 Google Dapper 论文奠定理论基础。
- 2015 年 Twitter Zipkin 与 Uber Jaeger 相继开源。
- 2019 年 OpenTracing 与 OpenCensus 合并为 OpenTelemetry。
- 2022 年 OTel 成为行业事实标准并完成 SDK 与 Collector 体系化。
五、分类
- 基础资源层:计算、存储、网络硬件与虚拟化
- 平台中间层:容器、编排、服务网格与中间件
- 应用架构层:微服务、Serverless、事件驱动
- 研发效能层:CI/CD、平台工程、开发者体验
六、应用场景
- 大型企业 IT 基础设施现代化
- 云原生应用开发与部署
- DevOps 与平台工程实践
- 数据密集型系统建设
- 多云与混合云管理
七、优缺点
- 优点:
- 快速定位瓶颈:通过调用链可视化典型可缩短 60% 左右故障定位时间
- 理解服务依赖:自动生成服务依赖地图辅助架构治理
- 支撑 SLA 分析:按用户、租户、地域做端到端性能分位分析
- 促进协作:前后端、跨团队通过统一 Trace ID 协同排查
- 驱动性能优化:通过关键路径分析定位优化 ROI 最高的环节
- 缺点:
- 运维复杂度上升:组件数量增多导致故障域与排障路径变长
- 学习曲线陡峭:新平台、新范式对团队技术能力要求较高
- 生态绑定风险:过度依赖单一开源项目或云厂商会带来锁定
- 性能与成本平衡:高级特性往往伴随额外资源开销与许可成本
八、常见误区
- 新平台一定优于旧平台(错:需结合团队能力、业务规模与生态成熟度)
- 开源方案没有成本(错:人力、运维、安全加固等隐性成本不容忽视)
- 上云就能解决所有问题(错:跨云、成本治理、可靠性仍是难点)
- 一次架构升级能管十年(错:架构需随业务持续演进)
九、关联概念
- 父概念:云计算 Cloud Computing、FinOps云财务运营
- 子概念:云原生、混合云
- 兄弟概念:多云管理、容器化(Containerization)
- 对比概念:Kubernetes容器编排、Microservices · 微服务
- 应用相关:DevOps · 开发运维一体化、数据库 Database