一、什么是近数据计算
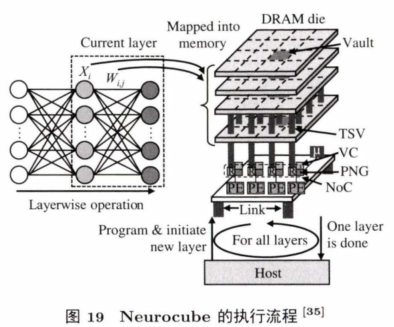
近数据计算(Near-Data Processing, NDP)是把算力下沉到存储侧以减少数据搬运能耗与延迟的计算范式,针对的是冯·诺依曼架构中「数据搬运能耗远大于计算能耗」的核心瓶颈。它通过在 SSD、SCM、HBM、存算一体芯片等存储介质旁布置计算单元,使数据在「最靠近存储的地方」完成过滤、聚合、检索等操作,是大数据、AI 推理、图计算等数据密集型场景突破性能与能效瓶颈的重要方向。
二、原理
1. 存内计算 PIM:在 DRAM、SRAM、闪存内部直接做计算 → 2. SSD 计算:在存储控制器中执行数据过滤与算子 → 3. 近存计算:通过高带宽内存(HBM、3D 堆叠)缩短数据通路 → 4. 数据局部性优化:基于访问模式做算子卸载与放置 → 5. 编程框架:支持 NDP 的算子库、编译器与调度器 → 6. 应用场景:数据库查询加速、AI 推理、图计算、向量检索
三、信息卡片
| 中文名 | 近数据计算 |
| 英文名 | Near-Data Computing |
| 缩写 | NDP |
| 别名 | 近数据计算 |
| 提出者 | 2020 年后三星、SK 海力士等存储厂商相继发布 |
| 提出时间 | 2010 年 |
| 所属类别 | 新兴技术 > 新兴技术 |
| 核心技术 | 把算力下沉到存储侧以降低数据搬运能耗 |
| 主要应用 | 把算力下沉到存储侧以降低数据搬运能耗 |
四、历史时间线
- 2010 年代初期 PIM 研究进入学术视野。
- 2017 年 UPMEM 推出商用 PIM-DIMM 产品。
- 2020 年后三星、SK 海力士等存储厂商相继发布 PIM 方案。
- 2024 年存算一体、近数据计算与 AI 加速深度融合。
五、分类
- 基础研究层:算法、理论与原型验证
- 工程化层:芯片、器件与系统集成
- 应用探索层:行业试点与场景验证
- 生态构建层:开源、标准与产业联盟
六、应用场景
- 前沿科研与高校实验室
- 科技巨头战略布局
- 早期商业化试点项目
- 特定垂直行业深度应用
- 开源生态与开发者社区
七、优缺点
- 优点:
- 降低数据搬运能耗:相比传统架构典型降低 50%-80% 左右
- 提升数据密集型应用性能:数据库、图计算、AI 推理显著加速
- 突破内存墙:为大数据与 AI 提供突破性能瓶颈的新路径
- 支撑新硬件形态:促进存算一体、近存计算芯片发展
- 赋能绿色计算:在性能提升同时降低数据中心能耗
- 缺点:
- 技术成熟度风险:早期技术栈稳定性、生态完善度仍在演进
- 成本与门槛较高:研发投入与硬件采购成本显著高于成熟方案
- 人才稀缺:跨学科复合型人才供给不足
- 标准化滞后:行业标准与最佳实践尚未收敛,互操作性受限
八、常见误区
- 新概念可以立即落地(错:通常需要 2-3 年工程化才能进入生产可用)
- 厂商宣传性能可以直接复用(错:基准测试与生产环境差异巨大)
- 新方案替代旧方案是必然(错:共存、混合、渐进迁移才是常态)
- 技术越前沿越好(错:成熟度与业务匹配度才是关键)
九、关联概念
- 父概念:人工智能 Artificial Intelligence、AI安全
- 子概念:AI智能体 AI Agent、AIGC · 人工智能生成内容
- 兄弟概念:AI Ops · AIOps智能运维、具身智能 Embodied AI
- 对比概念:AI Workflow · AI 工作流、AI Ethics · AI 伦理
- 应用相关:多模态人工智能 · Multimodal AI、人工智能治理 · AI Governance