一、什么是LLM推理加速框架
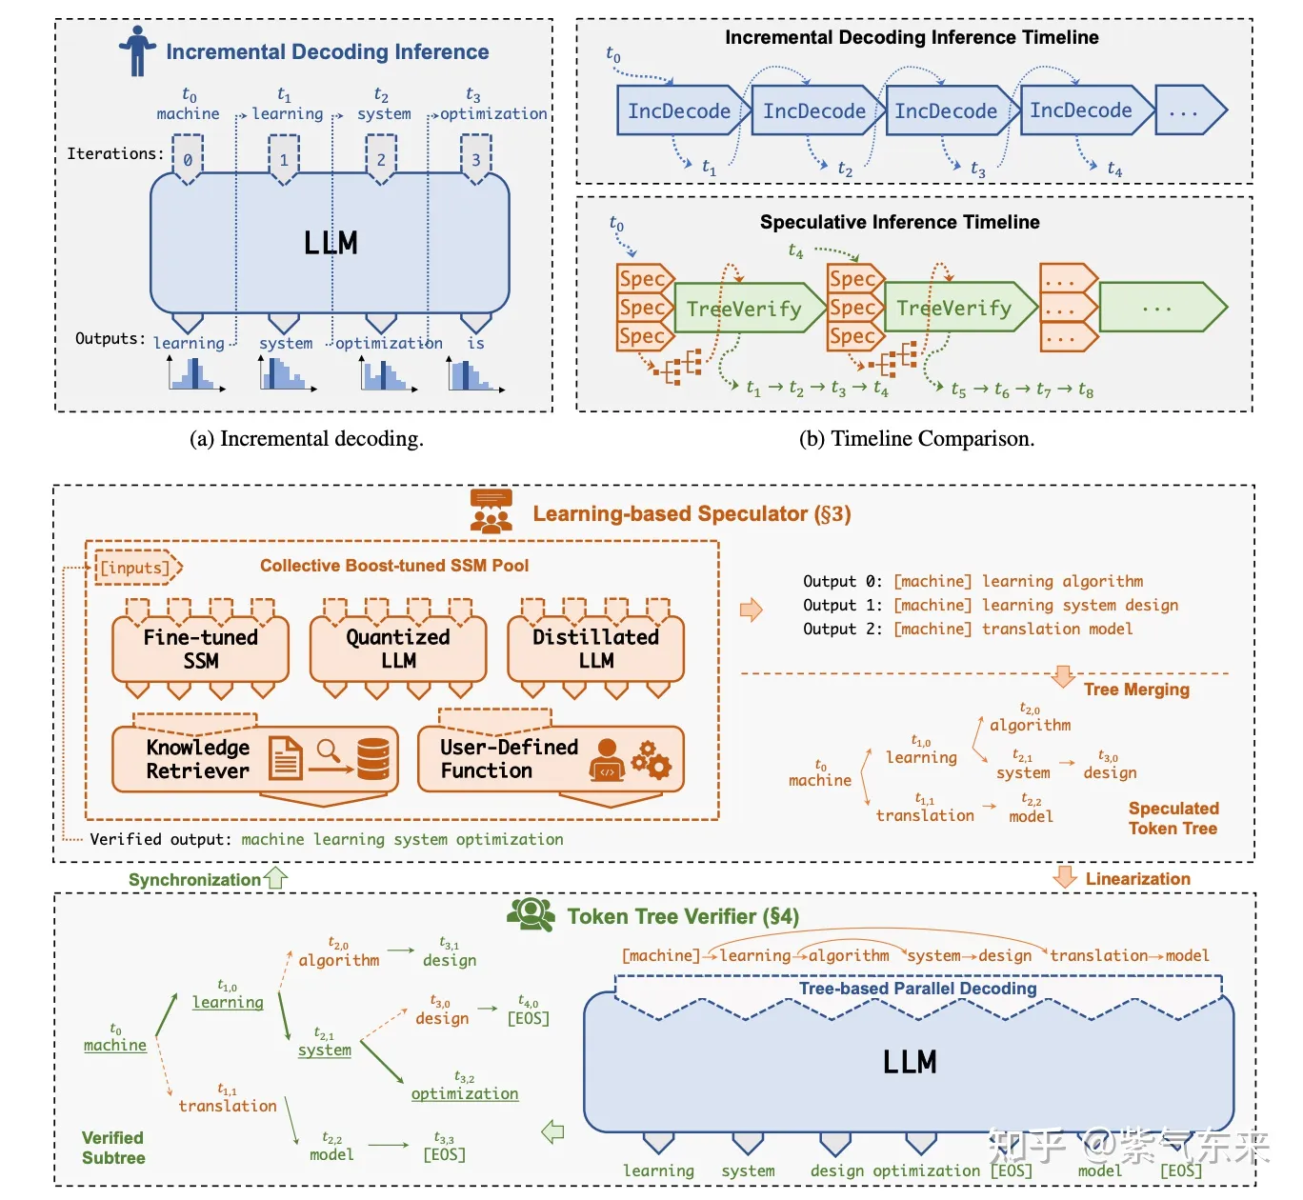
LLM 推理加速框架(LLM Inference Acceleration Framework)是一类为大模型推理提供量化压缩、计算图优化、并行策略、显存管理与算子融合等系统级能力的中间件或运行时引擎。其核心思想是在不显著损失模型能力的前提下,通过软件栈协同优化充分利用 GPU/NPU 硬件特性,使大模型在生产环境中的吞吐量、首字延迟与单位算力产出达到最优。它主要解决开源或自研大模型直接部署时显存占用高、推理慢、并发弱等痛点,使高负载 AI 服务能够以合理的成本运行。该类框架已成为大模型从实验室走向生产的关键基础设施。
二、原理
1. 量化引擎:支持 INT8/INT4 等低精度权重与激活计算,显著降低显存与加速矩阵乘法 → 2. 计算图优化:通过算子融合、常量折叠、内存规划减少内核启动与访存开销 → 3. KV 缓存管理:分页缓存(PagedAttention)或多查询共享机制降低长序列推理的显存占用并提升吞吐 → 4. 并行策略:张量并行、流水线并行与序列并行按模型与硬件拓扑动态组合 → 5. 连续批处理:动态合并多条请求到同一批次,提高 GPU 利用率与吞吐 → 6. 硬件适配层:针对不同 GPU 架构与加速器实现内核级优化与算子特化
三、信息卡片
| 中文名 | LLM 推理加速框架 |
| 英文名 | LLM Inference Acceleration Framework |
| 缩写 | LLM Inference Engine |
| 别名 | 大模型推理框架、LLM Serving、推理加速引擎 |
| 提出者 | 开源社区(vLLM、TensorRT-LLM、TGI、DeepSpeed-MII、SGLang)与云厂商 |
| 提出时间 | 2022-2023 年随开源大模型爆发快速发展 |
| 所属类别 | AI 技术 > 工程层 > 推理优化 > 系统中间件 |
| 核心技术 | PagedAttention、连续批处理、推测解码、FlashAttention、张量并行 |
| 主要应用 | 大模型服务化部署、高吞吐推理、低延迟对话、企业级 LLM 平台 |
四、历史时间线
- 20 世纪 90 年代:编译器与数值计算库的推理优化思想萌芽
- 2016-2018 年:TensorRT、ONNX Runtime 等推理引擎兴起,主要服务于 CNN 模型
- 2019 年后:Transformer 推理的 KV 缓存与自回归特性带来新的优化空间
- 2022 年:FasterTransformer、FlexFlow 等开始专门针对 Transformer 解码优化
- 2023 年:vLLM 提出 PagedAttention 与连续批处理,吞吐量大幅提升;TensorRT-LLM、TGI、DeepSpeed-MII 等并行发展
- 2023-2024 年:Speculative Decoding、FlashAttention、多 LoRA 动态加载等技术被广泛集成
- 2024-2025 年:SGLang、Llama.cpp 等新框架涌现,推理加速框架形成与训练框架并行的独立技术栈
五、分类
按部署形态:云端推理框架(vLLM、TensorRT-LLM)vs 端侧推理框架(Llama.cpp、MLX)vs 边缘推理框架
- 按硬件适配:GPU 推理框架(NVIDIA)vs NPU 推理框架(华为昇腾、寒武纪)vs 多硬件通用框架
- 按优化重点:吞吐优化型(连续批处理)vs 延迟优化型(推测解码)vs 显存优化型(PagedAttention)
- 按模型支持:通用 LLM 框架 vs 领域定制框架(多模态、MoE)
- 按开源属性:开源框架(vLLM、TGI、SGLang)vs 商业框架(TensorRT-LLM、Triton)
六、应用场景
- 大模型服务化部署:为企业级 LLM 平台提供高吞吐、低延迟的推理底座
- 对话与客服系统:在实时对话场景中降低首字延迟、提高并发能力
- RAG 检索增强生成 服务:在 RAG 系统中加速长上下文推理与高并发检索
- AI Agent 工具调用:在 AI智能体 AI Agent 场景中提供高 QPS 的工具执行环境
- 多模型路由:在多模型共存平台中根据请求特征动态路由到不同推理引擎
- 端侧与边缘 AI:在 Llama.cpp 等框架支持下在 PC、手机、嵌入式设备上运行大模型
七、优缺点
- 优点:
- 吞吐大幅提升:在典型配置下吞吐量可较原生 PyTorch 推理提升 5-20 倍左右
- 显存占用下降:结合量化与 PagedAttention,单卡可服务的模型规模显著放大
- 首字延迟优化:通过预填充与解码分离、推测解码等机制使交互体验接近实时
- 部署灵活性增强:同一框架可适配多种硬件与模型家族,降低工程迁移成本
- 缺点:
- 工程复杂度高:底层算子与并行策略对工程师要求高
- 模型兼容性差异:部分新模型或定制算子需要额外适配
- 调试可观测性弱:高度优化后行为链路复杂,问题定位难度上升
- 硬件绑定较强:部分优化高度依赖特定 GPU 架构,跨硬件迁移成本高
八、常见误区
- 推理加速框架 = 训练框架(错:训练框架侧重反向传播与分布式训练,推理框架侧重自回归生成与显存优化)
- 用了推理框架就够了(错:仍需结合量化、缓存、并发调度等才能达到最优)
- 所有框架效果接近(错:不同框架在吞吐、延迟、显存上差异显著,需按场景选型)
- 开源框架性能不如商业框架(错:vLLM、SGLang 等开源框架在多项基准上已领先 TensorRT-LLM)
九、关联概念
父概念:大语言模型 Large Language Model、深度学习 Deep Learning、AI Workflow
- 子概念:模型量化、AI 缓存语义命中、Token 经济性优化
- 兄弟概念:模型量化、LLM 蒸馏、AI 缓存语义命中、Token 经济性优化、GPU集群
- 对比概念:模型量化、LLM 蒸馏、AI 缓存语义命中
- 应用相关:RAG · 检索增强生成、AI智能体 AI Agent、大语言模型 Large Language Model、边缘计算(Edge Computing)、AI PC

