一、什么是AI安全护栏Guardrails
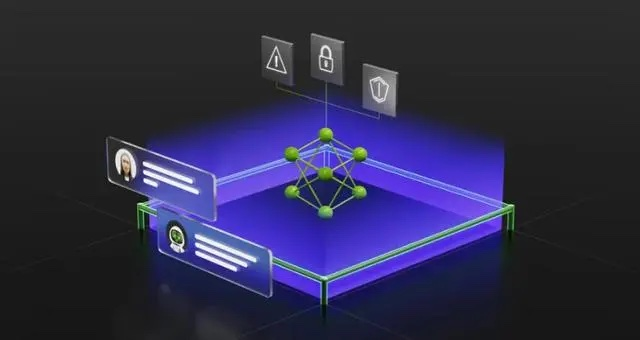
AI 安全护栏(AI Guardrails)是一类部署在大模型输入与输出之间,用于检测、拦截、改写违规、敏感或越权内容,并强制约束模型行为符合预设策略的执行层。其核心思想是把安全与合规规则从提示工程或微调中抽离出来,作为独立的可配置中间层运行,使同一模型可以在不同业务、不同地区下套用不同护栏规则。它主要解决大模型输出不可控、可能泄露敏感信息、生成违规内容或被诱导越权操作的合规风险,使 AI 应用能够在金融、医疗、政务等强监管场景下上线。它是当前 AI 产品合规化的关键基础设施之一。
二、原理
1. 输入校验:对用户提示进行越狱检测、敏感词过滤与意图分类,阻断高风险输入 → 2. 输出审核:对模型响应做合规分类、毒性检测与隐私识别,拦截违规内容 → 3. 策略引擎:以规则、决策表或轻量分类器动态判定是否放行、改写或拒绝 → 4. 改写与回退:在不完全拦截的情况下对输出做中性化改写,并提供预设回退话术 → 5. 审计与日志:完整记录每一次拦截原因与命中规则,便于合规审计与事后追溯 → 6. 策略版本管理:支持多版本、多租户与多地区策略并行部署,灵活应对监管变化
三、信息卡片
| 中文名 | AI 安全护栏 |
| 英文名 | AI Guardrails |
| 缩写 | Guardrails |
| 别名 | AI 护栏、LLM 护栏、大模型护栏 |
| 提出者 | 开源社区(NVIDIA NeMo Guardrails、Guardrails AI)与云厂商(Azure AI Content Safety、AWS Bedrock Guardrails) |
| 提出时间 | 2022-2023 年随生成式 AI 合规化需求爆发成为独立产品类别 |
| 所属类别 | AI 技术 > 安全治理 > 推理时防护 |
| 核心技术 | 输入校验、输出过滤、毒性检测、策略引擎、审计日志 |
| 主要应用 | 大模型企业级部署、AI 内容合规、AI Agent 风控、监管合规 |
四、历史时间线
- 20 世纪 90 年代:内容安全与过滤技术在搜索引擎与邮件系统中已广泛存在
- 2018-2020 年:随着大模型在对话与生成场景的落地,独立护栏概念逐步成型
- 2021-2022 年:开源社区与云厂商陆续推出专门的 LLM 护栏框架
- 2023 年:欧盟 AI 法案等监管框架推动行业加速采用护栏技术
- 2024 年:结构化护栏规范、可观测的护栏执行链路与对抗越狱能力成为产品差异化维度
- 2024-2025 年:护栏从单点过滤演进为覆盖输入、检索、生成、输出的全链路安全体系;与 AI安全 共同构成企业 AI 合规底座
五、分类
按作用环节:输入护栏(Prompt 防火墙)vs 输出护栏(输出审核)vs 检索护栏(RAG 注入防护)vs 工具护栏(Agent 调用约束)
- 按实现方式:规则型护栏(关键词、决策表)vs 分类器型护栏(毒性、PII 检测)vs LLM 型护栏(用大模型评大模型)
- 按部署形态:独立中间件 vs 模型平台内嵌 vs 边缘网关集成
- 按策略来源:组织自定义护栏 vs 行业基线护栏(金融、医疗)vs 地区合规护栏(EU AI Act、中国生成式 AI 办法)
- 按产品形态:开源框架(NeMo Guardrails、Guardrails AI)vs 商业服务(Azure AI Content Safety、AWS Bedrock Guardrails)
六、应用场景
- 大模型企业级部署:在金融、政务、医疗等强合规场景对模型输入输出做强制合规校验
- AI 内容合规:AIGC · 人工智能生成内容 的涉政、涉暴、虚假信息过滤与水印溯源
- AI Agent 风控:在 AI智能体 AI Agent 场景下约束工具调用权限与敏感操作拦截
- RAG 系统安全:在 RAG · 检索增强生成 中防御提示词注入与敏感信息泄露
- 客服与对话系统:在智能客服中拦截违规话术与隐私信息外发
- 多地区合规部署:通过策略版本管理适配 EU、中国等不同地区的合规要求
七、优缺点
- 优点:
- 合规风险降低:自动拦截违规输出使企业满足行业与地区监管要求的成本显著下降
- 品牌声誉保护:减少敏感或争议内容外泄,避免负面事件对品牌的连锁冲击
- 上线周期缩短:标准化护栏框架可复用于多个业务线,使新场景上线时间缩短数周
- 可解释与可审计:拦截决策有规则与依据可查,便于内审外审与监管沟通
- 缺点:
- 可能过度保守:策略过严会导致模型拒绝回答正常问题,影响用户体验
- 对抗持续升级:攻击者不断发明新越狱方式,护栏需要持续迭代
- 性能开销:额外的输入输出检查会增加端到端延迟
- 评测标准未统一:拦截效果高度依赖具体场景与攻击集,难以工程化量化
八、常见误区
- 护栏 = 内容审核(错:内容审核侧重事后过滤,护栏覆盖输入、检索、生成、输出的全链路主动拦截)
- 护栏 = RLHF(错:RLHF 在训练阶段对齐,护栏在推理阶段执行,作用时机与机制不同)
- 上了护栏就安全了(错:护栏只是安全体系的一环,需要与红蓝对抗、提示词注入 防护、模型加固等组合)
- 护栏一定降低模型能力(错:合理设计的护栏能在合规与能力之间取得平衡,仅在策略过严时才会显著影响效果)
九、关联概念
- 父概念:AI安全、人工智能治理、AI Ops · AIOps智能运维
- 子概念:提示词注入、红蓝对抗、AI 红队
- 兄弟概念:AI安全、AI对齐、AI Ethics · AI 伦理、提示词注入、人工智能治理
- 对比概念:AI对齐、提示词注入、内容审核
- 应用相关:AI智能体 AI Agent、RAG · 检索增强生成、AIGC · 人工智能生成内容、大语言模型 Large Language Model、零信任 Zero Trust

