一、什么是模型量化感知训练 QAT
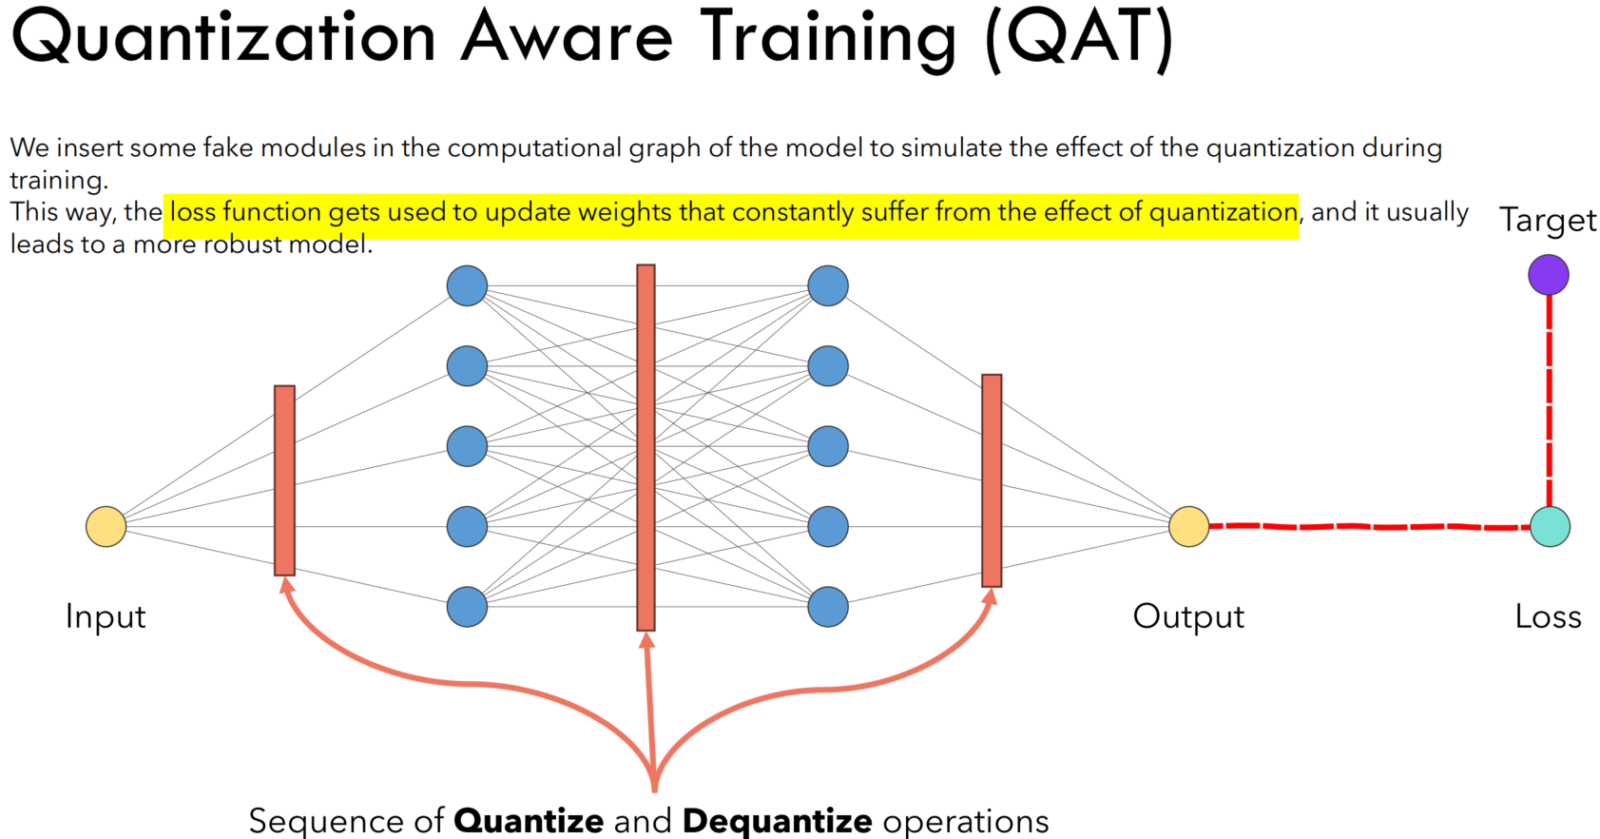
模型量化感知训练(Quantization-Aware Training, QAT)是在模型训练(或微调)阶段引入「伪量化」算子来模拟低比特推理误差,从而使权重在被最终量化为 INT8、INT4 等低精度格式后仍能保持接近浮点精度的方法。它与训练后量化(PTQ)相对,主要解决 PTQ 在小模型、对噪声敏感任务上精度掉点明显的问题。QAT 的核心思想是把量化带来的舍入误差当作一种可学习的扰动,在反向传播中通过直通估计器(STE)等近似手段传播梯度,从而让模型参数自适应到对量化更鲁棒的区域。该方法在边缘端部署、端侧大模型与高并发推理场景中被广泛使用,是大模型「上端侧、压成本」的关键技术之一。
二、原理
1. 伪量化算子插入:在前向图中插入「量化—反量化」算子,模拟推理时的数值映射(round + clamp + scale + zero-point) → 2. 量化参数初始化:基于校准数据得到 per-tensor 或 per-channel 的 scale 与 zero-point,并冻结或参与训练更新 → 3. 直通估计(STE)反向传播:用 straight-through estimator 等近似手段绕过不可导的 round/clamp,保证梯度可回传 → 4. 联合微调:在 QAT 模式下对模型进行若干 epoch 微调,让权重自适应到对量化误差更鲁棒的区域 → 5. 训练调度与切换:通常先以浮点训练若干 epoch 收敛,再开启 QAT 模式联合微调 → 6. 导出与校准:将训练好的模型转换到目标推理后端的低精度算子,输出可部署的 INT8/INT4 权重
三、信息卡片
| 中文名 | 模型量化感知训练 |
| 英文名 | Quantization-Aware Training |
| 缩写 | QAT |
| 别名 | 量化感知训练、感知量化训练、QAT |
| 提出者 | 理论思想可追溯到 1990 年代神经网络压缩领域对二值化与定点训练的研究;工业奠基工作包括 TensorRT、PyTorch FX / PT2、TensorFlow Lite 的 QAT 实现 |
| 提出时间 | 20 世纪 90 年代概念萌芽;2018 年前后主流框架原生支持;2024 年伴随端侧 LLM 复兴 |
| 所属类别 | AI 技术 > 工程层 > 模型压缩与部署 |
| 核心技术 | 伪量化算子、直通估计器(STE)、per-channel 量化、QAT-微调、混合精度 |
| 主要应用 | 端侧大模型部署、边缘 AI、模型服务降本、INT4/INT8 推理精度保护 |
四、历史时间线
- 20 世纪 90 年代:神经网络压缩领域研究二值化与定点训练,QAT 思想萌芽
- 2010 年代中期:学术界系统化提出在训练图中插入伪量化节点的方法(如 BNN、XNOR-Net)
- 2018 年前后:TensorRT、TensorFlow Lite、PyTorch 等深度学习框架原生支持 QAT,使其从学术走向工业
- 2020-2022 年:伴随 Transformer 与小模型蒸馏的兴起,INT8 QAT 成为工业级推理的事实配置
- 2023-2024 年:端侧大模型与 INT4/INT3 量化加速演进,QAT 与 GPTQ、AWQ 等训练后量化方法并行发展
- 2025 年:QAT 与 LoRA、参数高效微调结合,成为「端侧 LLM 不掉点」的关键工具链
五、分类
- 按比特宽度:INT8 QAT、INT4 QAT、INT2/Binary QAT、混合精度 QAT
- 按粒度:per-tensor QAT、per-channel QAT、per-group QAT(与 GPTQ 类方法结合)
- 按训练阶段:完整训练阶段 QAT vs 微调阶段 QAT(QAT-Finetune)
- 按目标后端:GPU QAT(TensorRT、FP8)vs CPU/NPU QAT(ONNX、TFLite)vs 端侧 QAT(手机 / IoT)
- 按与训练后量化关系:纯 QAT vs QAT + PTQ 联合 vs QLoRA 式 QAT(量化底座 + LoRA 适配)
六、应用场景
- 端侧大模型部署:在手机、PC、IoT 上跑 INT4/INT8 量化的本地 LLM,兼顾内存与精度
- 边缘 AI 推理:工业摄像头、车载终端、低功耗 MCU 上的目标检测、语音唤醒模型量化
- 大模型服务降本:将线上服务模型从 FP16 量化到 INT8,单实例吞吐提升一倍以上
- 高并发在线推理:在 GPU 服务集群中以 INT8 提供与 FP16 接近的精度,但显存与时延大幅下降
- 联邦学习与隐私计算:在端云协同场景下做低比特模型传输,降低带宽与能耗
七、优缺点
- 优点:
- 精度保持好:在 INT8/INT4 量化下仍能保持接近浮点的精度,典型精度损失可控制在 1-3 个百分点以内
- 部署成本显著降低:模型体积与显存占用明显下降,推理时延与能耗可压缩到原先的几分之一
- 兼容性好:与主流推理后端(TensorRT、ONNX Runtime、TFLite)无缝对接,便于规模化上线
- 与微调天然结合:可在 LoRA / SFT 流程里直接打开 QAT 模式,新增能力不掉点
- 缺点:
- 训练成本不低:需要额外插入伪量化算子并进行若干 epoch 微调,显存与算力开销上升
- 对超参与数据敏感:学习率、校准集选择、QAT 开启时机不当会导致精度反降
- 实现复杂度高:需要框架支持 STE、量化参数管理与后端导出,工程门槛比 PTQ 高
- 极低比特仍掉点:在 INT2/1-bit 等极低比特场景,QAT 增益有限,需结合专用硬件与算法
八、常见误区
- QAT = PTQ(错:PTQ 在训练后做,QAT 在训练阶段插入伪量化,二者精度与流程差异显著)
- QAT 后模型还能反量化回 FP(错:QAT 后的权重是低精度张量,精度信息已经丢失,只能重新训练或微调)
- QAT 一定优于 PTQ(错:在数据充足、模型较大时 PTQ 也能达到很好效果,QAT 的额外成本不一定划算)
- QAT 可以随便选比特数(错:比特数与目标硬件算力、内存、能耗紧密耦合,需协同后端选择)
九、关联概念
- 父概念:模型量化、深度学习 Deep Learning、边缘计算(Edge Computing)
- 子概念:伪量化算子、直通估计器 STE、INT8/INT4 推理、LoRA微调、LLM 蒸馏
- 兄弟概念:训练后量化 PTQ、GPTQ / AWQ(PTQ 系列)、LLM 蒸馏、模型剪枝、知识蒸馏
- 对比概念:训练后量化 PTQ、模型剪枝、FP8 推理
- 应用相关:AI PC、端侧 LLM / 小语言模型、MLOps 机器学习运维、推理优化器(vLLM、TensorRT-LLM)

