一、先看结论:密度差不到一倍,但结构差异很大
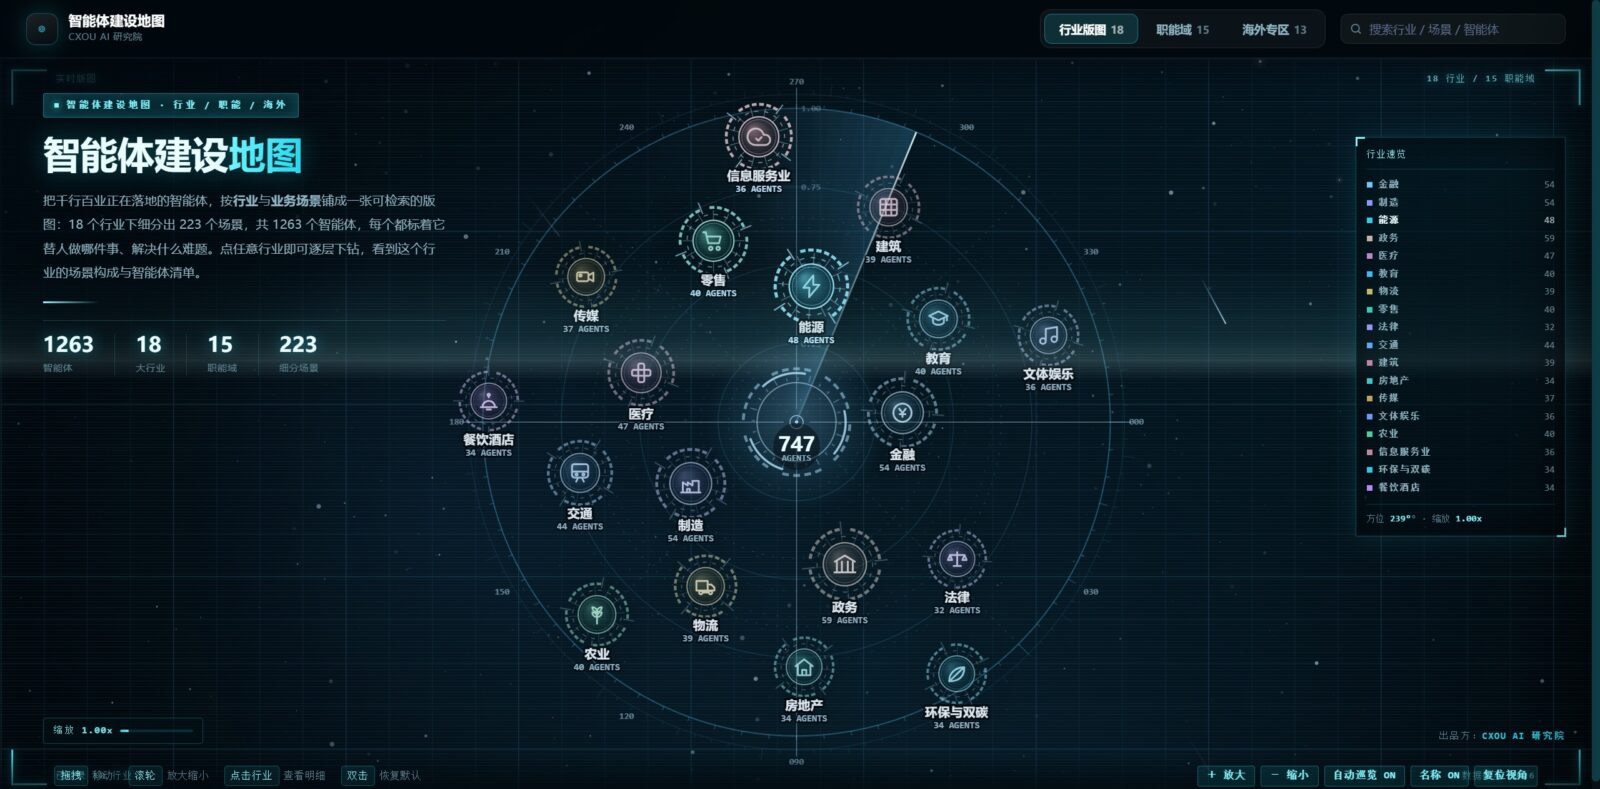
18 个行业共收录 747 个智能体条目,平均每行业约 41.5 个。最高的政务 59 个、最低的法律 32 个,相差 27 个、约 1.8 倍。差距不算悬殊,但梯队分明:
| 梯队 | 行业(收录数) | 特征 |
| 第一梯队(≥54) | 政务 59、金融 54、制造 54 | 流程标准化程度高、数据基础好 |
| 第二梯队(44–48) | 能源 48、医疗 47、交通 44 | 专业门槛高、强监管 |
| 第三梯队(39–40) | 教育 40、零售 40、农业 40、物流 39、建筑 39 | 场景分散、长尾多 |
| 第四梯队(≤37) | 传媒 37、文体娱乐 36、信息服务业 36、房地产 34、餐饮酒店 34、环保与双碳 34、法律 32 | 创意/服务密集、经验依赖重 |
变量一:流程能不能被拆成”可交接的一件事”
收录量靠前的行业,有一个共同点:大量工作能被拆成边界清晰的单件事。政务的”一网通办与政务服务””监管与执法””政策研究与决策支持”,金融的”银行/证券/保险/资产管理”,制造的”汽车与零部件””电子与半导体””装备与通用机械”——这些子行业里的工作,大多有明确输入、明确产出、明确规则。
能被拆成”一件事”,才能被交给一个智能体。 这是智能体密度第一位的决定因素。反过来,法律、餐饮酒店这类高度依赖临场判断和人际互动的行业,能被标准化的”单件事”相对少,收录数自然靠后。
变量二:数据是不是已经躺在系统里
第二梯队的能源、医疗、交通,专业门槛比政务、金融更高,却仍进入前列——原因是它们的数据基础扎实。能源的设备运行数据、医疗的诊疗与病历数据、交通的路网与调度数据,都是长期沉淀的结构化资产。智能体不是从零造数据,而是在已有数据上叠加一层”替人处理”的能力。
变量三:有没有明确的”出错代价”约束
强监管行业看似门槛高,实则给了智能体一个清晰的价值锚点:合规审查型、风险管控型、应急处置型智能体在金融、政务、能源里的密集出现,说明这些行业愿意为”减少人为疏漏”买单。当出错代价明确、且能被度量时,智能体的投入产出比就更容易算清。
二、一条反直觉的发现
收录量靠后的行业,不等于机会少。法律 32 个智能体里,包含法律检索、合同审查、案件辅助、立法辅助等高价值角色——数量少但单价高。对中小企业而言,与其扎进”智能体最多”的赛道做同质竞争,不如在后段行业里找”别人还没做透、但价值明确”的空位。
三、给决策者的一页速用
- 看自己行业的排名:处在第一梯队,说明路径成熟、可直接对标;处在后段,说明有机会做”第一个”。
- 看相邻行业:把相邻行业的智能体清单拿过来,逐条问”我们有没有同类问题”,跨行业复用往往比从零自建快。
- 别把密度当成熟度:收录数是”梳理得多细”的指标,不是”做得多好”的证明。落地效果仍需自己的数据验证。