一、大模型是什么?
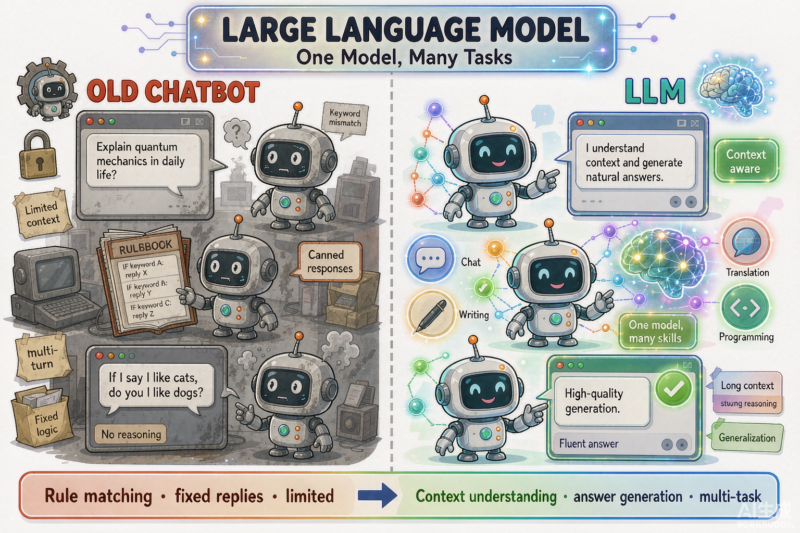
大语言模型(Large Language Model,LLM)是一类基于Transformer架构、通过海量文本数据预训练得到的超大规模深度学习模型,具备强大的语言理解、生成、推理与泛化能力。
二、大模型包含哪些模块?
· 预训练模块:通过自监督学习训练基础能力。
· 微调模块:通过监督学习适配特定任务。
· 提示工程模块:通过设计提示引导模型输出。
· 推理部署模块:将模型部署到生产环境。
· 安全对齐模块:通过RLHF等方法对齐人类价值观。
三、大模型的发展历程
大模型概念2017年随着Google发布Transformer架构奠定基础。2018年BERT、GPT-1相继发布。2020年GPT-3展现涌现能力。2022年ChatGPT引爆大模型热潮。当前多模态大模型与开源大模型快速发展。
四、大模型的作用和价值?
· 提升任务泛化能力:单一模型可处理多种任务。
· 降低应用开发成本:通过提示工程快速构建应用。
· 推动AI普惠:开放API让中小企业也能使用先进AI能力。
数智化转型网www.szhzxw.cn