一、什么是MoCo:动量对比学习
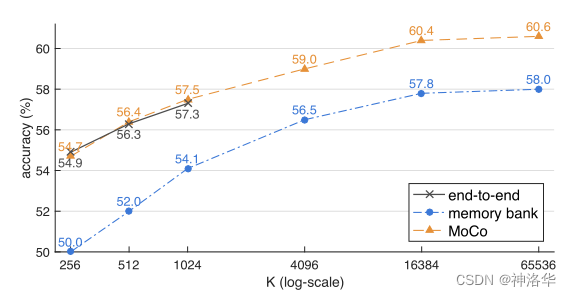
MoCo(Momentum Contrast,动量对比学习)是 Facebook AI Research(FAIR)何恺明团队于 2019 年提出的视觉自监督对比学习方法。其核心思想是把对比学习构建成一个「字典查询」问题:用一个大的、动态维护的队列作为负样本字典,并通过一个基于动量更新的编码器(momentum encoder)保证字典特征的一致性,从而在不需要大批量(large batch)训练的前提下,获得与有监督预训练可比的视觉表征。MoCo 的出现打破了对比学习对超大显存的依赖,是 SimCLR、BYOL、MoCo v2/v3 等后续自监督工作的奠基性方法之一,也是 He、Kaiming 等学者从有监督 ResNet 走向自监督预训练范式的代表作。
二、原理
1. 数据增强:对同一图像做两种随机增强(如随机裁剪、颜色抖动)得到 query 与 key 两路视图 → 2. 编码器:query 由 encoder_q 编码,key 由 encoder_k 编码,初始两者参数相同 → 3. 队列字典维护:把当前 batch 的 key 特征入队、把最早 batch 的 key 特征出队,形成容量巨大的负样本字典(典型 65536) → 4. 动量更新:encoder_k 的参数不由梯度回传更新,而由 encoder_q 按 m·θ_k + (1-m)·θ_q 缓慢滑动更新(m≈0.999) → 5. 对比损失:用 InfoNCE 损失把 query 与对应正样本 key 拉近、与队列中所有负样本 key 推远 → 6. 表征提取:训练完成后丢弃动量编码器与队列,保留 encoder_q 作为下游任务的视觉骨干网络
三、信息卡片
| 中文名 | 动量对比学习 |
| 英文名 | Momentum Contrast |
| 缩写 | MoCo |
| 别名 | 动量对比、动量对比学习、MoCo v1/v2/v3 |
| 提出者 | Facebook AI Research(FAIR)何恺明(Kaiming He)团队 |
| 提出时间 | 2019 年 11 月(arXiv:1911.05722) |
| 所属类别 | AI 技术 > 机器学习 > 自监督学习 > 对比学习 |
| 核心技术 | 对比损失 InfoNCE、队列式负样本字典、动量编码器、动量系数 m≈0.999 |
| 主要应用 | 视觉自监督预训练、目标检测迁移学习、少样本图像分类、视觉表征学习 |
四、历史时间线
2018-2019 年:InstDisc、CVRL 等早期工作探索「字典式对比学习」,但负样本一致性与规模难以兼顾
- 2019 年 11 月:何恺明等在 arXiv 发表 MoCo v1 论文《Momentum Contrast for Unsupervised Visual Representation Learning》,引入队列字典 + 动量编码器两大创新
- 2020 年初:MoCo 在 ImageNet 线性评估上首次超越有监督预训练的同期结果,引发业界广泛关注
- 2020 年 6 月:FAIR 发布 SimCLR-v2 同月,MoCo v2 论文发布,吸收 SimCLR 的 MLP 投影头与更强数据增强,把 ImageNet 准确率推至 67.5%
- 2021 年:MoCo v3 论文发布,把骨干网络换成 ViT 并探索自监督 ViT 训练的稳定性问题,奠定后续 MAE、BEiT 等视觉 Transformer 自监督工作的基础
- 2022-2025 年:MoCo 系列方法在目标检测(Detectron2)、语义分割、视频自监督等任务中被广泛用作预训练方案,影响力延伸至医疗影像、遥感等垂直领域
五、分类
按代际:MoCo v1(基础字典+动量)vs MoCo v2(加 MLP 投影头 + 强增强)vs MoCo v3(适配 ViT,移除字典)
- 按骨干网络:CNN 骨干(ResNet)vs ViT 骨干(MoCo v3 后的主流方向)
- 按对比目标:实例级对比(Instance-level)vs 上下文对比(Context-level)vs 多视图对比
- 按损失函数:InfoNCE 损失(主流)vs Soft-NCE、Decoupled Contrastive Learning(DCL)等变体
- 按下游任务:分类预训练、检测预训练(迁移到 Detectron2)、分割预训练、视频表征预训练
六、应用场景
视觉骨干自监督预训练:在 ImageNet 等无标注数据上预训练 ResNet / ViT,下游用于 ImageNet 分类、COCO 检测、Cityscapes 分割等任务
- 目标检测与实例分割:MoCo 预训练的 Backbone 被 Detectron2 官方集成,是早期「自监督 → 检测」的标准范式
- 少样本与跨域图像分类:在标注稀缺的医学影像、遥感、工业质检领域,MoCo 预训练显著提升少样本性能
- 视频自监督表征:衍生工作(如 MoCo-v2 视频扩展)用于动作识别、视频检索等任务
- AI 大模型视觉骨干:MoCo v3 是早期适配 ViT 的自监督方法之一,为后续 MAE、DINO 等视觉大模型预训练铺路
七、优缺点
- 优点:
- 解耦负样本规模与 batch size:队列字典使得对比学习可用较小 batch(256)训练,显存友好
- 动量编码器提升一致性:缓慢更新 key 编码器让负样本字典特征保持高度一致,对比信号更稳定
- 与下游任务兼容性强:预训练的 ResNet 可直接迁移到检测、分割、关键点等密集预测任务
- 可扩展到 ViT:MoCo v3 证明对比学习框架在 ViT 上依然有效,是连接 CNN 自监督与 Transformer 自监督的桥梁
- 缺点:
- 依赖大量负样本:在没有足够负样本的场景性能衰减明显,后期工作(BYOL、SimSiam)转向去除负样本
- 对数据增强敏感:颜色抖动、随机裁剪等增强策略需要精调,否则表征质量明显下降
- 动量系数难调:m 过高收敛慢、m 过低一致性弱,需要在训练中谨慎选择
- 训练稳定性挑战:迁移到 ViT(MoCo v3)时会出现训练崩溃问题,需要梯度截断、随机深度等额外技巧
八、常见误区
- MoCo 必须用队列(错:MoCo v3 已移除队列,说明队列是手段而非目的)
- MoCo 等于 SimCLR(错:二者范式不同——MoCo 用队列字典 + 动量编码器,SimCLR 用大批量端到端;后期 MoCo v2 借鉴了 SimCLR 的 MLP 投影头)
- 对比学习不需要负样本(错:MoCo 系列以负样本为核心;BYOL/SimSiam 才探索无负样本路径)
- 自监督预训练仅适合分类(错:MoCo 在检测、分割、关键点等密集预测任务上同样有效,甚至优于有监督预训练)
九、关联概念
父概念:自监督学习、Self-supervised Learning · 自监督学习、深度学习 Deep Learning
- 子概念:对比学习、向量检索、Embeddings、自监督学习
- 兄弟概念:对比学习、Self-supervised Learning · 自监督学习、深度学习 Deep Learning、计算机视觉 Computer Vision
- 对比概念:MoCo vs SimCLR、MoCo vs BYOL、MoCo vs MAE、MoCo vs 有监督预训练
- 应用相关:计算机视觉 Computer Vision、深度学习 Deep Learning、Self-supervised Learning · 自监督学习、对比学习

