一、什么是向量召回通道
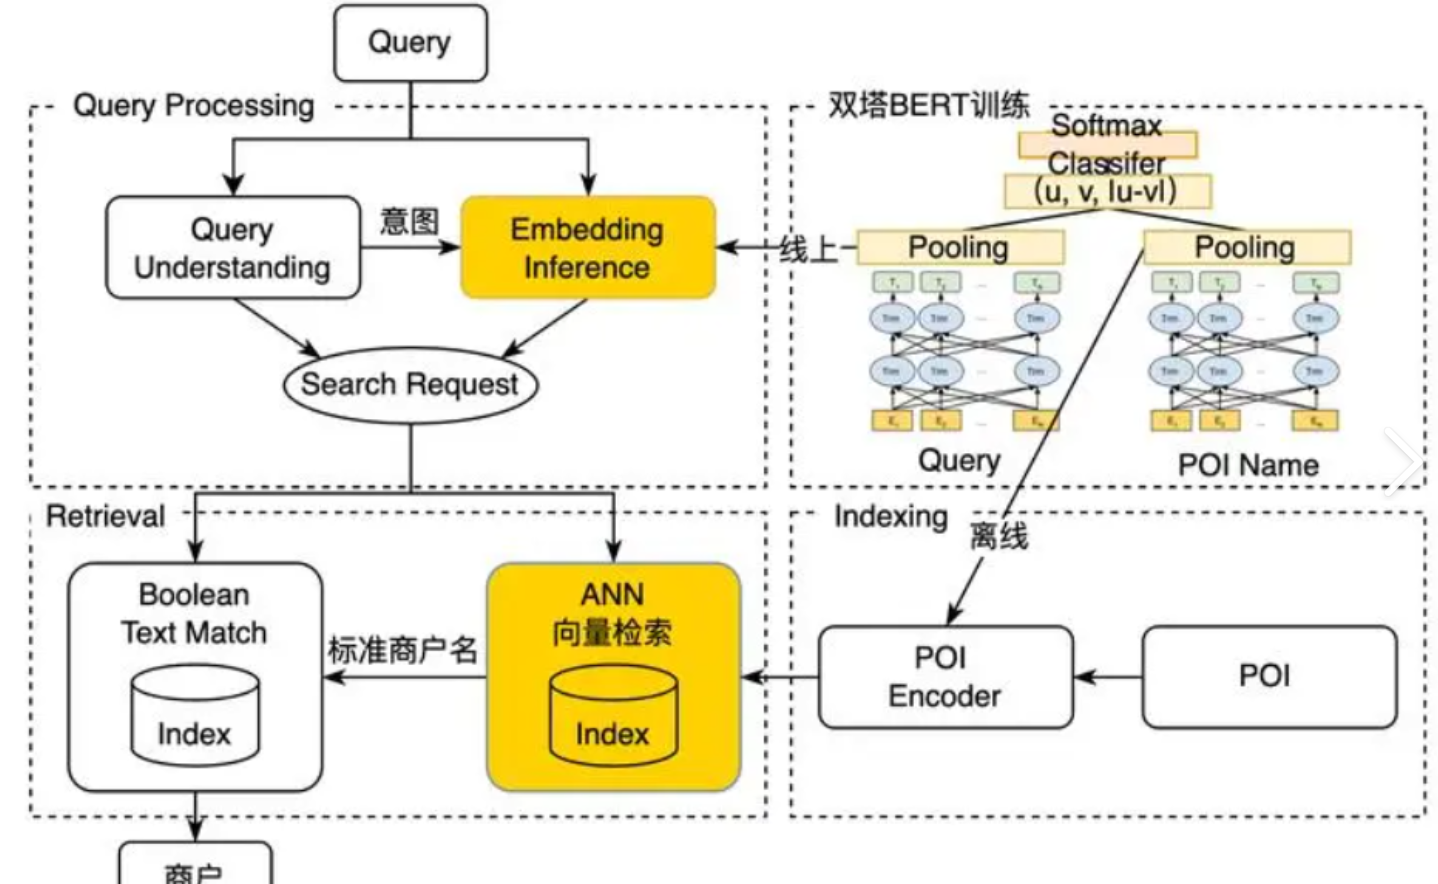
向量召回通道(Vector Recall Channel)是检索增强生成(RAG)与搜索引擎系统中负责按语义相似度从大规模文档库中筛取候选片段的关键通路,常被简称为「召回通道」或「向量通路」。它将文本经 Embedding 模型映射到高维向量空间后,通过近似最近邻(ANN)索引(如 HNSW、IVF-PQ)进行毫秒级检索,并以 Top-K 相似片段作为后续重排序与生成模型的输入。该通路解决了传统关键词检索对同义改写、跨语言与长尾术语召回率低的问题,是 RAG 系统在「检索精度—召回广度」之间取得平衡的核心组件。与之并列的概念还包括 BM25 等稀疏检索通道、混合检索(Hybrid)与重排通道(Reranker)。向量召回通道不是孤立的,而是一条由文本切片、向量化、索引构建、相似度计算与结果合并组成的完整链路。
二、原理
1. 文本切片:将原始文档按段落、语义或结构化边界切分为适合向量化的 Chunk,并保留元数据 → 2. 向量化:用 Embedding 模型将查询与文档切片映射到稠密向量空间,做归一化与截断 → 3. 向量索引构建:基于 ANN 算法(HNSW/IVF-PQ/SSAQ)构建可扩展索引,支撑亿级向量的亚秒级检索 → 4. 查询理解:对用户查询做改写、扩展或 HyDE 等增强,提升召回语义匹配度 → 5. 召回打分:计算余弦相似度或点积,结合元数据过滤与多向量加权得到候选得分 → 6. 结果合并与评估:在多通道架构中与 BM25 等稀疏通道融合,并用 Recall@K、命中率等指标监控漂移
三、信息卡片
| 中文名 | 向量召回通道 |
| 英文名 | Vector Recall Channel |
| 缩写 | VRC |
| 别名 | 向量召回、向量通路、Vector Retrieval Pipeline、ANN Recall |
| 提出者 | 思想源于信息检索向量空间模型;工业级奠基工作包括 Faiss(HNSW)、ScaNN、Pinecone 等向量索引与 RAG 实践 |
| 提出时间 | 向量空间模型可追溯到 20 世纪 70-90 年代;ANN 索引成熟于 2010 年代;RAG 时代的向量召回通道在 2020 年后规模化落地 |
| 所属类别 | AI 技术 > 工程层 > RAG 检索基础设施 |
| 核心技术 | Embedding 模型、ANN 索引(HNSW/IVF-PQ/SSAQ)、多向量召回、混合检索 |
| 主要应用 | 企业 RAG 检索、AI 搜索、文档问答、推荐系统冷启动召回 |
四、历史时间线
20 世纪 70-90 年代:向量空间模型(VSM)首次把文档表示为向量,提出基于 TF-IDF 加权的相似度检索
- 2010 年代前后:深度表示学习兴起,Word2Vec、GloVe 等让语义向量具备语义表达能力
- 2017 年:Transformer 架构出现,预训练语言模型显著提升句子级 Embedding 质量
- 2017-2018 年:Faiss、HNSW 等高效 ANN 索引库开源,向量召回开始走入工业搜索与推荐
- 2020-2022 年:BERT、Sentence-BERT、E5、BGE 等专用 Embedding 模型使 RAG 与企业搜索广泛采纳向量召回
- 2023-2024 年:向量数据库(Pinecone、Milvus、Weaviate、Qdrant)成为独立基础设施层,与传统数据库并列
- 2024-2025 年:多向量召回、混合检索(BM25 + 向量)、Late Interaction(ColBERT)成为提升召回质量的标准实践
五、分类
按索引算法:HNSW(图基)vs IVF-PQ(量化基)vs ScaNN(异构计算)vs DiskANN(外存)
- 按检索模式:单向量召回 vs 多向量召回(ColBERT 式)vs 后期交互
- 按通道组合:纯向量通道 vs BM25 + 向量混合通道 vs 向量 + 重排序两阶段
- 按 Embedding 来源:通用 Embedding(BGE、E5、OpenAI text-embedding)vs 领域微调 Embedding vs 多模态 Embedding
- 按查询增强:无增强召回 vs 查询改写召回 vs HyDE(假设文档嵌入)召回 vs 多查询融合
六、应用场景
- RAG 系统的检索层:为 LLM 提供 Top-K 相关文档块,是企业知识库问答的事实核心
- AI 搜索引擎:Perplexity、Bing Chat、秘塔等通过向量召回结合实时网页检索提供带引用的回答
- 推荐系统冷启动召回:在缺乏用户行为时通过内容向量匹配解决新物品的召回问题
- 代码与 API 检索:把代码片段向量化,支持语义级代码搜索与 API 推荐
- 多模态跨模态检索:在 CLIP / 多模态 Embedding 驱动下用文本搜图、图文互搜
- 法律/医疗等专业检索:在长文档高密度专业术语场景下,向量召回显著优于纯关键词检索
七、优缺点
- 优点:
- 语义召回能力强:显著提升同义改写、跨语言与长尾问题的命中比例,典型召回提升幅度可达两位数百分比
- 响应时延可控:通过 ANN 索引把单次检索控制在百毫秒级,适配在线问答与对话系统的时延预算
- 构建成本下降:免去大量人工维护同义词词表与规则的成本,缩短新领域冷启动周期
- 天然支持多模态:多模态 Embedding 模型让图像、音频、文本可统一在同一向量空间检索
- 缺点:
- 对 Embedding 模型敏感:召回质量高度依赖 Embedding 模型在目标领域的表现,领域不适配时掉点明显
- Chunk 切分难题:切分粒度过粗导致命中内容噪声大,过细则破坏语义,技术上难以自动化最优
- 索引维护复杂:文档更新、删除与版本回滚对 ANN 索引一致性与性能有显著影响
- 结果可解释性弱:纯向量距离难以解释为何相似,需要与稀疏通道与重排序交叉验证
八、常见误区
向量召回 = 向量数据库(错:向量数据库是基础设施,向量召回是包含切片、向量化、索引、检索、合并的整条链路)
- 向量召回可以完全替代关键词检索(错:在专有名词、代码标识符场景 BM25 等稀疏检索往往仍占优,混合通道是主流)
- 召回 Top-K 越大越好(错:超大 Top-K 会引入噪声与上下文超限,需配合重排序与上下文压缩)
- Embedding 模型越大越好(错:Embedding 维度与模型规模与领域数据高度相关,过大反而可能过拟合或拖慢推理)
九、关联概念
- 父概念:RAG · 检索增强生成、向量检索、Embeddings
- 子概念:向量索引、向量数据库(Vector DB / Milvus / Pinecone 等)、Embedding 模型、BM25 稀疏检索、Reranker 重排序
- 兄弟概念:RAG · 检索增强生成、GraphRAG、Self-RAG、向量检索、Embeddings
- 对比概念:BM25 稀疏检索、GraphRAG(图结构检索)、全文检索
- 应用相关:RAG · 检索增强生成、GraphRAG、RAG 评测、RAGAS、企业知识库与智能客服

