一、什么是AI Agent 性能基准
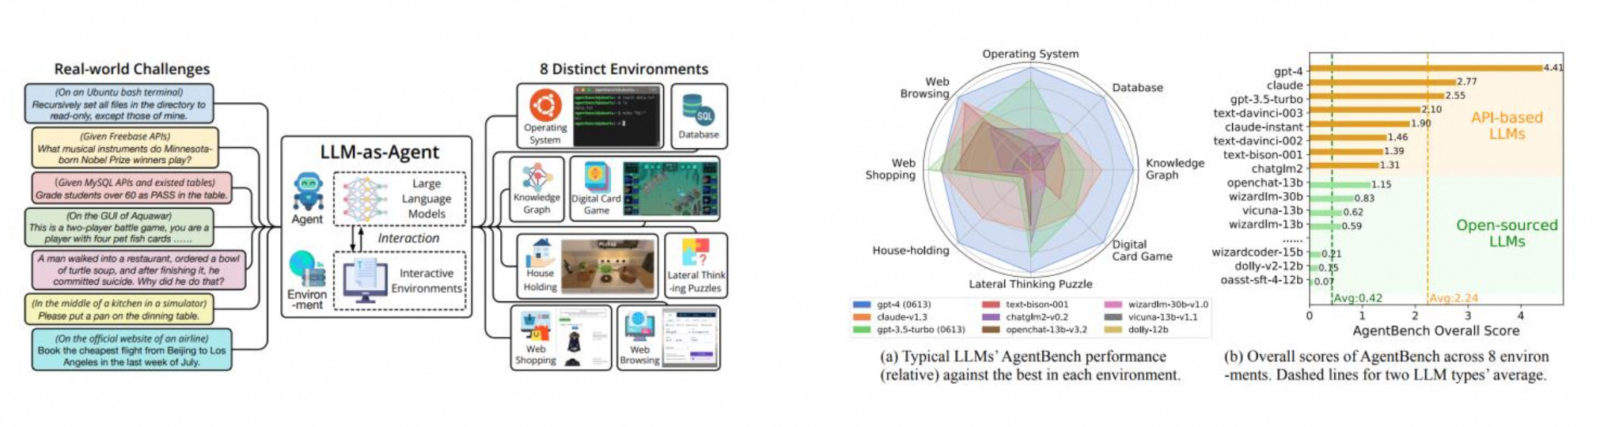
AI Agent 性能基准(AI Agent Benchmark)是一套在受控环境中对智能体(Agent)的规划、工具调用、记忆与多步决策能力进行标准化打分的评测体系,通常由任务集、仿真环境、评分函数与排行榜组成。它与传统的 NLP 基准不同,更强调长程任务、跨工具协作与失败恢复能力,关注智能体是否能在真实工作流中「把事情办成」。基准通常划分为通用网页/操作系统操作、软件工程、信息检索与垂直行业任务等类型,配套提供成功率、回合数、Token 消耗、人类一致性等指标。其目标是让不同 Agent 框架在不同模型底座上可被横向比较,推动工程实践迭代与企业选型决策。
二、原理
1. 任务集设计:定义可重复执行的多步任务,覆盖网页、代码、文件、API 等异构环境,每个任务带明确成功标准 → 2. 仿真环境构建:提供沙箱化的操作系统、浏览器或软件栈,隔离真实副作用,保证评测可重复 → 3. Agent 部署与执行:在统一接口下让 Agent 调用工具与多步决策,收集完整轨迹(trajectory) → 4. 评分函数:综合成功率、回合数、Token/时间成本,给出可比较的复合分(带置信区间) → 5. 排行榜与防作弊:统一提交格式、随机种子与防作弊机制,防止训练集污染与提示工程作弊 → 6. 诊断与归因:对失败轨迹进行归因(规划错?工具错?记忆缺失?),输出可解释的改进建议
三、信息卡片
| 中文名 | AI Agent 性能基准 |
| 英文名 | AI Agent Benchmark |
| 缩写 | Agent Benchmark / ABE |
| 别名 | 智能体基准、Agent 评测、Agent Eval、Agent 评测基准 |
| 提出者 | 面向 LLM Agent 的代表性基准包括 SWE-bench、GAIA、WebArena、AgentBench、MLE-bench、τ-bench 等;学界与工业界联合推动 |
| 提出时间 | 2023 年起伴随 LLM Agent 爆发出现;2024-2025 年进入大规模刷榜与季度更新阶段 |
| 所属类别 | AI 技术 > 评测层 > Agent 评测 |
| 核心技术 | 任务集设计、仿真环境(沙箱 OS / 浏览器)、评分函数、轨迹归因、防作弊机制 |
| 主要应用 | Agent 框架选型、模型底座能力对比、Agent 能力回归测试、行业评测 |
四、历史时间线
- 强化学习时代:Atari、MuJoCo、棋类基准成为决策类任务的经典评测方式
- 2023 年:随着 LLM Agent 兴起,社区开始设计专门评测网页操作、软件工程与多步推理的基准(WebArena、AgentBench)
- 2024 年:SWE-bench(软件工程)、GAIA(通用助手)、MLE-bench(机器学习工程)等垂直基准涌现,并形成季度刷榜生态
- 2024 年底:τ-bench、ToolBench 等聚焦「真实业务对话 + 工具调用」的企业级基准出现
- 2025 年:引入人类专家轨迹、成本约束与对抗样本,基准开始贴近生产环境真实负载
五、分类
按任务类型:通用助手基准(GAIA)vs 软件工程(SWE-bench)vs 网页/操作系统操作(WebArena)vs ML 工程(MLE-bench)vs 行业任务基准
- 按评分方式:二元成功/失败 vs 多维复合分 vs LLM-as-Judge 与人类评审结合
- 按环境真实度:纯文本环境 vs 仿真 UI/浏览器 vs 真实 SaaS API 接口
- 按时间预算:无时间预算 vs 限定步数与 Token vs 限定成本($)
- 按评测协议:静态提交(一次性跑)vs 动态排行榜 vs 自部署回归测试
六、应用场景
Agent 框架选型:在 LangChain、AutoGen、CrewAI、自研框架之间做横向对比,辅助技术选型
- 模型底座能力对比:同一框架下不同模型(GPT-4o、Claude、Gemini、Qwen、DeepSeek)的 Agent 能力排名
- CI/CD 回归测试:Agent 升级或 Prompt 调整后可自动捕获能力退化,作为发布门禁
- 瓶颈定位:通过细粒度指标(规划、工具、记忆)识别 Agent 系统中的具体短板
- 行业评测与企业采购辅助:金融、客服等行业用 Agent 基准评估供应商能力
- 学术研究对照:作为论文中报告的标准化指标,让不同工作可比
七、优缺点
- 优点:
- 横向可比:为不同框架与模型底座提供同一把尺子,避免单一指标误导决策
- 回归保障:作为 CI/CD 一环,Agent 升级或 Prompt 调整后可自动捕获能力退化
- 瓶颈定位:细粒度指标帮助团队识别规划、工具或记忆中的具体短板
- 推动工程迭代:排行榜的公开竞争显著加速框架与模型在 Agent 场景的能力提升
- 辅助采购决策:为非技术决策者提供可视化、可对比的客观数据
- 缺点:
- 测试集污染风险:任务可能进入训练集,使分数虚高,需引入动态题库与防作弊
- 环境真实性有限:仿真浏览器/SaaS 仍难完全模拟真实业务路径,结果与生产差距存在
- 评测成本高昂:复杂任务动辄需要数十到数百 Token,百万级评测单次成本可达数千到上万美元
- 过度优化刷榜:研发会针对基准做提示工程与过拟合,泛化到真实业务未必提升
- 评分主观性:LLM-as-Judge 引入评委模型偏见,需要与人类评审交叉校验
八、常见误区
Agent 基准 = NLP 基准(错:Agent 基准强调多步决策、工具调用与长程任务,与 NLP 基准测试粒度不同)
- 基准高分数 = 真实可用(错:基准是受控环境,与企业真实负载有差距,必须做场景化验证)
- 基准可完全自动化(错:复杂任务的评分仍依赖人类评审与 LLM-as-Judge 交叉)
- Agent 基准只看成功率(错:回合数、Token 成本、人类一致性等同样关键,单一指标易误导)
九、关联概念
- 父概念:AI智能体 AI Agent、RAG 评测、RAGAS
- 子概念:LLM-as-Judge、SWE-bench / WebArena、轨迹归因分析、回归测试 / CI/CD
- 兄弟概念:RAG 评测、检索增强生成评估 RAGAS、Agent 工具市场、AI 红队、AI安全
- 对比概念:NLP 基准(MMLU、GSM8K、HumanEval)、传统软件功能测试、红蓝对抗
- 应用相关:AI智能体 AI Agent、AI 网关、AI Workflow、推理优化器、MCP · 模型上下文协议

