一、开篇:AI 不止 ChatGPT
很多人对 AI 的印象从 2022 年 11 月 ChatGPT 发布开始算起。但事实上,作为一门学科的人工智能(Artificial Intelligence)早在 1956 年的达特茅斯会议上就被正式命名,至今已有 70 年历史。这 70 年里,AI 经历过三次”冬天”——政府和资本因为看不到短期回报而撤资;也经历过三次”夏天”——新技术突破带来全民狂热。理解这段历史,比记住任何一个模型的名字更重要。
下文按时间顺序,把这 70 年切成 六个浪潮。
二、第一浪潮(1950s – 1970s)诞生与黄金期:「机器能不能思考」
2.1 图灵测试(1950)
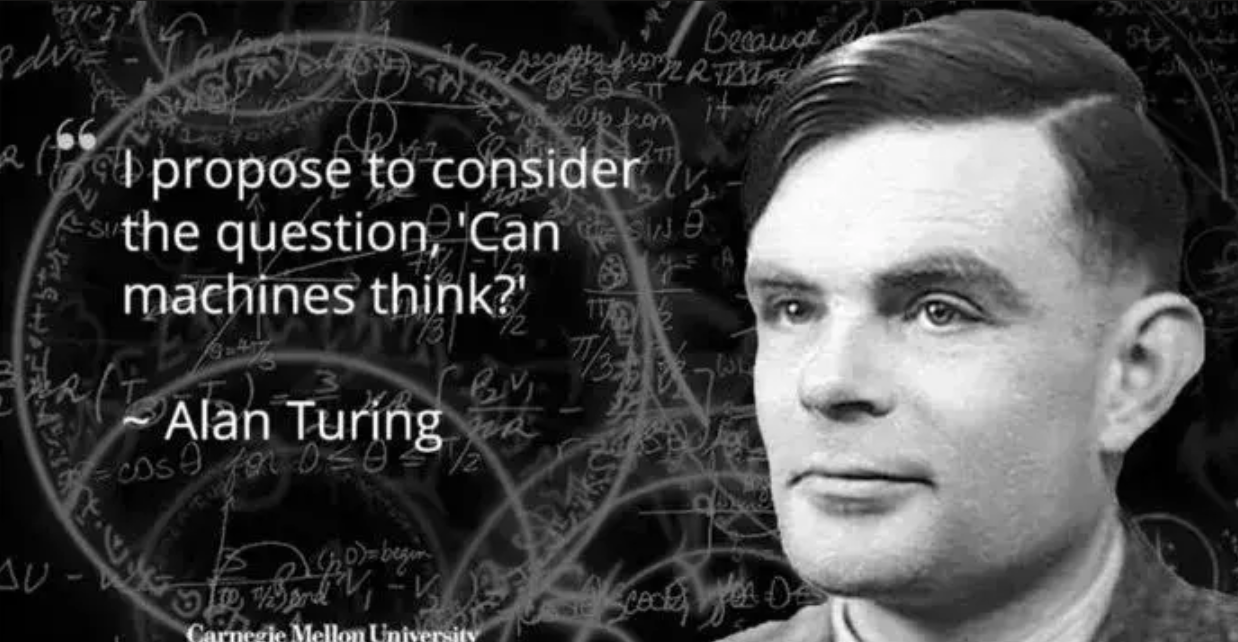
1950 年,英国数学家 阿兰·图灵(Alan Turing) 在论文《计算机器与智能》(Computing Machinery and Intelligence)中提出一个思想实验:如果一台机器能在对话中让人类无法分辨对方是人还是机器,那这台机器就可以被认为是”会思考的”。这就是著名的 图灵测试(Turing Test),也是 AI 哲学层面的原点问题——”Can machines think?”
图灵当时没有计算机能真正实现这个测试,但他提出的”模仿游戏”为后来所有 AI 研究者确立了一个可操作的目标。
2.2 达特茅斯会议与”AI”得名(1956)
1956 年夏天,达特茅斯学院数学教授 约翰·麦卡锡(John McCarthy) 邀请了马文·明斯基(Marvin Minsky)、克劳德·香农(Claude Shannon)、赫伯特·西蒙(Herbert Simon)等十位学者,进行了长达两个月的研讨会。这次会议的核心论点是:“学习的每一个方面或智能的任何其他特征原则上都可以被如此精确地描述,以至于可以制造一台机器来模拟它。”
会议中,麦卡锡首次创造了”Artificial Intelligence(人工智能)“一词。这个词从此成为这门学科的正式名称,这一年也被公认为 AI 学科的诞生元年。
2.3 ELIZA 与第一次”以为机器是人”
1966 年,MIT 计算机科学家 约瑟夫·魏泽鲍姆(Joseph Weizenbaum) 创造了 ELIZA——公认的第一个聊天机器人。ELIZA 实际上只做了一件事:把用户输入的句子改写成问句。但即便是这种简单的”罗杰斯式心理治疗话术”,也让很多用户坚信自己在和真人对话。魏泽鲍姆后来写道:”有些测试者非常难以相信 ELIZA……不是人类。”
ELIZA 的启示意义在于:人类天然倾向于赋予对话方”人格”,这一现象在 50 年后的大模型时代再次重演。
2.4 第一次寒冬的种子(1970s 末)
1956 年后的 20 年里,政府(主要是美国国防部高级研究计划局 DARPA)和大学投入了大量资金研究 AI,研究者做出了 LISP 语言、感知机(Perceptron)、Shakey 机器人等成果。但因为算力不够、数据不够、算法也不够,AI 始终只能解决”玩具级”问题。1973 年英国卢瑟福报告(Lighthill Report)和 DARPA 削减经费让 AI 陷入 第一次寒冬,学术界开始反思符号主义路线的局限。
三、第二浪潮(1980s)专家系统:知识工程的短暂春天
3.1 专家系统兴起
1980 年代,AI 转向专家系统(Expert System)——把人类专家的知识编码成”if-then”规则,让机器在特定领域(如医疗诊断、化学分析)模仿专家决策。代表性系统包括 XCON(帮 DEC 公司配置计算机订单)、MYCIN(诊断细菌感染)。
专家系统一度被认为能”商用落地”——这是 AI 历史上第一次商业化尝试。1980 年代美国 AI 产业规模从几百万美元增长到数十亿美元。
3.2 泡沫破裂与第二次寒冬
但专家系统有三个致命问题:(1)知识获取靠人工录入,成本极高;(2)系统僵化,遇到规则外的情况就崩;(3)维护困难,规则库会越来越大、相互冲突。1980 年代末,企业开始大规模撤回投资,AI 行业再次跌入寒冬。
但这次寒冬中,反向传播算法(Backpropagation)在 1986 年被 Rumelhart、Hinton、Williams 重新推广——为后来深度学习的复兴埋下了种子。
四、第三浪潮(1990s – 2000s)统计学习复兴
4.1 从规则到概率
1990 年代,AI 研究者意识到,与其手写规则,不如让机器从数据中自动学规律。这带来三个标志性突破:
- 支持向量机(SVM,1995):Vapnik 和 Cortes 提出的分类算法,成为 1990s–2000s 的主流模型。
- 朴素贝叶斯、决策树、随机森林:在文本分类、垃圾邮件过滤等任务上击败了规则系统。
- IBM 深蓝击败卡斯帕罗夫(1997):深蓝是规则+搜索+硬件特化系统的巅峰,证明了暴力计算+领域知识可以战胜人类世界冠军。
- 4.2 第三次寒冬(2000s 早期)
但 2000 年代初,AI 再次面临”主流机器学习算法无法处理高维感知数据(图像、语音、视频)”的困境。DARPA 在 2004–2007 年大幅削减 AI 经费,SVM 等”浅层方法”在语音识别、图像识别上的天花板肉眼可见。
这一时期 AI 在公众视野几乎消失——但真正改变格局的力量正在学术界悄悄酝酿。
五、第四浪潮(2010s)深度学习崛起:从 ImageNet 到 AlphaGo
5.1 深度学习三巨头(2006)
2006 年,杰弗里·辛顿(Geoffrey Hinton) 发表《A Fast Learning Algorithm for Deep Belief Nets》,提出”深度信念网络”可以通过逐层预训练有效学习——这是“深度学习”这个术语正式走向台面的起点。辛顿与杨立昆(Yann LeCun)、约书亚·本吉奥(Yoshua Bengio)并称为”深度学习三巨头”,三人共同获得 2018 年图灵奖。
5.2 ImageNet 与 AlexNet(2012)
转折点是 2012 年的 ImageNet 大规模视觉识别挑战赛(ILSVRC)。辛顿团队的学生 亚历克斯·克里泽夫斯基(Alex Krizhevsky) 用深度卷积神经网络 AlexNet(8 层、6 千万参数、GPU 训练)将图像分类错误率从 26% 降到 15.3%——比第二名低 10.8 个百分点,震惊整个计算机视觉界。
AlexNet 证明了三件事:(1)深层的神经网络有效;(2)GPU 算力让训练成为可能;(3)大规模标注数据(ImageNet 120 万张图)是关键燃料。从此深度学习成为 AI 主流范式。
5.3 AlphaGo 与公众认知拐点(2016)
2016 年 3 月,Google DeepMind 研发的 AlphaGo 以 4:1 击败韩国围棋世界冠军李世石。围棋被认为是”AI 最后无法攻克的智力游戏”——因为棋盘状态数比宇宙原子数还多,纯暴力搜索不可行。AlphaGo 用 深度神经网络 + 蒙特卡洛树搜索 + 自我对弈强化学习 三者结合,第一次让公众真切感受到:AI 已经能在复杂智力任务上超越人类顶尖选手。
AlphaGo 之后,”人工智能”四个字首次进入中国普通民众的视野——此前 AI 只是学术圈的概念,此后才成为大众话题。
六、第五浪潮(2017 – 2022)Transformer 革命:大模型时代开启
6.1 Attention Is All You Need(2017)
2017 年,Google 团队发表了划时代论文 《Attention Is All You Need》,提出了 Transformer 架构——抛弃了 RNN 的循环结构,完全基于”注意力机制(Attention)”做序列建模。Transformer 让训练可以大规模并行化,模型可以”吃得下”前所未有的大数据。
到今天,几乎所有主流大模型(GPT、LLaMA、Claude、Gemini、DeepSeek、Qwen)的基础架构都是 Transformer。
6.2 GPT 家族的指数增长(2018 – 2020)
OpenAI 沿着 Transformer 路线推出了 GPT 系列:
| 模型 | 年份 | 参数量 | 关键能力 |
|---|---|---|---|
| GPT-1 | 2018 | 1.17 亿 | 首次证明生成式预训练可行 |
| GPT-2 | 2019 | 15 亿 | 能写连贯文章,OpenAI 担心滥用最初未开源 |
| GPT-3 | 2020 | 1750 亿 | few-shot 学习,无需微调就能完成多种任务 |
| GPT-3.5 / ChatGPT | 2022.11 | 未公开 | 对话式 RLHF,5 天破百万用户、2 个月破亿 |
2022 年 11 月 30 日 ChatGPT 上线,是 AI 历史上最关键的公众认知拐点——它把 AI 从”学术圈/科技圈话题”变成了”全民话题”。”Prompt 工程师”、”用 AI 写作业”、”AI 取代论”等社会议题全部起源于此。
6.3 GPT-4 与多模态(2023)
2023 年 3 月,OpenAI 发布 GPT-4——首次支持图像输入的多模态大模型,在多项人类考试(律师资格考试、GRE、SAT)上达到或超过人类水平。同年,Anthropic 的 Claude、Google 的 Gemini、Meta 的 LLaMA 先后发布,全球大模型竞赛正式开打。
七、第六浪潮(2023 – 2026)生成式 AI + Agent 时代
6.4 多模态生成:从文字到视频
2024 年,OpenAI Sora 发布——首次实现”用文字直接生成 60 秒连贯视频”。紧接着 Runway、Pika、字节豆包视频、阿里通义万相、快手可灵等国内外模型把视频生成推向可用水平。图像(DALL·E、Midjourney、Stable Diffusion)、音频(Suno、ElevenLabs)、代码(GitHub Copilot、Cursor)、3D(Meshy) 全部进入生成式 AI 时代。
6.5 AI Agent:从对话到行动
2024–2025 年,AI 从”回答问题”走向主动完成任务——AI Agent(智能体) 成为新主题。Agent 能调用工具、写代码、操作浏览器、订外卖、订机票、做研究。代表性产品包括:
- Devin(Cognition AI,2024.3)——号称”首个 AI 软件工程师”
- AutoGPT / BabyAGI(2023)——开源 Agent 早期实验
- Claude Computer Use(Anthropic,2024.10)——AI 直接操控桌面
- Manus(中国团队,2025)——通用 Agent 产品
- 6.6 开源 + 国产大模型爆发(2024 – 2026)
2024–2026 年,AI 不再是 OpenAI 一家独大。开源模型(Meta LLaMA、Mistral、Qwen、DeepSeek)能力快速逼近闭源模型,推理成本断崖式下降。中国形成”字节豆包、阿里通义、百度文心、腾讯混元、智谱 GLM、DeepSeek、月之暗面 Kimi”七雄格局,国产模型在国际榜单上开始与 GPT、Claude、Gemini 同台竞技。
2025–2026 年,大模型价格战打响——DeepSeek、豆包、通义千问先后大幅降价 API 价格,单 token 推理成本相比 2023 年下降超过 100 倍,AI 应用进入”普惠阶段”。
八、结语:下个 70 年看什么
回顾 1950–2026 这 70 年,AI 的发展有一条清晰的逻辑:
1. 算法(图灵→符号→统计→深度学习→Transformer)
2. 算力(CPU→GPU→TPU→万卡集群)
3. 数据(手工标注→互联网文本→全网多模态)
这三者同步指数增长时,AI 就突破;任何一项掉队,AI 就进入寒冬。
今天我们正处在第六浪潮的起点。接下来的 5–10 年,决定 AI 走向的将是三个问题:
- 能不能可靠?——大模型”幻觉”问题能否解决
- 能不能落地?——Agent 能否在真实业务中替代人工
- 能不能对齐?——AI 与人类价值观、伦理、监管如何协调
70 年前图灵问”Can machines think?”——今天这个问题已经过时。新的问题是:“我们将与 AI 共同做出什么样的决定?