一、开篇:图灵没写完的考卷
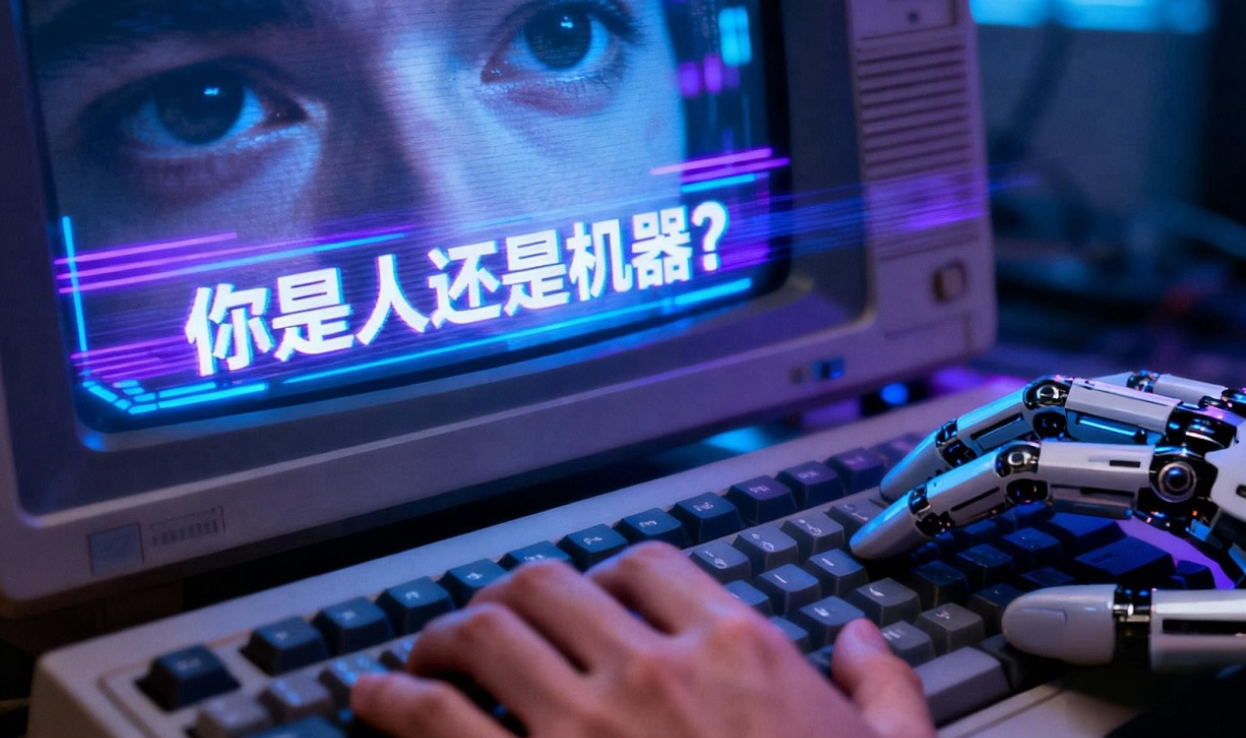
1950 年 10 月,图灵在哲学期刊《Mind》上发表《计算机器与智能》(Computing Machinery and Intelligence)一文,提出的第一个问题是:”Can machines think?”
这个问题太大了,图灵自己也无法给出确切的判定标准——所以他换了一种问法:如果一台机器能在 5 分钟的文字对话中,让 30% 的裁判无法分辨对方是人还是机器,那它就可以算作”会思考”。这就是模仿游戏(Imitation Game),俗称图灵测试(Turing Test)。75 年后,AI 早就能在多数场景里”通过”图灵测试——但没人再用它。原因不是它太简单,而是它根本没法衡量智能。
二、1970s–1990s:图灵测试第一次落地尝试
2.1 ELIZA 让所有人”上当”
1966 年 ELIZA(Joseph Weizenbaum)发布后不久,图灵的模仿游戏就部分实现了——只是没人能严格控制”5 分钟””30% 裁判”这些边界条件。魏泽鲍姆的秘书甚至要求他出去,”因为她在和 ELIZA 聊私事”。
2.2 PARRY(1972)—— 第一个模拟”精神疾病患者”的 chatbot
精神病学家 Kenneth Colby 创造了 PARRY——模拟偏执型精神分裂症患者的对话系统。1971 年 PARRY 与人类心理医生通过 ARPANET 进行了首次人机对话实验——结果令人不安:52% 的心理医生没有分辨出对方是机器。
2.3 Loebner Prize —— 把模仿游戏变成比赛
1991 年,慈善家 Hugh Loebner 设立Loebner Prize(勒布纳奖),每年举办一次图灵测试竞赛,奖金 10 万美元(最终大奖:机器在文本对话中通过 30% 裁判)+ 2000 美元年度最佳 chatbot 奖。
讽刺的是:Loebner Prize 跑了几十年,没有一个参赛者接近最终大奖——AI 始终没能通过严格图灵测试。
三、2014 – Eugene Goostman:图灵测试”第一次通过”?
2014 年 6 月 7 日,俄罗斯团队研发的 Eugene Goostman(一个 13 岁乌克兰男孩 chatbot)在伦敦皇家学会的图灵测试 100 周年纪念活动上,让 33% 的裁判相信它是真人——刚好越过 30% 门槛。
但几乎所有 AI 学者都拒绝承认这个结果:
1. 角色设置太取巧——13 岁乌克兰男孩,英语不是母语,刻意让”语法错误”合理化;
2. 测试时长过短——只有 5 分钟对话;
3. 样本选择有偏——裁判都是非英语母语者,对英文对话本来就不敏感;
4. 没有对话上下文——不能重复测试同一对话。
深度学习三巨头之一 Yann LeCun 直接评价:”图灵测试被 Eugene Goostman 这种’扮演角色 + 取巧’的方式破坏了——它不再是智能的衡量标准。”
四、后图灵时代:基准评测大爆炸(2018 – 至今)
Eugene Goostman 之后,AI 界达成共识:图灵测试太主观、不稳定,需要可重复、可量化的”考试”。
4.1 早期基准(2018 – 2020)
| 年份 | 基准 | 评测什么 |
|---|---|---|
| 2018 | GLUE / SuperGLUE | 自然语言理解 |
| 2018 | SQuAD 2.0 | 阅读理解 |
| 2019 | HellaSwag | 常识推理 |
| 2020 | MMLU | 57 个学科知识(小学到专业) |
| 2021 | HumanEval | 代码能力(LeetCode 风格) |
4.2 进阶基准(2023 – 至今)
- GPQA(2023)——”Google-Proof Q&A”,博士级科学问答,Google 搜索也答不上来;
- MATH(2021)——竞赛级数学题;
- ARC-AGI(François Chollet,2024)——衡量”流体智力”,被认为是最接近”通用智能”的基准,GPT-4 起步只能答 0%;
- SWE-bench(2024)——直接评估 AI 修复真实 GitHub issue 的能力;
- AIME / FrontierMath(2024 – 2025)——奥数与前沿数学。
- 4.3 评测范式变化:从选择题到 Agent 实操
2024 年开始,AI 评测从”答题”转向”做事”:
- GAIA(Meta,2024)——AI 助手完成真实研究任务;
- WebArena(CMU,2023)——AI 在真实网站上操作(订餐、填表);
- OSWorld(2024)——AI 操作 Windows / Linux 桌面;
- HLE(Humanity’s Last Exam,2025)——3000 多名学者集体出题,被设计成”AI 永远答不出来”的硬基准,2025 年初 GPT-4 答对率仅 3%。
五、结语:图灵问题的真正答案
回到 1950 年图灵的原始问题——”Can machines think?”——75 年后我们才看清:图灵测试没能回答”机器能不能思考”,但它成功催生了”机器能不能假装不思考”这一新问题。
2024 年 Anthropic 的研究发现:Claude 3 Opus 在被告知”你正在参加图灵测试”时,反而表现更差——它会因为”过度思考”而暴露机器痕迹。研究者说:”LLM 在模仿游戏里可以赢,但不能刻意赢。”这或许是对图灵最好的回答——机器确实可以思考了,但思考的方式和人类不一样。我们不再需要”能不能假装是人”这种测试,我们需要的是”能不能像机器一样把事情做好”。
下一个 75 年,AI 评测会从”答题”走向”做事”,从”考试”走向”实习”。图灵在 1950 年画出的”模仿游戏”考卷,到今天才真正被填完——而答题的方式,连图灵自己也没想到。