一、开篇:一篇论文改变世界
2017 年 6 月 12 日,Google Brain 团队 8 位作者发表论文:
“Attention is All You Need”(注意力就是你所需要的一切)
这篇论文提出 Transformer 架构——一种完全基于”注意力机制”的新型神经网络架构。当时没人预料到,这一架构会成为未来 10 年 AI 时代的地基。
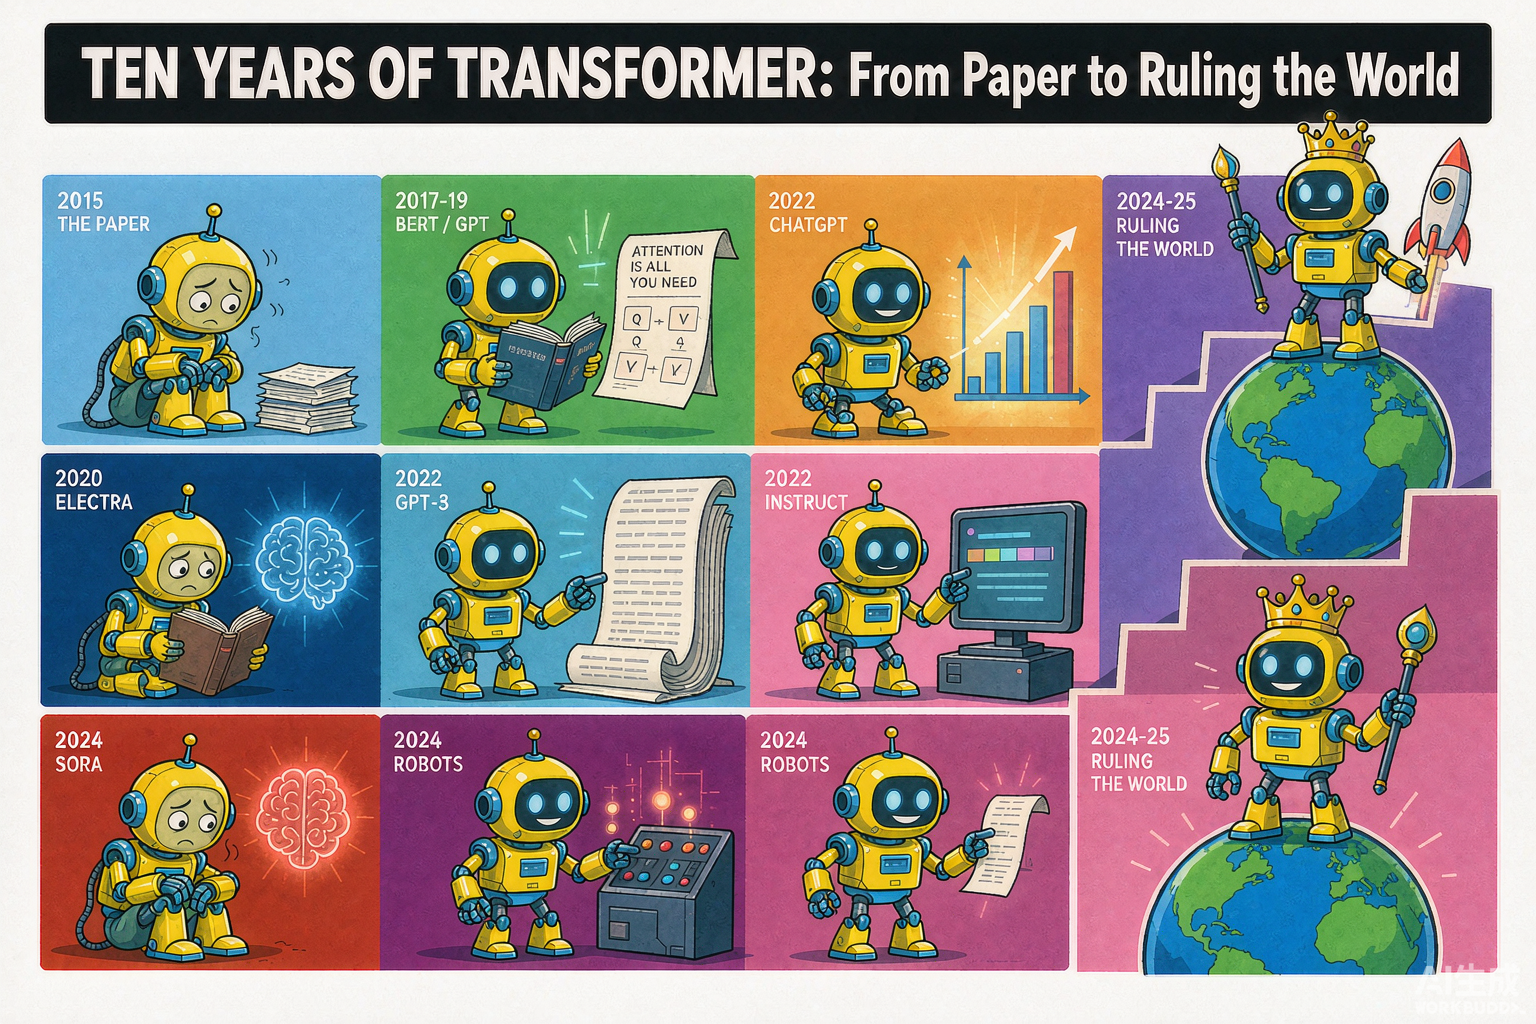
10 年回顾:
- 2017:论文发表,被引用 200+ 次(当时很惊人);
- 2018 – 2020:BERT、GPT-1/2、T5 等基于 Transformer 的模型横扫 NLP 任务;
- 2020 – 2022:GPT-3(1750 亿参数)+ Vision Transformer(ViT)引爆大模型时代;
- 2022 – 至今:所有前沿大模型都是 Transformer 或其变体(GPT-4/5、Claude、Gemini、LLaMA、Qwen、DeepSeek)。
本文回顾这 10 年。
二、Transformer 之前:循环网络的困境(2014 – 2017)
2.1 RNN(循环神经网络)
1990s 主流的序列模型是 RNN(Recurrent Neural Network):
-
- 优点:天然适合序列数据(文本、语音);
- 缺点:顺序计算难以并行 + 长距离依赖丢失。
2.2 LSTM + GRU(2014 – 2017)
为解决 RNN 长期依赖问题,LSTM(1997 提出)+ GRU(2014)成为主流:
-
- 引入门控机制(输入门、遗忘门、输出门);
- 在机器翻译、语音识别任务上取得突破;
- 但仍无法并行 + 训练时间极长。
2.3 注意力机制(2014 – 2017)
注意力机制起源于机器翻译:
- 2014 Bahdanau Attention(首次将注意力引入 seq2seq);
- 2015 Luong Attention(不同注意力变体);
- 2017 Google 推出完全基于注意力的 Transformer——抛弃 RNN/LSTM 的循环结构。
关键洞察:序列建模不一定需要循环——注意力机制本身就足够。
三、Transformer 诞生(2017)
3.1 论文核心
论文 Attention is All You Need 提出:
1. 自注意力机制(Self-Attention)——序列内任意两个位置直接计算关联;
2. 多头注意力(Multi-Head Attention)——并行学习多种关联模式;
3. 位置编码(Positional Encoding)——弥补自注意力对位置的缺失;
4. 编码器-解码器结构——Encoder 编码输入、Decoder 生成输出;
5. 残差连接 + 层归一化——稳定深层网络训练。
3.2 关键数字
-
- 论文实验:英德机器翻译 BLEU 28.4(之前最佳 26.3);
- 训练速度:相比 LSTM + Attention 提升 2 倍;
- 模型大小:基础模型 6500 万参数,最大 2.13 亿参数。
3.3 作者团队
8 位 Google Brain / Google Research 工程师:
- Ashish Vaswani(关键贡献者)、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan N. Gomez、Lukasz Kaiser、Illia Polosukhin。
后续命运:
- Noam Shazeer(Decoder 关键贡献者)—— 离职创办 Character.AI,后被 Google 重新雇佣(2024);
- Aidan N. Gomez —— 创办 Cohere(加拿大 AI 公司);
- Jakob Uszkoreit —— 创办 Inceptive(RNA 生物学 AI 公司);
- Llion Jones —— 创办 Sakana AI(日本)。
Transformer 8 位作者,6 位后来成为 AI 公司创始人——这一篇论文培养了一个创业时代。
四、Transformer 接管 NLP(2018 – 2020)
4.1 BERT(2018)
Google 发布 BERT——首个基于 Transformer 的双向编码模型:
- 3.4 亿参数;
- 在 11 项 NLP 任务上刷新纪录;
- 开启”预训练 + 微调”范式。
BERT 的核心洞察:NLP 可以通过大规模无监督预训练 + 任务微调解决。
4.2 GPT-1/2(2018 – 2019)
OpenAI 发布 GPT-1/2——基于 Transformer 解码器的生成式预训练模型:
- GPT-1(2018.6):1.17 亿参数;
- GPT-2(2019.2):15 亿参数;
- 2019.2 GPT-2 因”太危险”暂不开源,2019.11 全量开源。
GPT 路线 vs BERT 路线:
-
- BERT(编码器):理解类任务(分类、问答);
- GPT(解码器):生成类任务(写作、对话);
- 后续证明 GPT 路线更适合规模化——因为生成比理解更通用。
4.3 T5(2019)
Google 发布 T5——统一文本到文本框架:
-
- 110 亿参数;
- 把所有 NLP 任务统一为”文本到文本”;
- 推动”大规模预训练 + 多任务学习”范式。
4.4 Vision Transformer(2020)
Google 发布 ViT——Transformer 跨界到计算机视觉:
- 关键洞察:图像可以切成 16×16 的”patches”,当成序列处理;
- 在 ImageNet 上超越 CNN;
- 开启多模态 Transformer时代。
五、Transformer 统治大模型(2020 – 2023)
5.1 GPT-3(2020)
OpenAI 发布 GPT-3:
- 1750 亿参数——比 GPT-2 大 100 倍;
- 引入”上下文学习(In-Context Learning)”——不需要微调,提示就能完成任务;
- 开启”大模型时代”。
GPT-3 的范式革命:不再需要针对每个任务微调模型——大模型本身就有通用能力。
5.2 规模化定律(Scaling Laws)
OpenAI Kaplan 2020 论文 + DeepMind 2022 Chinchilla 论文:
-
- 模型性能 ≈ 模型大小 + 数据大小 + 计算量 的幂律;
- Chinchilla 最优:模型大小与数据大小应当等比例缩放(每 1 个参数配 20 个 token 数据);
- 这条规律引导了 LLaMA、PaLM、GPT-4 的训练策略。
5.3 训练成本上升
| 模型 | 年份 | 参数量 | 训练算力 |
|---|---|---|---|
| Transformer (论文) | 2017 | 6500 万 | 8 块 P100 × 几小时 |
| GPT-1 | 2018 | 1.17 亿 | 几天 |
| GPT-2 | 2019 | 15 亿 | 数周 |
| GPT-3 | 2020 | 1750 亿 | 1000 块 V100 × 几周 |
| GPT-4 | 2023 | 1.8 万亿(推测) | 25000 块 A100 × 几个月 |
| GPT-5 | 2025 | 数万亿 | 50000+ 块 H100/B100 |
训练成本从 2017 年的几十美元 → 2025 年的数亿美元,增长了 8 个数量级。
六、Transformer 变体与挑战(2023 – 至今)
6.1 高效注意力变体
Transformer 的核心瓶颈是 O(n²) 注意力计算(n 是序列长度):
-
- Sparse Attention(2020)——只计算部分 token 对的注意力;
- Linear Attention(2020)——线性复杂度近似;
- Flash Attention(2022)—— GPU 优化版注意力;
- Multi-Query Attention(2019)——多查询共享键值;
- Grouped-Query Attention(2023)——分组共享键值;
- Mixture of Experts(MoE)(2024)——条件激活专家子网络;
- State Space Models(Mamba, 2023)——挑战 Transformer 注意力范式。
6.2 长上下文
Transformer 一直受限于上下文窗口(早期 512 token):
- 2017 原始 Transformer:512 token;
- 2018 GPT-1:1024 token;
- 2020 GPT-3:2048 token;
- 2023 Claude 2:100K token;
- 2023 GPT-4 Turbo:128K token;
- 2024 Gemini 1.5:1M – 2M token;
- 2025 Claude 4.5:1M token。
10 年上下文窗口增长了 2000 倍。
6.3 多模态 Transformer
Transformer 扩展到所有模态:
- CLIP(2021)—— 图像-文本对比学习;
- Whisper(2022)—— 语音识别;
- Sora(2024)—— 视频生成;
- Gemini(2023)—— 原生多模态;
- GPT-4o(2024)—— 多模态实时对话;
- LLaMA 3(2024)—— 文本 + 图像。
七、Transformer 时代的遗产与未来
7.1 遗产
1. 注意力机制成为主流——几乎所有前沿模型都用 Transformer;
2. 预训练 + 微调范式——替代了从零训练;
3. 规模化定律——验证了”大力出奇迹”;
4. 多模态统一——Transformer 成为图像、语音、视频的基础架构;
6. 开源生态——Hugging Face Transformers 库成为行业标准。
7.2 挑战者
Transformer 并非完美:
-
- 状态空间模型(SSM):Mamba(2023)—— 线性复杂度,更适合超长序列;
- 混合架构:Jamba(2024)、RecurrentGemma(2024)—— Transformer + SSM;
- 专家混合(MoE):Mixtral(2023)、GPT-4(推测 MoE)—— 稀疏激活。
7.3 未来 10 年
- 2025 – 2030:Transformer 仍是主流,但会与 SSM / MoE 混合;
- 2030 – 2035:可能出现全新架构(基于量子计算 / 神经形态计算);
- AGI 时间点:不可预测——架构不是 AGI 的核心障碍。
八、结语:一篇论文改变世界的 10 年
回到 2017 年——Attention is All You Need 论文的第 4 页写道:
“We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely.”
这是 AI 史上最重要的”小改动”——完全抛弃循环结构,纯注意力机制。这个看似简单的决定,统治了未来 10 年的 AI 时代。
Transformer 的故事告诉我们:AI 突破不一定是算法革命,而是架构选择——选对架构 + 规模化 + 数据驱动 = 改变世界。