一、开篇:AI 是开源还是闭源?
2026 年的 AI 时代,开源 vs 闭源是核心议题之一:
- 闭源派(OpenAI、Anthropic、Google)—— 安全可控、性能领先;
- 开源派(Meta、Mistral、DeepSeek、阿里、智谱)—— 透明可控、生态强大。
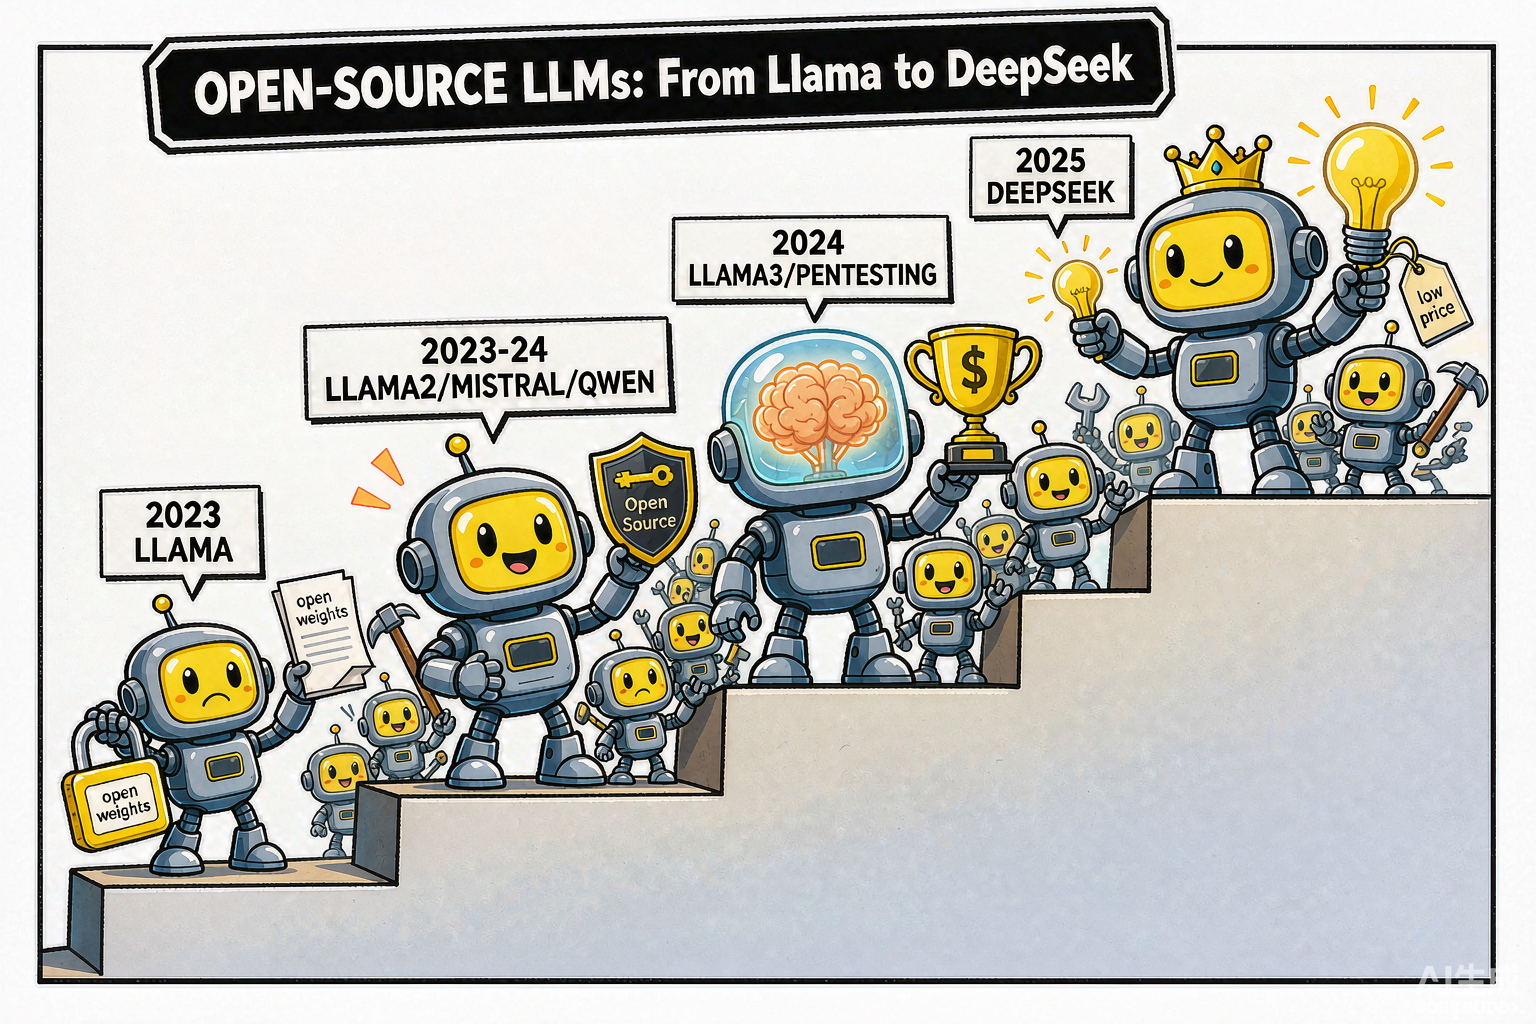
开源大模型 5 年的故事,从 2023 年 Meta 发布 LLaMA 开始,到 2025 年 DeepSeek 引发美股暴跌达到高潮。本文梳理这场革命。
二、开源 vs 闭源:早期争论(2010s – 2022)
2.1 深度学习开源传统
深度学习本身建立在开源之上:
- TensorFlow(Google 2015 开源);
- PyTorch(Meta 2016 开源);
- Hugging Face Transformers(2018 开源)。
早期 AI 研究是高度开放的——论文 + 代码 + 数据集全部公开。
2.2 GPT-2 的”开源争议”(2019)
2019 年 OpenAI 发布 GPT-2(15 亿参数),最初因为”太危险”暂不开源:
-
- 引发”AI 是否应当开源”大讨论;
- 2019 年 11 月全量开源;
- OpenAI 在 2019 年仍然认为”AI 应该开放”。
2.3 GPT-3 闭源(2020)
GPT-3 改变了 OpenAI 的态度:
- 1750 亿参数;
- 2020 年发布时只通过 API 提供,不开源;
- 标志 AI 行业从”开源”转向”API 商业化”。
GPT-3 之后:
-
- OpenAI 不再开源任何后续模型;
- Anthropic、Google 也闭源;
- AI 行业进入”封闭 API”时代。
2.4 EleutherAI 和开源反抗(2020 – 2022)
- 2020.7 EleutherAI 启动——一群 AI 研究员决定”复制 GPT-3″;
- 2020.12 GPT-J(60 亿参数)发布;
- 2021.6 GPT-NeoX(200 亿参数)发布;
- 2021 The Pile 数据集发布(825 GB)。
EleutherAI 是开源大模型的火种——证明了”开源社区可以复现闭源大模型”。
三、LLaMA 引爆开源时代(2023)
3.1 LLaMA-1(2023.2)
Meta 发布 LLaMA-1——开源大模型的转折点:
-
- 65B / 33B / 13B / 7B 四种规格;
- 仅限学术研究使用(非商业);
- 训练数据 1.4 万亿 token;
- 在多项基准测试上超越 GPT-3。
3.2 LLaMA”泄露”事件(2023.3)
LLaMA-1 在 2023 年 3 月通过 BitTorrent 泄露:
-
- 几周内被下载数十万次;
- 全世界的开发者开始基于 LLaMA 微调;
- Meta 的”限制使用”条款形同虚设——开源精神战胜了商业限制。
3.3 LLaMA-2(2023.7)
Meta 顺势发布 LLaMA-2——完全开源可商用:
- 70B / 13B / 7B 三种规格;
- 允许商业使用——直接和 GPT-3.5 / GPT-4 竞争;
- 训练数据 2 万亿 token;
- 与微软合作分发到 Azure。
LLaMA-2 的意义:证明开源大模型可以在性能上逼近闭源模型——闭源不再是不可逾越的护城河。
3.4 LLaMA-3(2024.4)
Meta 发布 LLaMA-3:
-
- 8B / 70B / 400B(最大)三档;
- 405B 版本在多项基准上接近 GPT-4;
- 训练数据 15 万亿 token;
- 原生多模态支持(图像 + 文本)。
3.5 LLaMA-3.1(2024.7)
-
- 405B 模型开源;
- 128K token 上下文;
- 多语言支持(8 种语言);
- Meta 把 LLaMA-3.1 定位为”开源 GPT-4″。
3.6 LLaMA-3.3(2024.12)
- 70B 模型性能逼近 405B;
- 进一步优化推理能力。
Meta 的开源 LLaMA 系列=开源大模型的最强阵容——直接挑战 OpenAI 闭源霸权。
四、Mistral:欧洲开源力量(2023 – 至今)
4.1 Mistral AI 创立(2023.4)
Mistral AI 由前 Google / Meta AI 工程师在巴黎创立:
-
- 创始人:Arthur Mensch(DeepMind 前研究员)+ Guillaume Lample + Timothee Lacroix;
- 定位:欧洲版 OpenAI,开源为主;
- 融资:6 个月估值从 0 到 20 亿美元(创纪录)。
4.2 开源产品
| 模型 | 时间 | 特点 |
|---|---|---|
| Mistral 7B | 2023.9 | 首个开源大模型,性能超 LLaMA-2 13B |
| Mixtral 8x7B | 2023.12 | MoE 架构,开放权重 |
| Mistral 8x22B | 2024.4 | MoE 大模型 |
| Mistral Large | 2024.2 | 闭源对标 GPT-4 |
| Mistral Small / Medium | 2024 | 多种规格 |
Mistral 的双轨策略:
- 开源小模型(建立生态);
- 闭源大模型(商业化收入)。
五、中国开源大模型(2024 – 至今)
5.1 智谱 AI(GLM 系列)
-
- 2024 GLM-4 开源;
- ChatGLM 系列是中国早期开源大模型(2022 起);
- 智谱 AI(北京,2019 创立)—— 清华系,开源 + 闭源混合。
5.2 阿里通义千问(Qwen)
- Qwen-7B/14B/72B(2023.4)开源;
- Qwen-VL 多模态开源;
- Qwen-2(2024.6)开源;
- Qwen-2.5(2024.9)—— 训练数据 18 万亿 token,号称”开源 SOTA”;
- Qwen-3(2025)—— 进一步逼近 GPT-4。
Qwen 是中国开源大模型的代表——在 Hugging Face 下载量长期排名前列。
5.3 百度文心(ERNIE)
-
- 文心 4.0 闭源为主,部分开源(ERNIE-ViLG 等);
- 与阿里、字节错位竞争。
5.4 字节豆包(Doubao)
-
- 字节 2024 年发布豆包大模型;
- 价格战主力(每千 token 0.8 厘 vs OpenAI 数十倍)。
5.5 DeepSeek(深度求索)—— 2025 美股地震
DeepSeek 是 2025 年最戏剧性的 AI 公司:
- 2024.12 DeepSeek-V3 发布——671B 参数 MoE,开源;
- 2025.1 DeepSeek-R1 发布——推理模型,性能对标 OpenAI o1;
- 2025.1.27 美股因 DeepSeek 暴跌——英伟达单日跌 17%(市值蒸发 6000 亿美元);
- 训练成本仅约 600 万美元(vs OpenAI 数亿美元)。
DeepSeek 的意义:
1. 开源大模型可以逼近闭源前沿模型;
2. 训练成本可以大幅降低(算法 + 工程优化);
3. AI 集中化的护城河被打破——单家公司难以独占领先优势。
六、开源大模型生态
6.1 Hugging Face
Hugging Face 是开源大模型的事实平台:
-
- 2022 年估值 20 亿美元;
- 2025 年估值 45 亿美元;
- 平台托管 100+ 万模型;
- Transformers 库被所有 AI 公司使用。
6.2 中国开源平台
-
- ModelScope(阿里达摩院,2022)—— 中国版 Hugging Face;
- ModelZoo(开源中国)—— 中文 AI 模型社区;
- 始智 AI(Wisemodel)—— 中文开源大模型平台。
6.3 微调框架
- LLaMA-Factory(中国开发者)—— 最流行 LLaMA 微调框架;
- Unsloth—— 速度提升 2-5 倍的微调工具;
- Axolotl—— 简化微调流程;
- Hugging Face TRL—— 强化学习微调。
七、开源 vs 闭源:核心争议
7.1 支持开源的理由
1. 透明性——可审查、可重现;
2. 民主化——每个人都能用 AI;
3. 生态——社区贡献推动模型进步;
4. 数据主权——数据不出本地;
5. 安全——多方审查发现漏洞;
6. 学术研究——可重复验证。
7.2 支持闭源的理由
1. 商业可持续——保护商业模式;
2. 安全——防止 AI 滥用;
3. 性能领先——闭源有更多资源;
4. 责任——闭源公司承担责任;
5. 防止恶意使用——避免被坏人利用。
7.3 监管立场
- 欧盟 AI Act——不强制开源,但要求训练数据透明度;
- 美国——倾向监管而不强制开源;
- 中国——《生成式 AI 办法》要求”安全可控”,但鼓励开源生态;
- Meta 立场——开源是”AI 民主化”,防止 AI 集中;
- OpenAI 立场——闭源是”安全可控”。
八、未来 5 年:开源大模型的下一波
8.1 趋势预测
-
- 开源追上闭源——开源模型性能继续逼近闭源前沿;
- 训练成本下降——DeepSeek 模式被广泛复制;
- 垂直模型爆发——医疗、法律、教育、金融等垂直开源模型;
- 端侧部署——手机、汽车、IoT 设备上的开源小模型;
- 国家力量——各国把”开源大模型”上升为国家战略。
8.2 关键不确定因素
- AGI 时间点——AGI 临近时,开源是否受限?
- 监管——AI Act + 各国监管可能限制开源;
- 地缘政治——开源 vs 闭源成为”中美 AI 战”前线;
- 商业可持续——开源公司如何持续盈利?
九、结语:开源大模型是 AI 时代的”GNU 运动”
回到 1998 年——Linux 和 GNU 运动证明了开源软件可以挑战微软;到 2025 年,DeepSeek 证明了开源大模型可以挑战 OpenAI。
开源大模型 5 年告诉我们:
- 开源不是慈善,而是技术 + 商业 + 哲学的综合选择;
- 开源不是低性能,而是”开放 + 性能”的组合;
- 开源不是无序,而是社区驱动的新协作方式。
未来 5 年,开源大模型将从”挑战者”变成”主流”——这是 AI 时代的 GNU 运动。