一、什么是可解释性 SHAP
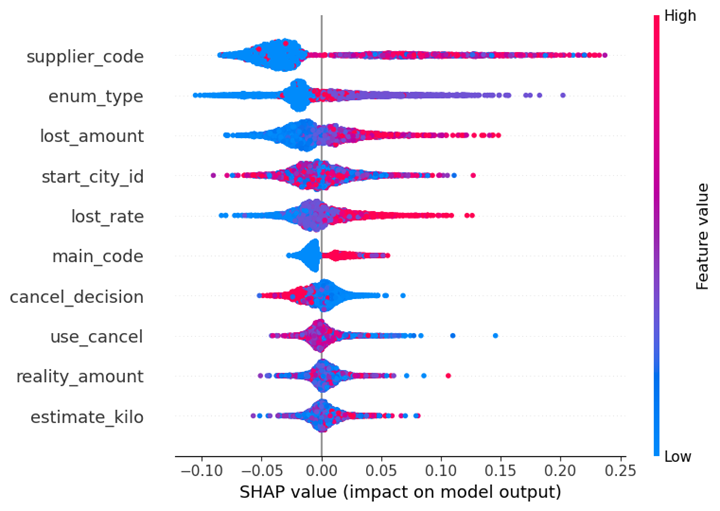
SHAP(SHapley Additive exPlanations)是一套基于合作博弈论中 Shapley 值来量化每个输入特征对模型输出贡献的可解释性方法,由 Lundberg 等人在 2017 年前后系统提出。它通过把每个特征视为「合作博弈中的玩家」,按所有特征子集上的边际贡献求加权平均,得到具有理论一致性、局部准确性与缺失性保证的特征归因值。SHAP 兼容树模型、深度网络与任意黑盒模型,并衍生出 TreeSHAP、DeepSHAP、KernelSHAP 等高效近似算法,被广泛用于金融风控、医疗诊断、合规审计等高敏感场景,使模型决策从「黑盒输出」变成可被业务与监管方审查的依据。
二、原理
1. 特征与玩家映射:把模型输入特征视为合作博弈中的玩家,把模型输出视为合作收益 → 2. 子集边际贡献枚举:对所有可能的特征子集(2^N)计算「加入该特征后预测的变化」 → 3. Shapley 值加权求和:按子集大小的加权平均得到每个特征的 Shapley 值(理论一致且唯一) → 4. 算法近似:针对树模型用 TreeSHAP、深度网络用 DeepSHAP、任意黑盒用 KernelSHAP 等高效近似 → 5. 局部解释组装:把单个样本各特征贡献加和,得到「基准值 + 各项贡献 = 模型输出」的线性解释 → 6. 全局聚合与可视化:通过 Summary Plot、Force Plot、Dependence Plot 等组件做特征级全局解释与交互分析
三、信息卡片
| 中文名 | 可解释性 SHAP |
| 英文名 | SHapley Additive exPlanations |
| 缩写 | SHAP |
| 别名 | SHAP 值、Shapley 值解释、SHapley Additive exPlanations |
| 提出者 | Scott Lundberg 与 Su-In Lee(华盛顿大学)在 2017 年 NeurIPS 论文中系统化提出 SHAP 框架;后续 Lundberg 等陆续贡献 TreeSHAP、DeepSHAP 等算法 |
| 提出时间 | 2017 年(NeurIPS 论文);2018 年起 TreeSHAP 等加速算法陆续发布;2020 年后广泛进入工业 |
| 所属类别 | AI 技术 > 治理层 > 可解释 AI |
| 核心技术 | Shapley 值、TreeSHAP、DeepSHAP、KernelSHAP、博弈论归因 |
| 主要应用 | 金融风控、医疗诊断、合规审计、模型调试、特征工程 |
四、历史时间线
1953 年:Lloyd Shapley 在合作博弈论中提出 Shapley 值,给出公平分配合作收益的数学定义
- 2010-2016 年:可解释性研究在机器学习领域被持续关注,但长期缺乏统一框架
- 2017 年:Lundberg 与 Lee 在 NeurIPS 发表 SHAP,统一了 LIME、DeepLIFT 等多种已有解释方法到 Shapley 值框架
- 2018-2019 年:TreeSHAP、DeepSHAP、KernelSHAP 等高效近似算法陆续发布,SHAP 适用面大幅扩展
- 2020-2022 年:SHAP 工具库(shap)进入 scikit-learn / XGBoost / LightGBM 等主流 ML 生态,成为金融、医疗、监管合规的事实标准
- 2023-2025 年:研究扩展到 LLM 提示归因、反事实解释融合、与隐私计算的结合
五、分类
按模型类型:TreeSHAP(树模型)vs DeepSHAP(深度网络)vs KernelSHAP(任意黑盒)vs LinearSHAP
- 按解释范围:局部解释(单样本)vs 全局解释(特征聚合)
- 按解释形式:特征归因(数值贡献)vs 特征交互(SHAP Interaction Values)vs 反事实解释
- 按应用层次:模型调试用 vs 合规审计用 vs 业务沟通用
- 按关联领域:可解释 AI XAI、模型治理(Model Governance)、Responsible AI
六、应用场景
- 金融风控与信贷:解释「为什么这笔贷款被拒」,满足监管对模型可解释性的要求
- 医疗诊断与影像:解释疾病预测中的关键临床特征,辅助医生决策与合规审计
- 反欺诈与反洗钱:对高风险决策提供特征级依据,供调查员与监管方审查
- 模型调试与特征工程:通过 SHAP Summary 发现数据泄漏、特征偏移与训练-推理不一致问题
- A/B 实验与营销归因:在用户行为模型中用 SHAP 量化每个触点对转化的贡献
- 保险定价与理赔:解释保费或赔付金额的关键特征因子,提升客户沟通与监管接受度
七、优缺点
- 优点:
- 理论严谨:基于 Shapley 值具有一致性、局部准确性、缺失性三大理论保证
- 统一框架:把多种已有解释方法(LIME、DeepLIFT 等)统一到同一框架下
- 可解释性高:把模型判断转化为业务方易理解的「特征贡献」叙事,缩短业务沟通周期
- 生态完备:shap 库与 scikit-learn、XGBoost、LightGBM、PyTorch 等深度集成,工程友好
- 可与合规审计对接:满足金融、医疗等行业的监管要求
- 缺点:
- 计算成本高:精确 Shapley 值是指数级计算,深层近似算法(如 KernelSHAP)在样本量大时显著耗时
- 存在解释幻觉风险:SHAP 是事后解释,复杂模型(如 LLM)上的归因未必反映真实因果
- 对相关特征不稳定:在高度共线特征上不同近似方法的归因可能不一致
- LLM 上仍处早期:在 Transformer / 大语言模型上的归因方法尚未标准化,需结合注意力可视化等手段
八、常见误区
SHAP 值 = 因果效应(错:SHAP 是事后相关性的特征归因,不等于因果;同等相关的特征可以交换归因)
- SHAP 解释 = 模型逻辑(错:SHAP 是事后近似解释,与模型真实决策路径在某些情况下不一致)
- SHAP 可以解释 LLM 的「理解」(错:LLM 内部机制远比特征加和复杂,SHAP 在 LLM 上的应用仍在探索)
- SHAP 越细越好(错:粒度过细反而增加沟通成本,应结合业务颗粒度做摘要与可视化)
九、关联概念
- 父概念:可解释 AI XAI、AI安全、人工智能治理
- 子概念:TreeSHAP、DeepSHAP、KernelSHAP、反事实解释、SHAP Interaction Values
- 兄弟概念:LIME、反事实解释、特征重要性(Feature Importance)、可解释 AI XAI、AI Ethics · AI 伦理
- 对比概念:LIME、注意力可视化(Attention)、反事实解释(Counterfactual)
- 应用相关:金融风控、医疗诊断、反洗钱 AML、AI安全、AI红队

