一、理论奠基期:从 Bellman 方程到 TD 学习(1952-1990)
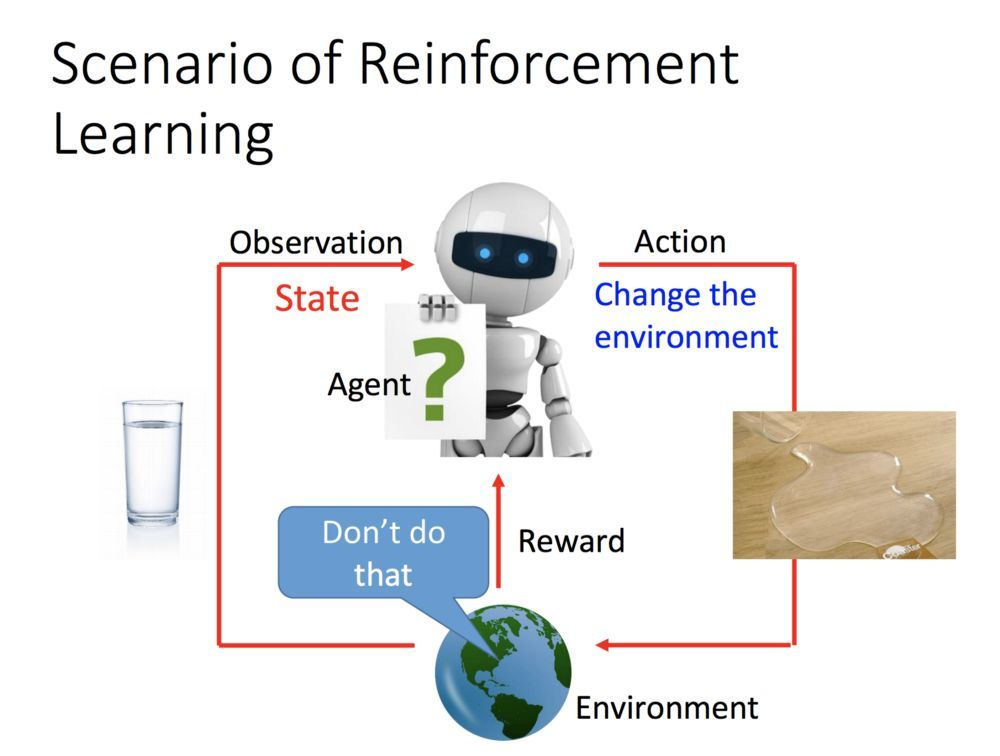
强化学习的理论核心是 Bellman 方程,由 Richard Bellman 在 1957 年提出(他在 RAND 公司工作期间)。Bellman 方程描述了一个智能体在环境中做决策时,长期累积回报的最优求解方式。
1972 年,Chris Watkins 在他的博士论文中提出 Q-Learning——一种让智能体通过与环境的交互学习最优动作的方法。Watkins 的核心洞察是:智能体不需要预先知道环境的转移概率,只需要通过试错就能学到最优策略。
1988 年,Richard Sutton 提出 TD(λ) 时序差分学习(Temporal Difference Learning),这是 Q-Learning 的前奏——能在不完全回合中持续学习。
1989 年,CMU 的 Gerald Tesauro 用 TD(λ) 训练了一个西洋跳棋程序 TD-Gammon,达到了大师级水平。TD-Gammon 的关键不是”学西洋跳棋规则”,而是”通过与自己对弈发现非人类直觉的策略”——它在双陆棋领域发现了几种人类棋手从未使用过的开局。
这一阶段强化学习的特征:
| 理论驱动 | 研究者关注收敛性证明、最优性分析 |
| 小规模 | 所有实验都在 100×100 的网格世界或简单的棋类游戏上 |
| 无深度学习 | Q 表是手工维护的,无法扩展到高维状态 |
1990 年代,强化学习的研究热度下降,被支持向量机(SVM)和神经网络抢了风头。但一些关键人物继续坚持——其中包括 DeepMind 创始人 Demis Hassabis。
二、复兴期:从 TD-Gammon 到 Deep Q-Network(1990-2013)
1997 年,IBM 的 Deep Blue 击败国际象棋世界冠军 Garry Kasparov。但 Deep Blue 用的是暴力搜索——评估每一步棋的 60 亿个可能局面,不是机器学习。
这个区别很关键:Deep Blue 没有”学习”,它只是算得快。强化学习的目标是让智能体自己学。
1998 年,Andrew Ng 和 Michael Jordan 发表”PEGASUS”论文,首次在大规模真实环境中应用强化学习——它通过模拟飞行直升机的轨迹来学习最优飞行策略。这是强化学习第一次走出游戏,进入机器人控制领域。
2003 年,DeepMind 创始人 Demis Hassabis 在伦敦大学学院读博士,他的研究方向是用神经网络辅助围棋 AI——但当时技术不够。2005 年,他与 David Silver(后来 DeepMind 的首席科学家)首次相遇于伦敦游戏 AI 会议,两人讨论了”用神经网络 + 强化学习玩 Atari 游戏”的可能性——这个想法 8 年后才实现。
2013 年 12 月,DeepMind 在 NeurIPS 发表”Playing Atari with Deep Reinforcement Learning”——DQN(Deep Q-Network)首次让深度神经网络 + Q-Learning 结合,能玩 7 款 Atari 游戏并达到人类水平。
DQN 的关键创新是 Experience Replay——智能体把过去的经验存储在缓冲区,训练时随机采样,破坏样本相关性。这是”经验回放”的诞生,让神经网络 + 强化学习的组合终于可行。
2015 年 2 月,DeepMind 在 Nature 发表”Human-level control through deep reinforcement learning”——DQN 玩了 49 款 Atari 游戏,在 23 款上超过人类水平。
DQN 的意义不在游戏本身,而在通用性——它证明强化学习 + 深度学习可以”零样本”学习不同任务,不需要为每个游戏单独调参。
三、AlphaGo 时代:从蒙特卡洛树搜索到 AlphaGo Zero(2016-2017)
围棋是人工智能皇冠上的明珠——状态空间 10^170,比国际象棋(10^120)还大,暴力搜索完全不可行。
2016 年 3 月 9-15 日,DeepMind 的 AlphaGo 在韩国首尔以 4:1 击败韩国围棋世界冠军 李世石。这是 AI 历史最具标志性的事件之一。
AlphaGo 的核心是 深度神经网络 + 蒙特卡洛树搜索(MCTS):
| 策略网络 | 预测下一步棋的最佳位置 |
| 价值网络 | 评估当前局面的胜率 |
| MCTS | 结合策略网络 + 价值网络 + 快速模拟,找到最优解 |
AlphaGo 的训练分三阶段:
1. 用 160,000 局人类棋谱训练监督学习
2. 让神经网络自我对弈,用强化学习进一步训练
3. 用 MCTS 在实际对局中做出决策
AlphaGo vs 人类的”第 78 手”成为历史经典——AlphaGo 的下法打破了所有围棋传统的认知,被围棋界称为”上帝之手”。
2017 年 1 月,DeepMind 在 Nature 发表 AlphaGo 升级版 AlphaGo Zero。Zero 的训练完全不需要人类棋谱——它只通过自我对弈(40 天自我训练)就达到了超越 AlphaGo Lee(击败李世石的那个版本)的水平。
2017 年 10 月,DeepMind 发表 AlphaGo Zero 通用版 AlphaZero——同样无需人类知识,只在 24 小时内学会国际象棋、围棋、将棋三种棋类,全部达到超越人类水平。
AlphaZero 的意义远超游戏——它证明”通用智能”是可能的,不需要为每个任务单独编程。
四、应用爆发期:从 Atari 到机器人到 LLM(2016-2023)
DQN 和 AlphaGo 之后,强化学习进入应用爆发期。
机器人控制:2017 年 OpenAI 推出 Dactyl,让机械手用强化学习学会单手解魔方。2019 年 Google Brain 的”RLPytroch”框架让工业机器人用 6 小时学会装配。2022 年 NVIDIA 推出 Isaac Lab,把强化学习用于工业机器人训练。
自动驾驶:Waymo 和 Tesla 都用强化学习训练规划模块(不是端到端,而是局部规划)。小马智行、文远知行的模拟测试平台大量使用 RL 生成对抗性场景。
游戏 AI:2019 年 DeepMind 的 AlphaStar 在《星际争霸 II》击败人类世界冠军(10:1)。OpenAI Five(2018 年)在《Dota 2》击败世界冠军 OG 战队(2:0)。
大模型对齐(RLHF):这是强化学习在过去 3 年最重要的应用。
2017 年 OpenAI 提出 RLHF(Reinforcement Learning from Human Feedback)。2019 年 Paul Christiano、Jan Leike 在 OpenAI 提出”对齐问题”——如何让 AI 系统的目标和人类目标一致。
2022 年 InstructGPT 论文——OpenAI 用 RLHF 训练 GPT-3,让它从”续写文字的机器”变成”遵循指令的助手”。这是 ChatGPT 诞生的关键——ChatGPT 不是 GPT-4 的革命,而是RLHF 训练的革命。
2023 年 RLHF 进一步演化为 DPO(Direct Preference Optimization) 和 RLAIF(Reinforcement Learning from AI Feedback)——前者由 Stanford 提出,不再需要 PPO 算法;后者由 Anthropic 提出,用 AI 自己评估 AI 的输出,减少人类标注需求。
到 2024 年,所有主流大模型(GPT-4 / Claude 3 / Gemini 1.5 / 文心 4 / 通义 2.5 / 豆包 / 混元)都依赖某种形式的强化学习对齐——这是强化学习 50 年来最大的商业成功。
五、中国玩家:从 DeepMind 到 BAT + 商汤 + 字节(2016-2026)
中国强化学习的产业化比 DeepMind 晚了 5-8 年,但追赶速度极快。
腾讯 AI Lab(2016 年成立):2018 年首次用 RL 在《王者荣耀》击败顶级职业选手。2020 年”绝悟”AI 在《王者荣耀》世界冠军杯 5v5 比赛夺冠。
字节跳动 AI Lab(2016 年成立):2021 年发表”ByteRL”框架,训练机器人完成复杂操作。2024 年用 RLHF 训练豆包大模型。
阿里通义实验室(2017 年):2019 年”淘宝 RL 推荐”上线,每秒服务 100 万次推荐请求。2023 年用 RLHF 训练通义千问。
百度研究院(2013 年成立):2017 年在《星际争霸》AI 比赛中获奖。2023 年用 RLHF 训练文心一言。
华为诺亚方舟实验室(2012 年成立):2019 年”天筹”RL 平台用于供应链调度。2024 年用 RLHF 训练盘古大模型。
商汤科技(2014 年成立):2018 年 SenseTime RL 框架用于自动驾驶规划。2024 年与车企合作推出 RL-based 自动驾驶算法。
深度求索 DeepSeek(2023 年成立):2024 年发布 DeepSeek-V2 论文,详细披露 RLHF 训练流程,是国内最透明的 RLHF 工程实现之一。
中国 RL 的特点是应用驱动——所有玩家都把 RL 落地到具体业务(推荐、游戏、自动驾驶、对话),而不是纯研究。
六、十字路口:强化学习的下一步是”具身智能”
强化学习 70 年的下一步,是 World Model + 具身智能(Embodied AI)。
2024 年起,强化学习的范式从”试错学习”转向”世界模型”:
- DreamerV3(2024 年 1 月,DeepMind):在 150 个任务上达到 SOTA,包括 Atari、机器人、围棋
- Sora + RL(2024 年 2 月,OpenAI):用 Sora 生成虚拟环境做 RL 训练
- Voyager(2023 年 5 月,英伟达):Minecraft 中的 LLM + RL agent,能持续探索和学习新技能
- MuZero(2019 年起,DeepMind):无需知道环境规则,仅通过交互就能学到最优策略,2024 年应用到大模型推理加速
强化学习的下一个 10 年关键问题:
1) 样本效率:当前 RL 需要 10^6-10^9 次交互才能学会一项任务,人类婴儿只需要 10^1-10^2 次演示。如何降低样本需求是核心难题。
2) 安全 RL:RL 智能体在探索过程中可能产生灾难性后果(比如自动驾驶撞墙)。Safe RL、Constrained RL 在 2024 年成为独立子领域。
3) 多智能体 RL:单个智能体强化学习已很成熟,多智能体协作(Multi-Agent RL)仍是开放问题。OpenAI Five 的成功是罕见的——多数多智能体 RL 训练 7 天都收敛不到好策略。
4) 与 LLM 结合:2025 年的趋势是 LLM + RL——用 LLM 做”高层决策”,用 RL 做”低层动作”。这一范式在机器人、自动驾驶、游戏 AI 上都开始看到突破。
5) 世界模型:RL 智能体如果能在内部”模拟”环境变化,就能减少真实环境交互。Sora、Genie、Genie 2 等”世界模型”在 2024-2026 年成为 RL 训练的关键基础设施。
70 年后,强化学习的真正意义是”让 AI 学会通过试错变得更好”——这是 Arthur Samuel 在 1952 年 IBM 701 上演示西洋跳棋时埋下的种子。今天,这颗种子开出的花叫 ChatGPT、自动驾驶、AlphaGo、世界模型——而它们都还在继续生长。