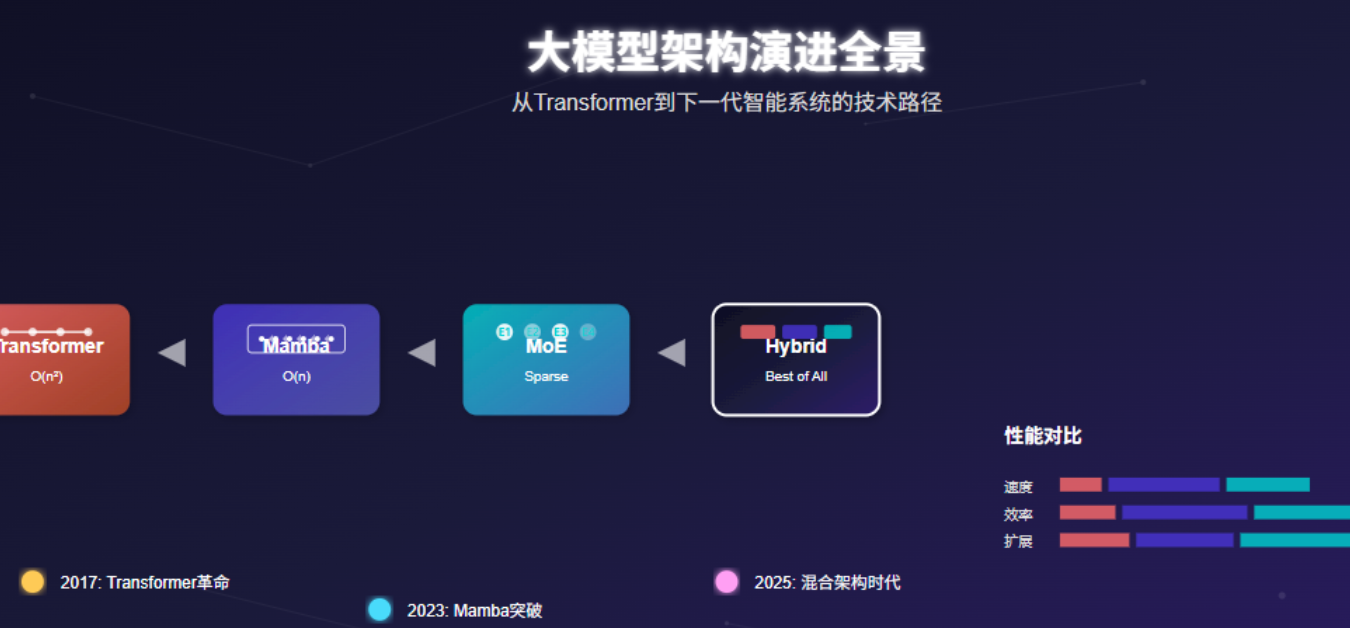
2017 年 Google 团队发表《Attention Is All You Need》提出 Transformer 架构,7 年后这个架构成为所有大模型的「基础母语」——GPT、LLaMA、Claude、Gemini、DeepSeek、文心、通义千问全部基于 Transformer。但 Transformer 不是终点:2019 年 GPT-2 验证了「规模即能力」, 2020 年 GPT-3 验证了「In-context Learning」, 2021 年混合专家 (MoE) 出现解决「规模 vs 成本」, 2023 年 Mamba 用状态空间模型挑战「注意力是唯一出路」, 2024 年混合架构 (Jamba/CoE) 把 Transformer 和 Mamba 组合, 2025 年稀疏注意力 (MoBA) 把计算成本再降 10 倍。
一、Transformer 诞生:注意力机制的工程胜利(2017-2018)
2017 年 6 月 Google Brain 团队发表 8 人合著论文《Attention Is All You Need》——这篇论文首次提出 Transformer 架构。Transformer 用「自注意力机制」(self-attention) 替代 RNN/LSTM 的序列依赖,让模型可以并行训练整个序列。论文实验证明 Transformer 在英德机器翻译任务上超过当时所有 SOTA,BLEU 分数提升 2.0+。
Transformer 的核心创新是「多头自注意力」(Multi-Head Self-Attention):模型在处理每个 token 时,同时计算它与序列中所有其他 token 的关联强度,再用这些关联强度加权求和。这种「全局视野」让 Transformer 比 RNN 更好地处理长距离依赖(解决 RNN 的「长程遗忘」问题),又比 CNN 更好地处理可变长度序列。
2018 年 Google 发布 BERT(Bidirectional Encoder Representations from Transformers)——把 Transformer 编码器单独抽出做预训练,在 11 个 NLP 任务上同时提升 1-7%。BERT 引入了「掩码语言模型」(MLM) +「下一句预测」(NSP) 两个预训练目标,奠定了「预训练 + 微调」范式。BERT 在发布后 18 个月内被引用超过 30000 次,成为 NLP 引用最多的论文。
二、规模法则:GPT-2/3 证明「规模即能力」(2019-2020)
2019 年 OpenAI 发布 GPT-2(15 亿参数)——首次证明「规模即能力」:随着模型参数从 117M → 345M → 762M → 1.5B 增长,模型在零样本任务上的能力连续提升,没有明显天花板。GPT-2 论文首次提出「零样本学习」(zero-shot learning) 是大规模语言模型的涌现能力。
2020 年 OpenAI 发布 GPT-3(1750 亿参数)——首次证明「In-Context Learning」(ICL) 现象:模型不需要重新训练,只要在 prompt 中给几个示例(few-shot),就能在新任务上做推理。GPT-3 论文证明 ICL 是大模型特有的涌现能力——参数 <10B 的模型几乎不出现 ICL,175B 的 GPT-3 突然出现。
GPT-3 的另一个突破是「规模法则」(Scaling Laws) 的工程化:Kaplan 等人在 2020 年论文《Scaling Laws for Neural Language Models》中证明,模型性能与「参数规模 + 数据规模 + 计算规模」三者的对数线性相关。这给 AI 实验室指明了方向——「只要堆算力,性能就会涨」。2020-2024 年全球 AI 投资 90% 流向「规模扩张」方向。
三、对齐与对话:RLHF + ChatGPT 触发工业革命(2021-2023)
2022 年 11 月 OpenAI 发布 ChatGPT——把大模型从「研究项目」变成「大众产品」的关键节点。ChatGPT 5 天内 100 万用户、2 个月 1 亿用户(移动互联网产品中速度最快),直接引爆 2023-2024 年 AI 投资狂潮。
ChatGPT 背后的工程突破是 RLHF(Reinforcement Learning from Human Feedback)——用人类反馈训练「奖励模型」再 RL 微调语言模型。这套方法把 GPT-3 的「续写能力」变成「对话能力」:模型学会「按照用户意图回答」而非「续写概率最高的文本」。OpenAI 在 2022 年 InstructGPT 论文中证明,13B 参数 RLHF 模型超过 175B 无 RLHF 模型。
2022 年同期 Anthropic 发布 Claude(基于 Constitutional AI 对齐方法)、Google 发布 PaLM(540B 参数)、Meta 发布 OPT-175B(开源)。2023 年 Meta 发布 LLaMA-65B(开源权重),引发「开源 vs 闭源」大讨论——这是后续 DeepSeek / Mistral / Qwen 开源生态的起点。
四、效率革命:MoE + 稀疏激活(2021-2024)
2021 年 Google 推出 Switch Transformer(1.6 万亿参数)——首次把「混合专家」(Mixture of Experts, MoE) 引入 Transformer。MoE 架构把模型的 FFN 层分成 256 个「专家」,每次只激活 1 个专家 + 1 个路由器。Switch Transformer 总参数 1.6T 但每次推理只激活 200 亿参数(12.5%),让训练成本降为同等性能稠密模型的 1/8。
2023 年 Mistral AI 推出 Mixtral 8x7B——开源 MoE 模型,每个 token 路由到 2 个专家(共 56B 总参数,每次激活 13B),性能超过 Llama 2 70B。2024 年 Mistral AI 推出 Mixtral 8x22B(141B 总参数,每次激活 39B),再次验证 MoE 「同等性能下 1/5 训练成本」的工程价值。
2024 年中国大模型集体押注 MoE:DeepSeek-V2(236B 总参数,激活 21B)、阿里 Qwen2-57B-A14B(57B 总参数,激活 14B)、字节 Seed-MoE。月之暗面 Kimi K2、智谱 GLM-4.5 都采用 MoE 架构。MoE 在 2024-2025 年成为大模型「标配」——单一稠密架构只剩 Anthropic Claude 和 OpenAI o1 系列还在用。
五、后 Transformer 时代:Mamba+混合架构(2023-2026)
2023 年 12 月 Albert Gu 和 Tri Dao 提出 Mamba——一种基于「状态空间模型」(State Space Model, SSM) 的新架构。Mamba 用「选择性状态空间」让模型可以像 RNN 一样高效处理长序列,又保持 Transformer 般的并行训练能力。Mamba 在语言建模基准上与同规模 Transformer 打平,但推理速度快 5 倍、内存占用低 1/3。
2024 年 AI21 Labs 推出 Jamba(12B MoE+SSM 混合架构)、Mistral AI 推出 Mixtral 8x22B(MoE)、Meta 推出 LLaMA 3(405B 稠密)、OpenAI 推出 GPT-4o(多模态原生)。「混合架构」(hybrid) 成为主流——单纯 Transformer 或单纯 Mamba 都无法兼顾所有需求,混合架构能让模型在「长序列处理」(Mamba 强) +「上下文理解」(Transformer 强) 之间取平衡。
2025 年大模型架构进入「组合优化」时代:Anthropic Claude 3.7 Sonnet 推出「混合推理模式」(Hybrid Reasoning Mode),用户可以选择「快速回答」或「深度思考」;OpenAI o3 在数学和编程上首次达到人类专家级;DeepSeek-V3 用 671B MoE 架构训练成本仅 558 万美元(vs GPT-4 的 1 亿美元+)。稀疏注意力 (MoBA, NSA) 把 128K 上下文计算成本降低 10 倍,让「百万 token 上下文」成为现实。2026 年初出现的「架构即产品」(Architecture-as-a-Product) 趋势让不同行业(金融 / 医疗 / 法律)能基于统一基座模型微调出不同架构变体。