考古学是少数”数据一旦损毁就永久损毁”的学科。AI 在这里的作用不是替代挖掘,而是把已经积累了几十年的碎片记录,重新变成可检索、可比对的信息。
一、2000 年代:扫描工程的副产品
Google Books 在 2005 年启动大规模古籍数字化,最初的做法是购买厂商 OCR。当时的做法是 厂商 OCR 对竖排古籍的识别率长期低于 30%,因为训练数据里的”书”默认是横排、简体、铅印的。意外的产物是:这批低质量 OCR 文本反而成了后续古文字识别的第一批真实训练数据。
这是一个典型的技术选型失败案例。扫描质量在这个阶段是可靠的,真正的瓶颈在于 OCR 引擎的假设:它假设文字行是水平的、字符是方形的、页面没有虫蛀与霉变。而出土文献三个条件全不满足。
更麻烦的是文字方向问题。竖排文献的相邻两列在图像上是水平相邻的,如果引擎先按水平方向切分再识别,整页结果会是混乱的。这个问题在通用 OCR 中不成立,因此也从未被解决。
意外的价值来自哪里呢。尽管识别错误率极高,但这些扫描件为后来的研究者提供了成规模的真实图像语料。一张错误率 70% 的 OCR 结果仍然会保留字形轮廓与结构信息,这对训练形状敏感的模型已经足够。很多重要数据集的起点正是这类”质量很差但数量够大”的早期扫描。
数字化的另一个长期争议是保存格式。中文古籍的字体、版式与异体字极其复杂,简单转成现代字体会在几代之后就无法准确再现原貌。最终多数机构选择同时保存原始扫描件与带版式标注的转写,代价是存储成本高出几个数量级。
二、2010 年代:古文字 OCR 的专用化
甲骨文、简牍、敦煌文书的专用 OCR 系统在这一时期陆续出现,核心是把字符切分从矩形框改成笔画与偏旁级别的建模。关键设计是 因为出土文献多有残缺与漫漶,识别必须输出候选集合而非唯一答案,这与通用 OCR 的设计目标恰好相反。
专用识别的第一个突破点是把”切分”与”识别”合并。通用 OCR 先切字再识字,切分错误一旦发生就无法挽回;而古文字的字与字之间常常粘连、笔画被漫漶吞掉,必须先看整行再决定怎么切。
第二个突破点是候选集输出。对于一个只剩三分之二笔画的字,给出唯一答案是不可靠的,正确做法是输出按可能性排序的候选列表,把判断权交回给专家。这个设计看似降低了自动化程度,实际上大幅提高了实际可用性——因为考古释读本来就是专家的最终责任。
标注成本是这一领域最真实的瓶颈。百万级字符的释文标注意味着大量专家工时,而这部分投入往往无法完全归入项目预算。相比之下,通用 OCR 的训练数据可以免费从互联网上获取。所以真正制约古文字 AI 的从来不是算法,而是高质量标注的供给。
需要警惕一个常见的误解:古文字识别并不等于释读。把字认出来只是第一步,确定它在整篇文献中的含义、判断它是原件还是后人摹本、评估残缺部分的补全是否可信,这些都是无法自动化的专业判断。
三、2020-2023:从释读辅助到整器物重建
2023 年 Google DeepMind 与雅典大学合作,用神经网络补全古希腊古埃及残缺纸草手稿。Google 的 Nespresso-3 项目用书法风格约束减少了补全结果的臆造成分,但学界明确强调:补全结果必须与原迹严格区分标注。此后方向发生转变:技术重心从”读出文字”转向”重建三维形态”,包括烧制陶器形制、墓葬堆积结构与已焚毁卷轴的成像复原。
DeepMind 与雅典大学的合作项目专门处理希腊国家档案馆收藏的残缺纸草,这些文献距今约两千年。项目的核心创新是让模型先学习特定书写者的笔画风格,再在这个约束下预测缺字,从而避免模型给出与该抄写者风格不符的”平均化”结果。
这次合作的规范做法值得肯定:所有补全字符在成果中以不同颜色标注,且论文明确声明补全结果是推测而非发现。这与考古学界对”复原”与”补全”的严格区分是一致的。
卷轴复原是另一个方向。2019 年的研究用 X 射线衍射读取火山碳化卷轴的卷曲内部结构,再训练神经网络从内部透射图像推断表面的墨迹。这条路线的关键不是识别,而是重建——它从未见过卷轴表面的任何可见像素。
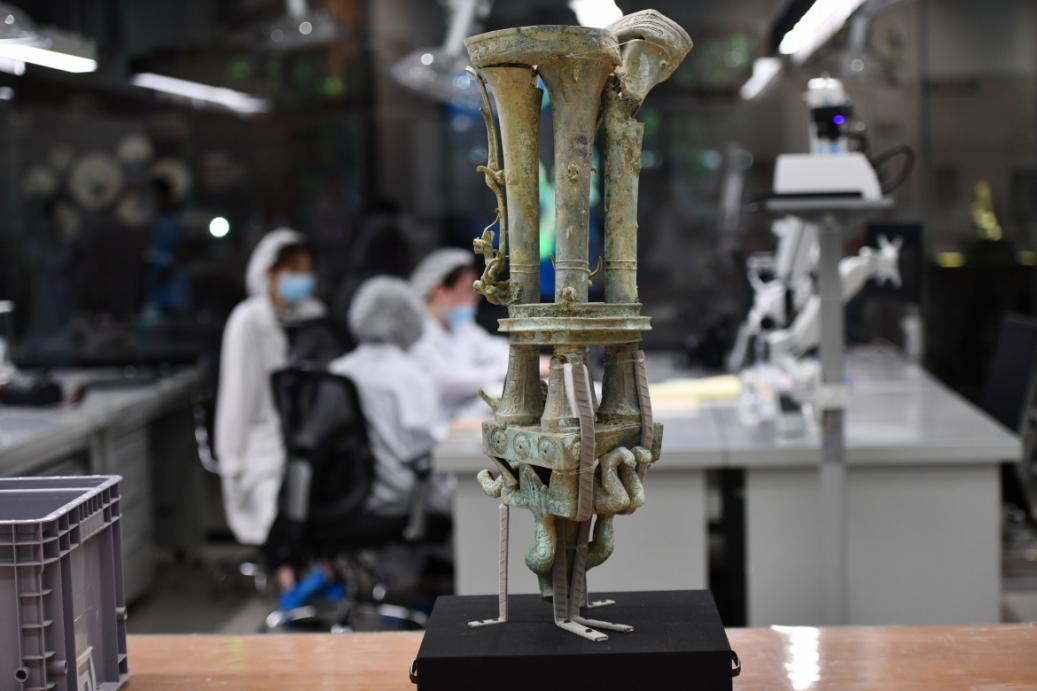
三维重建在器物方向的应用更接近考古现场。对烧制变形的陶罐做形制复原,对散落墓葬做堆积结构重建,这些任务的价值在于检验假设:如果一个器物散落在某个位置,那么它来自哪件器物,这本身就是一个可验证的考古问题。
四、争议:机器是否在替考古学家做判断
2022 年一件古埃及籍贯推断的 AI 研究被广泛报道后受到方法论质疑。该研究用伪语言样本训练,而伪语言与真实古埃及语的关系不足,且样本量小到无法支撑结论——机器学习能给出相关性,但考古结论需要的是可证伪的机制解释。因此行业形成了明确规则:由此形成的行业共识是:AI 只能用于提出假设和标注加速,断代与认定必须由考古学家签字。
这次事件的过程很典型:研究本身公开发表并通过了同行评审,媒体报道时只保留了”AI 推断出古埃及人来自何地”这个结论,方法的局限在传播中被完全剥离。结果是既没有给古埃及研究带来新知,又让考古学界整体对 AI 产生了警惕。
方法论质疑的三个具体点值得记录。第一,用伪语言训练意味着模型学的是语言学模型的分布,而不是真实语料的分布。第二,样本量远不足以支撑地理归因这类结论。第三,即使相关性强,也无法排除共同环境因素这个解释。
更根本的问题是举证责任的分配。在统计研究中,发现相关性就是研究成果;在考古研究中,相关性只是一个待验证的线索,因为考古结论直接关系到对历史事件的陈述。这两种研究传统的差别,无法通过更好的模型来消除。
行业目前的实践共识因此相当保守但清晰:AI 在最擅长的地方发挥作用——在百万级残片里快速找出可能对应的字词,在三维扫描数据里快速找出可能匹配的器物片段。而最终的释读、断代与归属判断,仍然由有资质的研究者依据完整证据链做出。