一、什么是湖仓查询引擎
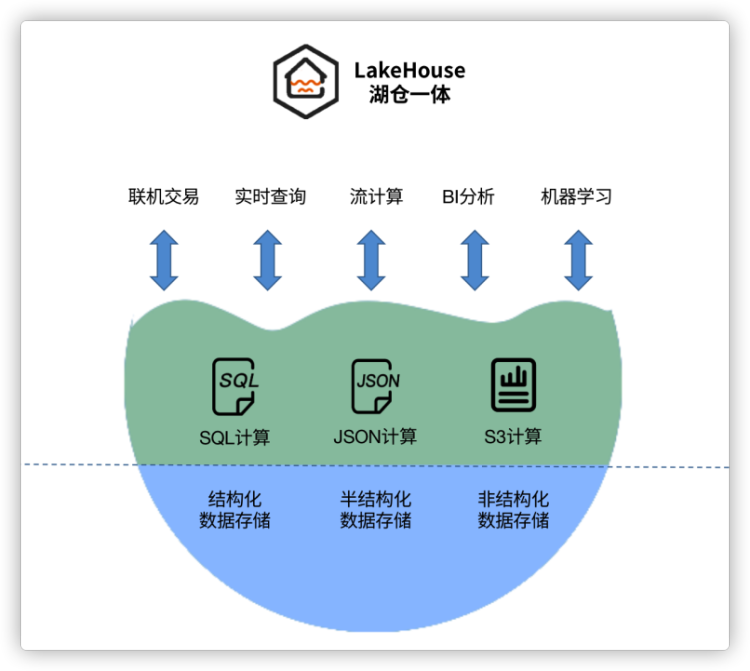
湖仓查询引擎(Lakehouse Query Engine)是在数据湖(Object Storage 上的开放格式数据)之上直接提供数仓级高性能 SQL 查询能力的引擎层,典型代表如 Databricks Photon、StarRocks、Doris、Trino/Presto 等。它打破了传统「数据湖存原始数据 + 数据仓库存加工数据」的双层架构,使一份开放格式数据既能承载低成本存储,又能提供秒级甚至亚秒级分析查询,是湖仓一体(Lakehouse)落地的核心引擎。
二、原理
1. 开放格式适配:直接查询 Iceberg / Hudi / Delta Lake / Parquet 等格式 → 2. 向量化执行引擎:CBO 优化、向量化计算与并行执行 → 3. 湖上加速层:Data Cache、索引、物化视图与自动小文件合并 → 4. 联邦查询:跨数据湖、数据仓库、数据库统一 SQL 查询 → 5. 资源隔离与弹性:支持多租户、Serverless 与弹性伸缩 → 6. 数据更新能力:支持 ACID 事务、Time Travel、Schema Evolution
三、信息卡片
| 中文名 | 湖仓查询引擎 |
| 英文名 | Lakehouse Query Engine |
| 缩写 | Lakehouse |
| 别名 | 湖仓查询引擎 |
| 提出者 | 2017 年 Delta Lake、Apache Icebe |
| 提出时间 | 2017 年 |
| 所属类别 | IT 基础架构与开发 > IT基础架构与开发 |
| 核心技术 | 在数据湖上直接提供数仓级 SQL 查询的引擎层 |
| 主要应用 | 在数据湖上直接提供数仓级 SQL 查询的引擎层 |
四、历史时间线
- 2017 年 Delta Lake、Apache Iceberg 等开放表格式出现奠定湖仓基础。
- 2019 年 Uber 开源 Hudi 进一步丰富生态。
- 2022 年 StarRocks、Doris 等 MPP 引擎把湖上查询推到新性能高度。
- 2024 年 Snowflake、Databricks 持续优化湖仓性能。
五、分类
- 基础资源层:计算、存储、网络硬件与虚拟化
- 平台中间层:容器、编排、服务网格与中间件
- 应用架构层:微服务、Serverless、事件驱动
- 研发效能层:CI/CD、平台工程、开发者体验
六、应用场景
- 大型企业 IT 基础设施现代化
- 云原生应用开发与部署
- DevOps 与平台工程实践
- 数据密集型系统建设
- 多云与混合云管理
七、优缺点
- 优点:
- 简化数据架构:避免湖仓分层带来的数据搬迁与口径不一致
- 降低存储成本:开放格式存储相比专有仓库存储典型降低 50%-70% 左右
- 提升查询性能:通过向量化与缓存使湖上查询达到仓库级性能
- 支撑实时分析:流批一体与秒级延迟覆盖更多业务场景
- 促进数据开放:开放格式与开放接口打破厂商锁定
- 缺点:
- 运维复杂度上升:组件数量增多导致故障域与排障路径变长
- 学习曲线陡峭:新平台、新范式对团队技术能力要求较高
- 生态绑定风险:过度依赖单一开源项目或云厂商会带来锁定
- 性能与成本平衡:高级特性往往伴随额外资源开销与许可成本
八、常见误区
- 新平台一定优于旧平台(错:需结合团队能力、业务规模与生态成熟度)
- 开源方案没有成本(错:人力、运维、安全加固等隐性成本不容忽视)
- 上云就能解决所有问题(错:跨云、成本治理、可靠性仍是难点)
- 一次架构升级能管十年(错:架构需随业务持续演进)
九、关联概念
- 父概念:云计算 Cloud Computing、FinOps云财务运营
- 子概念:云原生、混合云
- 兄弟概念:多云管理、容器化(Containerization)
- 对比概念:Kubernetes容器编排、Microservices · 微服务
- 应用相关:DevOps · 开发运维一体化、数据库 Database