一、什么是模型蒸馏技术
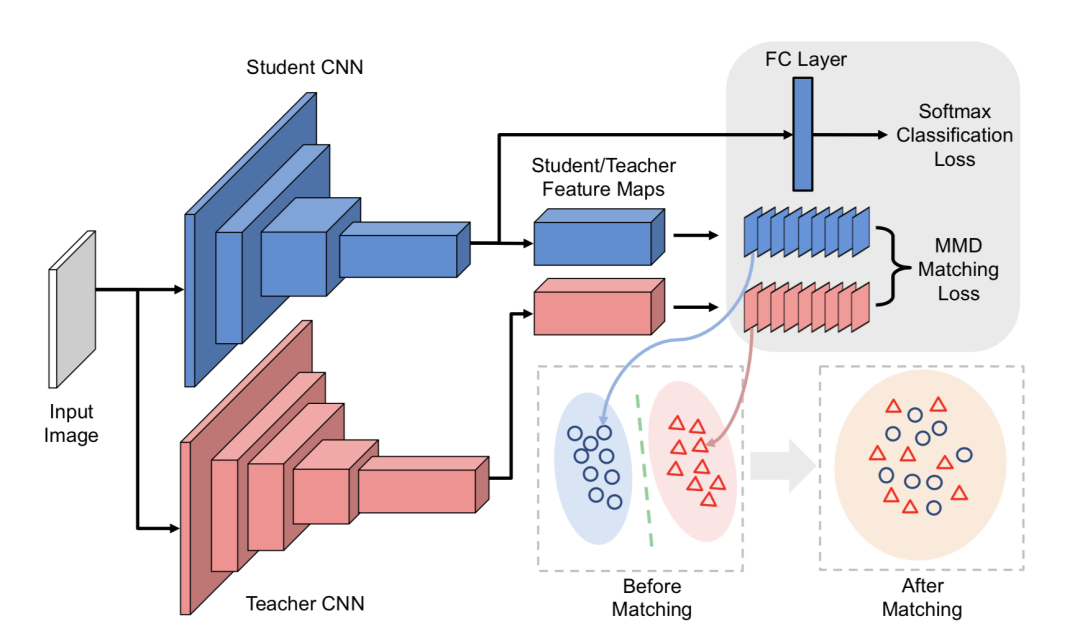
模型蒸馏技术(Knowledge Distillation,KD)是一类将大型预训练模型(教师模型)所学的知识迁移到参数量更小、推理成本更低的轻量模型(学生模型)中的训练方法。其核心思想是让学生模型不仅拟合真实标签的硬目标,还拟合教师模型输出的软概率分布、中间层表征或隐式关系,从而在显著缩减参数规模的同时保留大部分预测能力。它主要解决大模型部署时算力昂贵、响应延迟高、显存占用大的痛点,使高容量模型的能力能够下沉到端侧设备和低成本生产环境。该技术由 Hinton 等人在 2015 年前后系统化提出,是当前大模型小型化与边缘部署的关键支柱之一。
二、原理
1. 教师模型准备:选定一个已收敛、泛化能力强的大模型作为知识来源,其能力上限决定学生模型的天花板 → 2. 软标签生成:对教师输出 logits 做温度平滑(softmax with temperature),获得携带类别相似度的概率分布 → 3. 蒸馏损失设计:组合硬标签交叉熵与软标签蒸馏损失,通过温度系数调节分布平滑度,平衡两类监督信号 → 4. 特征对齐:可选地对齐教师与学生的中间隐藏层表征或注意力图,传递结构化特征提取能力 → 5. 学生模型训练:用组合损失反向传播更新学生参数,通常选用结构相似但层数/宽度更小的模型 → 6. 多阶段精炼:通过自蒸馏、课程式蒸馏或数据蒸馏迭代提升学生能力并避免灾难性遗忘
三、信息卡片
| 中文名 | 模型蒸馏技术 |
| 英文名 | Knowledge Distillation |
| 缩写 | KD |
| 别名 | 知识蒸馏、师生学习、模型蒸馏 |
| 提出者 | Hinton、Jeff Dean、Vinyals 等(Google / DeepMind 团队,2015 年) |
| 提出时间 | 2015 年前后(Hinton「Distilling the Knowledge in a Neural Network」论文) |
| 所属类别 | AI 技术 > 机器学习 > 模型压缩与训练 |
| 核心技术 | 软标签蒸馏、特征对齐、注意力蒸馏、关系蒸馏、自蒸馏 |
| 主要应用 | 端侧大模型、LLM 蒸馏、低成本推理、知识继承、模型小型化 |
四、历史时间线
20 世纪 90 年代:神经网络集成学习(Ensemble)与「暗知识(dark knowledge)」思想萌芽
- 2015 年:Hinton 等发表《Distilling the Knowledge in a Neural Network》,系统化提出软标签蒸馏框架
- 2016-2018 年:FitNets、Attention Transfer 等引入中间层特征对齐与注意力蒸馏,应用于图像分类与机器翻译
- 2019-2020 年:关系蒸馏、对抗蒸馏、多教师蒸馏等变体成熟;与神经架构搜索结合形成自动化小型化流水线
- 2021-2022 年:Transformer 大模型兴起,DistilBERT、TinyBERT 等把千亿参数模型能力迁移到亿级模型成为开源标配
- 2023-2024 年:LLM 蒸馏成为开源小模型追赶闭源大模型的关键路径;多阶段课程式蒸馏 + 数据蒸馏显著提升复杂推理表现
五、分类
按知识形式:软标签蒸馏(输出分布)vs 特征蒸馏(中间层表征)vs 关系蒸馏(样本间关系)vs 自蒸馏(模型自迭代)
- 按师生数量:单教师蒸馏 vs 多教师集成蒸馏 vs 互助蒸馏(多学生互学习)
- 按训练范式:离线蒸馏(教师固定)vs 在线蒸馏(教师与学生同步更新)vs 自蒸馏
- 按应用场景:CV 模型蒸馏(MobileNet、ShuffleNet)vs NLP 模型蒸馏(DistilBERT、TinyBERT)vs LLM 蒸馏(DeepSeek 蒸馏、Llama 蒸馏)
- 按目标设备:云端蒸馏(提升吞吐)vs 端侧蒸馏(移动端、嵌入式)vs 边缘蒸馏(IoT 设备)
六、应用场景
- 端侧大模型部署:把千亿参数大模型蒸馏到十亿级,使 AI PC、手机、车机等端侧设备具备大模型能力
- 低成本云端推理:服务侧用蒸馏后的中等规模模型替代大模型,显著降低单位推理算力开销
- 领域模型小型化:在医疗、法律、金融等垂直领域,把通用大模型蒸馏为针对特定任务的轻量专家模型
- 多语言模型迁移:把英语等多资源语言大模型蒸馏为低资源语言模型,缓解语种不平衡
- 实时对话与高频调用:在客服、搜索、推荐等高频场景中用蒸馏模型提供低延迟响应
- 隐私与离线可用:压缩后的模型可在本地设备运行,减少对外部推理服务的依赖
七、优缺点
- 优点:
- 部署成本下降:参数量可压缩到教师模型的 10%-30% 左右,推理显存与算力开销显著降低
- 响应延迟缩短:学生模型推理速度通常提升数倍,对实时对话与高频调用场景尤为关键
- 能力继承:在多数通用任务上可保留教师模型 90% 以上的性能,缩小能力落差
- 能耗与碳足迹降低:硬件资源消耗的减少直接转化为更低的电力与散热成本
- 缺点:
- 依赖教师模型质量:教师模型若存在偏差或能力短板,学生模型会继承并放大
- 训练成本仍较高:蒸馏本身仍需大量算力与数据准备,难以做到「零成本压缩」
- 任务适配受限:学生模型在新任务上的迁移能力通常弱于教师模型
- 架构敏感性强:学生模型架构与教师的匹配度对蒸馏效果影响显著
八、常见误区
- 蒸馏 = 剪枝(错:剪枝侧重删除冗余参数,蒸馏通过师生监督关系重建知识传递路径,二者是不同压缩范式)
- 蒸馏一定能保留教师能力(错:极端压缩比例下学生模型会出现明显能力损失,需在体积与能力间权衡)
- 蒸馏 = 模型量化(错:量化关注数值精度,蒸馏关注表征层面的信息迁移;二者常结合使用但目标不同)
- 蒸馏等于 LoRA 微调(错:LoRA 等参数高效微调改变的是任务适配而非模型规模,蒸馏改变的是模型本身的容量)
九、关联概念
父概念:大语言模型 Large Language Model、深度学习 Deep Learning、模型量化
- 子概念:LLM 蒸馏、小语言模型、模型量化、LoRA微调、Fine-tuning
- 兄弟概念:模型量化、模型剪枝、LoRA微调、Fine-tuning、小语言模型
- 对比概念:模型量化、LoRA微调、Fine-tuning
- 应用相关:边缘计算(Edge Computing)、AI PC、LLM 蒸馏、小语言模型、云原生