一、什么是稀疏注意力机制
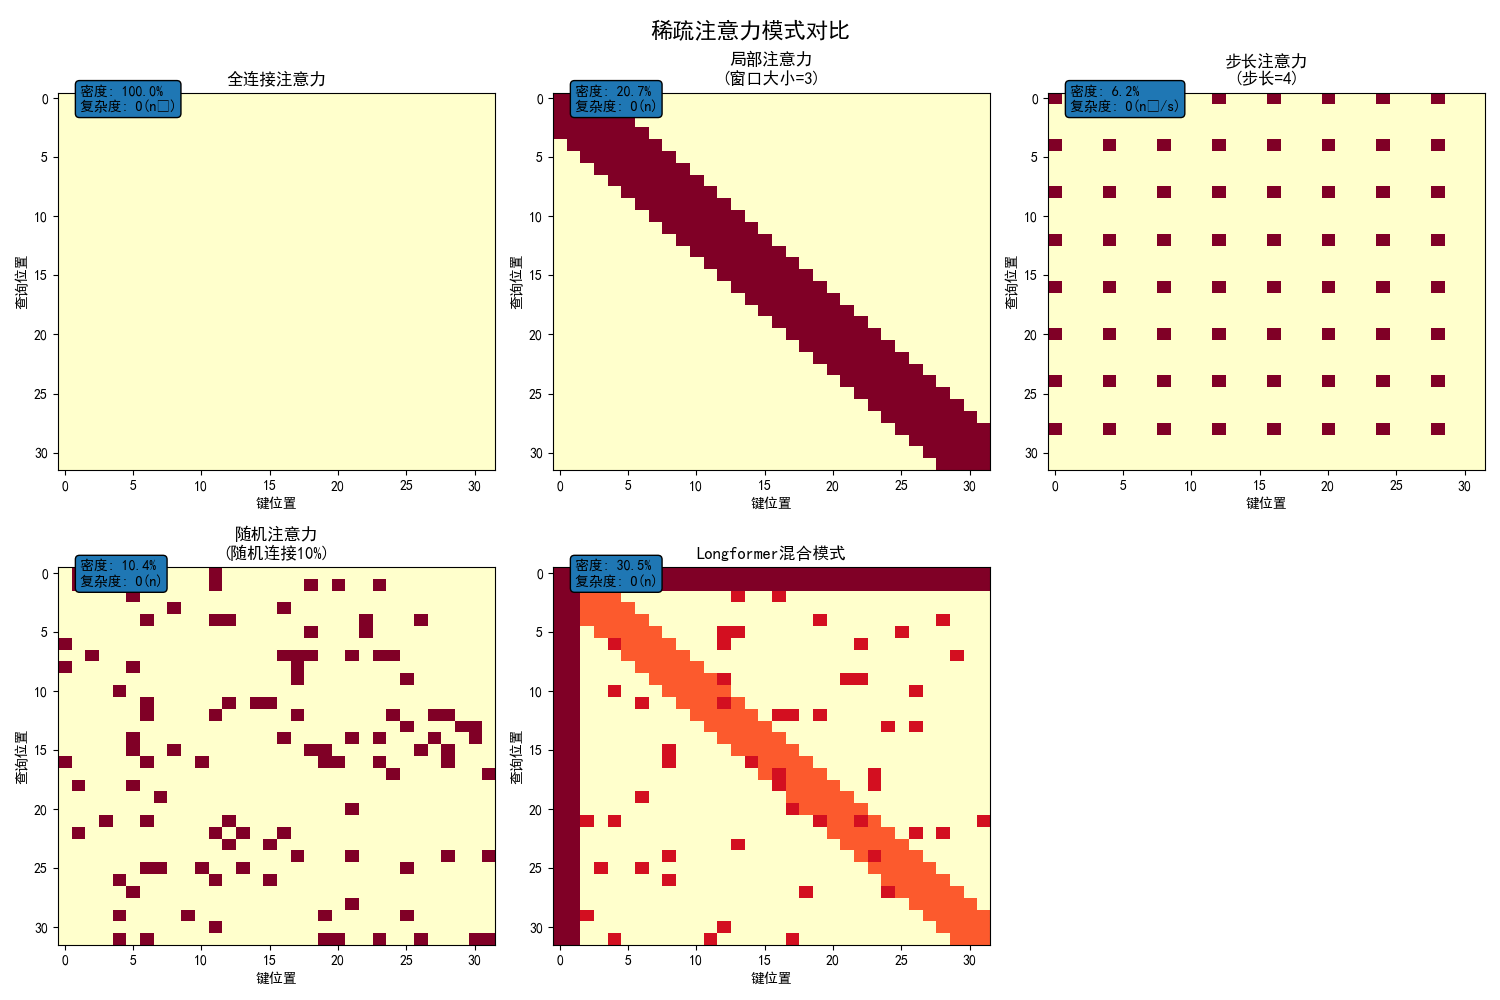
稀疏注意力机制(Sparse Attention Mechanism)是一类通过限制每个 token 仅与输入序列的特定子集计算注意力权重,从而将标准 Transformer 自注意力从二次方复杂度降至近似线性或对数级别的注意力变体。其核心思想是利用序列中存在的局部性、聚簇性或全局锚点等结构性先验,跳过大量冗余的 token-token 交互,保留关键位置之间的注意力连接。它主要解决长文本、长音频、长视频等场景下注意力计算量爆炸、显存占用过高、推理延迟过大等问题,使超长上下文建模成为可能。该机制已成为百万 token 上下文大模型架构设计的核心组件之一。
二、原理
1. 稀疏模式定义:基于局部性、全局性、随机性等先验,确定哪些 token 对之间需要计算注意力(固定模式或学习型模式) → 2. 局部注意力窗口:每个 token 仅与邻近若干 token 交互,捕获短距离依赖,计算代价与窗口大小成正比 → 3. 全局注意力节点:少量预设的全局 token 与序列中所有位置交互,承担信息汇聚与跨段传递职责 → 4. 块稀疏计算:以 token 块为粒度构建稀疏索引,结合 GPU 高效矩阵运算提升实际吞吐 → 5. 路由与聚簇:在动态稀疏方案中,根据内容相关性将查询路由到相关 key 集合,实现输入自适应稀疏化 → 6. 复杂度落地:在长序列下将 O(n²) 降至 O(n log n) 或 O(n√n),并通过算子融合减少访存开销
三、信息卡片
| 中文名 | 稀疏注意力机制 |
| 英文名 | Sparse Attention Mechanism |
| 缩写 | Sparse Attention |
| 别名 | 稀疏注意力、Sparse Self-Attention、长上下文注意力 |
| 提出者 | OpenAI(Sparse Transformer,2019)、Google(Longformer、BigBird)、Meta 等 |
| 提出时间 | 2019 年前后(Sparse Transformer、Longformer、BigBird 等代表性工作集中发表) |
| 所属类别 | AI 技术 > 深度学习 > Transformer 架构变体 |
| 核心技术 | 固定稀疏模式、滑动窗口、随机注意力、全局锚点、动态路由稀疏 |
| 主要应用 | 长上下文大模型、代码仓库理解、长文档问答、视频理解、音频建模 |
四、历史时间线
- 20 世纪 90 年代:序列建模中局部依赖与全局依赖分离的早期研究萌芽
- 2017 年:Transformer 论文发表后不久,研究者注意到全注意力在长序列下的可扩展性瓶颈
- 2019 年:OpenAI Sparse Transformer、Child et al. 提出可分解注意力,将可处理序列长度提升一个数量级
- 2020 年:Google Longformer、BigBird 引入滑动窗口 + 全局 token + 随机注意力的混合稀疏模式
- 2020-2022 年:Linear Attention(核近似)、Routing Transformer(聚簇稀疏)、Reformer(LSH 敏感哈希)等并行发展
- 2023-2024 年:支持百万 token 上下文的需求爆发,稀疏注意力与滑动窗口、分块 KV 缓存深度结合,成为长上下文模型事实标配
- 2025 年:与 MoE 混合专家模型、模型上下文窗口等共同构成超长上下文架构组件库
五、分类
按稀疏模式来源:固定模式(Fixed Pattern,如 Longformer)vs 学习模式(Learned Pattern)vs 随机模式(Random,如 BigBird)
- 按结构组成:滑动窗口 + 全局 token(Longformer 风格)vs 块稀疏 + 随机(BigBird 风格)vs 聚簇路由(Routing Transformer 风格)
- 按动态性:静态稀疏(模式在训练前固定)vs 动态稀疏(模式随输入变化,如 Routing)
- 按与标准注意力的关系:精确稀疏(保留 softmax,如 Longformer)vs 近似稀疏(采用核近似,如 Linear Attention)
- 按应用层次:语言模型稀疏注意力、视觉 Transformer 稀疏注意力、多模态稀疏注意力
六、应用场景
长上下文大模型:把可处理序列长度从数千 token 扩展到十万至百万级,支撑长文档、代码仓库、视频等场景
- 代码仓库理解:辅助 Cursor、Copilot 等工具理解跨文件依赖,跨数十万行代码进行推理
- 长文档问答:法律文档分析、医学文献综述、研报分析等需要数十万 token 上下文的场景
- 视频与音频建模:在视觉 Transformer 中以时空稀疏注意力降低帧间计算密度
- 检索与 RAG 增强:在 RAG · 检索增强生成 中处理长检索结果拼接的注意力开销
- 推理优化:与 KV 缓存分页(PagedAttention)结合,显著降低长上下文推理的显存占用
七、优缺点
- 优点:
- 长上下文可行性:将可处理序列长度从数千 token 扩展到十万至百万级
- 推理效率提升:注意力计算量降低典型 50%-80% 左右,显著缩短响应时间
- 显存占用下降:长序列下的 KV 缓存开销随稀疏模式显著减少
- 训练成本节约:在预训练阶段减少冗余计算,使训练更长上下文模型在经济上可行
- 缺点:
- 稀疏模式设计复杂:固定模式难以适配所有任务,动态模式引入额外学习成本
- 长距离依赖建模受限:纯窗口稀疏在跨段全局推理上仍弱于全注意力
- 工程实现门槛高:块稀疏、自定义 CUDA 算子等需要深度工程优化
- 任务迁移性差异大:不同任务对稀疏模式的偏好不同,调参成本较高
八、常见误区
稀疏注意力 = 线性注意力(错:稀疏注意力通常保留精确 softmax 计算,线性注意力采用核函数近似,思路不同)
- 稀疏注意力适合所有任务(错:短文本场景下密集注意力更优;稀疏注意力的优势主要在长序列)
- 稀疏注意力等于滑动窗口(错:滑动窗口只是稀疏模式之一,全局 token、随机、聚簇等也是常见组合)
- 稀疏注意力无信息损失(错:极端稀疏会丢失跨段全局信息,需要全局锚点或多跳补偿)
九、关联概念
父概念:Transformer架构、大语言模型 Large Language Model、深度学习 Deep Learning
- 子概念:模型上下文窗口、MoE · MoE混合专家模型、向量检索
- 兄弟概念:Transformer架构、模型上下文窗口、MoE · MoE混合专家模型、强化学习、推理模型
- 对比概念:Transformer架构、模型上下文窗口、MoE · MoE混合专家模型
- 应用相关:RAG · 检索增强生成、Self-RAG、图增强检索增强生成、大语言模型 Large Language Model、Reasoning Model · 推理模型