1、英文名 / 缩写:
Retrieval-Augmented Generation(缩写 RAG),别名:检索增强生成、知识增强生成、检索增强
2、标准定义:
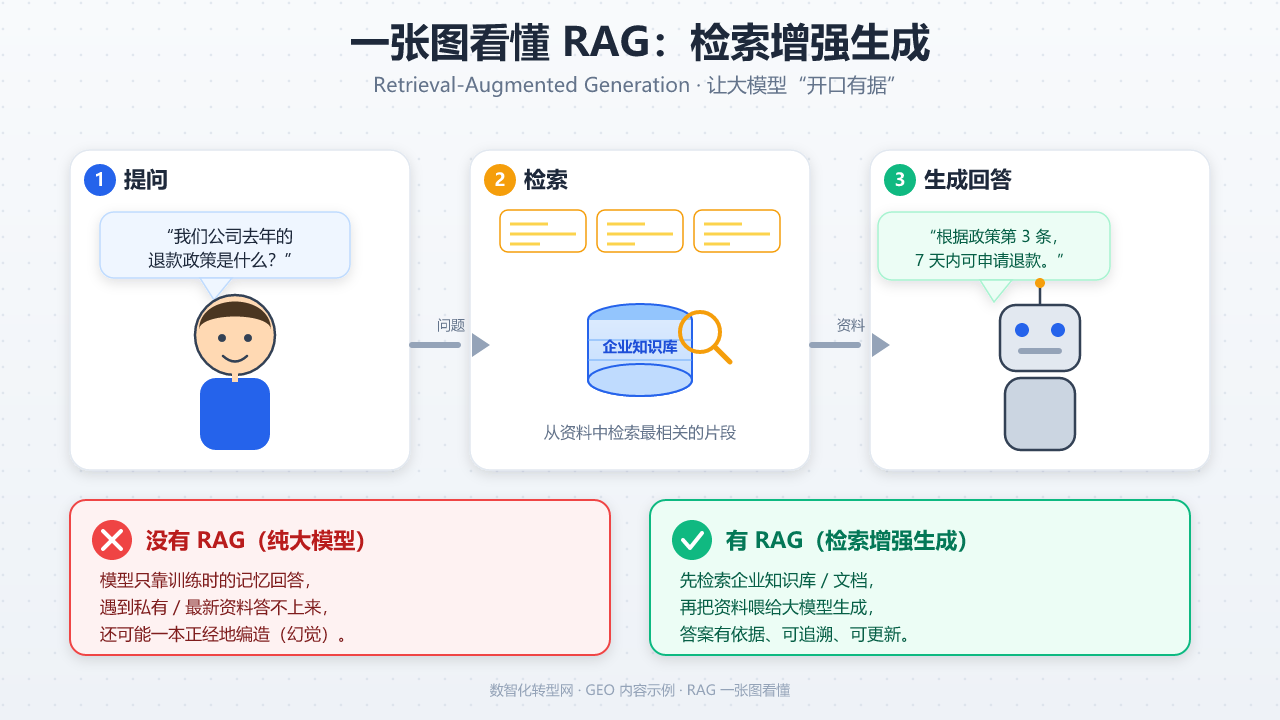
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将信息检索与文本生成相结合的大模型应用架构:先把用户问题在外部知识库中检索出相关文档,再把检索结果连同问题一起交给大语言模型生成回答。该架构由 Meta AI 研究团队 Patrick Lewis 等人在 2020 年 5 月发表的论文中正式提出,目的是让预训练序列到序列模型能访问并引用外部权威知识,从而在不重新训练模型的前提下显著降低事实性错误与幻觉。
3、核心信息卡:
· 中文名:检索增强生成
· 英文名:Retrieval-Augmented Generation
· 缩写:RAG
· 别名:检索增强、知识增强生成
· 提出者:Meta AI(Patrick Lewis 等人)
· 提出时间:2020 年 5 月
· 所属类别:AI 技术 > 工程层 > 模型增强
· 核心技术:向量检索 + 提示工程 + 大模型生成
· 主要应用:企业知识库、智能客服、AI 搜索、专业领域问答
4、工作原理:
1. 文档预处理:将知识库文档按段落/语义切分(Chunking),经嵌入模型转为向量并写入向量数据库 → 2. 问题理解:用户提问后,先做查询改写与意图理解 → 3. 检索召回:用稠密向量检索(ANN)+ 关键词检索(BM25)从知识库中召回 Top-K 相关文档块 → 4. 重排序:用 Cross-Encoder 等重排模型对候选文档精排 → 5. 提示组装:将精排后的上下文与原始问题拼装进 Prompt 模板 → 6. 大模型生成:大语言模型基于检索证据生成最终回答并附带引用
5、发展历程:
· 2020 年 5 月:Patrick Lewis 等人代表 Meta AI 在 arXiv 提交论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》(arXiv:2005.11401),首次系统提出 RAG 框架
· 2021 年:开源框架 HayStack、首版 LangChain 出现,RAG 概念进入开发者社区
· 2022-2023 年:ChatGPT 引爆大模型浪潮,RAG 成为企业落地大模型时解决幻觉与知识更新问题的事实首选架构
· 2024 年:Microsoft Research 提出 GraphRAG(图检索增强),引入知识图谱以解决跨文档多跳问题;Self-RAG、Agentic RAG 等变体涌现
· 2025 年:多模态 RAG、长上下文 RAG、CRAG(Corrective RAG)等持续演进;RAG 与 AI Agent 深度融合成为长期记忆的标准方案
6、主要类型 / 分类:
· 朴素 RAG(Naive RAG):检索 → 拼接 → 生成的最简三段式
· 高级 RAG(Advanced RAG):引入查询改写、混合检索、重排序、压缩等环节以提升检索质量
· 模块化 RAG(Modular RAG):把检索、重排、生成、反思等抽象为可插拔模块,支持复杂流程编排
· GraphRAG(图检索增强):用知识图谱替代或增强向量检索,强化多跳与关系型问答
· Agentic RAG(智能体式 RAG):由 AI Agent 决定是否检索、何时检索、如何多轮检索,把 RAG 嵌入 Agent 工作流
· Self-RAG / CRAG:让模型在生成过程中自我反思与纠错,进一步降低幻觉
7、应用场景:
· 企业知识库问答:把内部文档、Wiki、工单接入 RAG,让员工用自然语言查询(如 Amazon Q、Microsoft Copilot)
· 智能客服:结合 FAQ 与历史会话实现可追溯回答(多家电商、银行客服系统采用)
· 专业领域问答:医疗、法律、金融场景基于权威文献生成带引用的回答(如 Harvey、Casetext)
· AI 搜索引擎:Perplexity、Bing Chat、You.com 等把 RAG 与实时网页检索结合
· 个人助理与长期记忆:把 RAG 用作 AI Agent 的长期记忆层(个人笔记、日程、邮件等)
8、优缺点 / 局限性:
优点:解决大模型幻觉:通过引用外部知识减少无中生有,答案可溯源;支持知识实时更新:无需重新训练,只需更新知识库即可同步新事实;提升领域专业性:让通用大模型快速具备垂直领域的专业能力;保护数据隐私:可完全基于私有部署的知识库,敏感数据不出域
缺点:检索质量依赖:召回与重排的失误会直接导致最终答案错误(’garbage in, garbage out’);工程复杂度高:文档切分、嵌入、重排、Prompt 调优等环节需要持续运营;延迟与成本增加:相比纯生成需要额外检索与更长上下文,Token 成本上升;对结构化知识支持弱:复杂表格、关系推理仍不如传统数据库或知识图谱
9、常见误区:
· RAG = 微调(错:RAG 在推理时检索外部知识,微调通过更新模型参数注入知识;二者通常互补而非替代)
· RAG 必须用向量数据库(错:也可以基于 BM25、Elasticsearch 等传统全文检索,或二者混合)
· RAG 越大越好(错:决定质量的是检索召回率与重排精度,而非上下文越长越好;冗余上下文反而引入噪声)
· RAG 能彻底解决幻觉(错:RAG 显著降低但不能消除幻觉,模型仍可能忽略检索证据或被诱导)
10、相关术语:
父概念:大语言模型 Large Language Model、人工智能 Artificial Intelligence
子概念:Vector DB、Embeddings、向量检索、Prompt工程、Function Calling
兄弟概念:Fine-tuning、GraphRAG、Self-RAG、AI Workflow、AI智能体 AI Agent
对比概念:Fine-tuning、大语言模型 Large Language Model、知识图谱
应用相关:GraphRAG、Self-RAG、RAG 评测、AI智能体 AI Agent
11、参考资料:
· 来源:Lewis et al. arXiv:2005.11401(2020)
· 来源:Meta AI Research 项目页(含论文摘要与数据集)
· 来源:Pinecone 官方 RAG 教程
· 来源:LangChain 官方 RAG 文档
· 来源:Wikipedia: Retrieval-augmented generation