1、英文名 / 缩写:
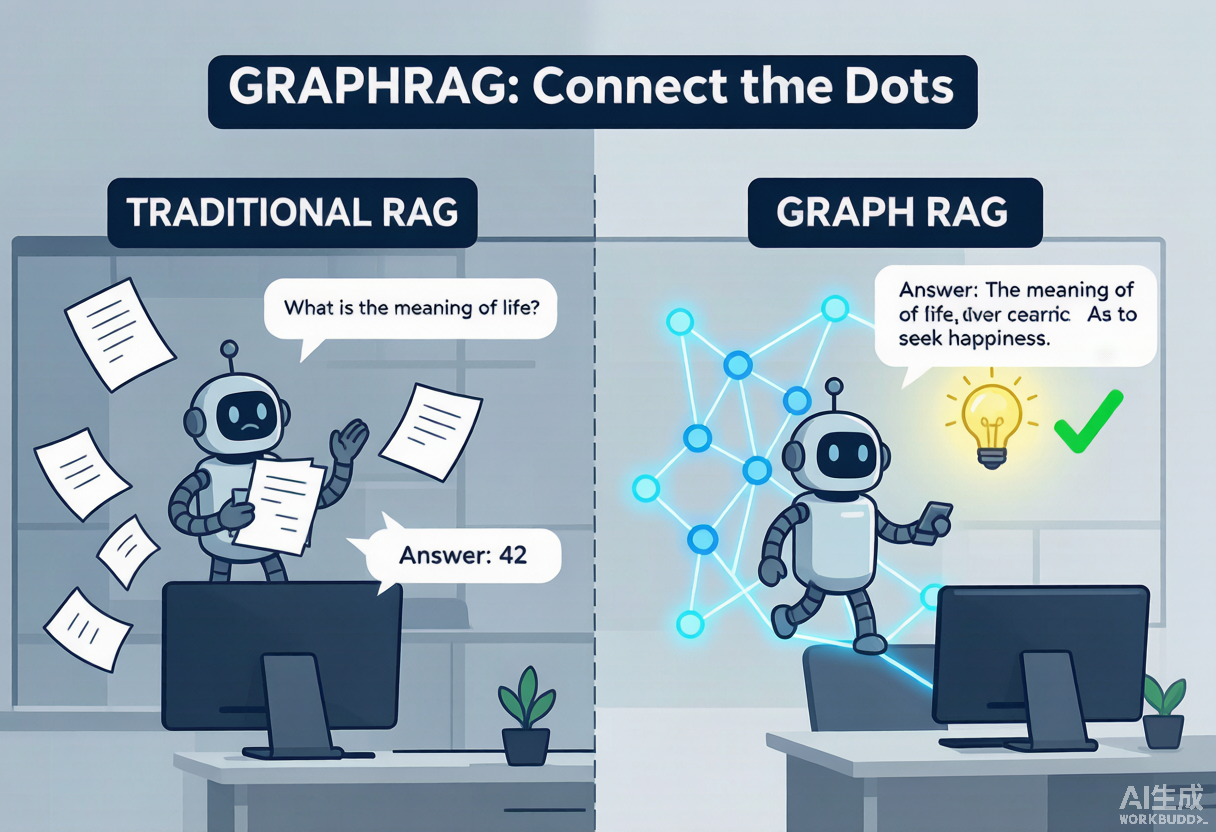
Graph-based Retrieval-Augmented Generation(缩写 GraphRAG),别名:图检索增强生成、图增强 RAG、知识图谱 RAG
2、标准定义:
GraphRAG(Graph-based Retrieval-Augmented Generation,图检索增强生成)是 RAG 技术的演进形态之一,它在传统向量检索的基础上引入知识图谱或图结构索引,把文档、实体、关系、子图作为检索单位,让大语言模型在生成回答时能够借助结构化的实体关系与多跳推理信息。与传统向量 RAG 在「文档块」层面检索不同,GraphRAG 在「实体—关系—子图」层面检索,显著提升对跨文档关联、全局性问题与多跳推理的回答质量与可解释性。Microsoft Research 于 2024 年发表的 GraphRAG 论文是其代表性工作。
3、核心信息卡:
· 中文名:图检索增强生成
· 英文名:Graph-based Retrieval-Augmented Generation
· 缩写:GraphRAG
· 别名:图检索增强生成、图增强 RAG、知识图谱 RAG
· 提出者:Microsoft Research(Edge 等,2024 年 4 月论文);理念源自知识图谱 + RAG 社区融合
· 提出时间:2024 年 4 月(Microsoft Research 开源参考实现)
· 所属类别:AI 技术 > 工程层 > 模型增强 > 检索增强生成
· 核心技术:知识图谱构建(实体识别、关系抽取)、图索引(Leiden 社区检测)、图向量混合检索、子图采样
· 主要应用:企业知识库问答、复杂多跳推理、调研报告生成、合规与法务场景、GraphRAG 全局摘要
4、工作原理:
1. 文档预处理:把原始文档通过 LLM 进行实体抽取、关系抽取与摘要,构造(实体—关系—实体)三元组 → 2. 图谱构建:用图数据库存储三元组,并构建 Leiden/Louvain 社区划分 → 3. 双索引生成:同时构建实体/关系的向量索引(用于语义检索)与图结构索引(用于多跳遍历) → 4. 查询理解:对用户问题做意图识别,决定是走「局部检索」还是「全局 Map-Reduce」 → 5. 图检索召回:先检索相关实体与子图,再沿关系边做 1-3 跳扩展,召回结构化上下文 → 6. Prompt 组装与大模型生成:把图谱证据与原始问题拼装进 Prompt,由大模型生成带引用的回答
5、发展历程:
· 2023 年:Microsoft Research 内部项目探索「在 RAG 中引入图结构」的可行性,源于传统向量 RAG 在跨文档多跳问题上的失败案例
· 2024 年 4 月:Microsoft Research 在 GitHub 开源 GraphRAG 参考实现并发布配套论文,引入 Leiden 社区检测与 Map-Reduce 全局摘要机制
· 2024 年中:Neo4j、LlamaIndex、LangChain 等社区陆续推出集成方案,GraphRAG 成为 RAG 进阶的事实标杆
· 2024 年底:衍生出 LightRAG(轻量化)、KAG(蚂蚁集团,结合知识图谱与 KG 推理)、Pathway 等变体
· 2025 年:GraphRAG 与 AI Agent 工作流深度结合,形成 Agentic GraphRAG;同时与图数据库、向量数据库混合架构成为企业首选
6、主要类型 / 分类:
· 按索引形态:实体级 GraphRAG(以节点为中心)vs 文档级 GraphRAG(以文档为节点)vs 社区级 GraphRAG(以社区检测结果为粒度)
· 按图谱来源:自动构建型(LLM 抽取三元组)vs 外部知识库型(接入 Wikidata、企业 KG)vs 混合型
· 按查询模式:Local Search(局部子图检索,适合具体实体问题)vs Global Search(Map-Reduce 全局摘要,适合宏观分析问题)
· 按实现路径:开源实现(Microsoft GraphRAG、LightRAG)、框架集成(LlamaIndex PropertyGraph、LangChain Neo4j)、商业平台(Neo4j + LLM、蚂蚁 KAG)
· 按推理深度:单跳关系查询 vs 多跳路径推理 vs 社区级聚合推理
7、应用场景:
· 企业知识库与全局摘要:把多份非结构化文档接入 GraphRAG,生成跨文档的主题摘要与全局洞察(Microsoft GraphRAG 官方案例)
· 复杂多跳问答:法律案件关联、科研文献综述、医疗诊断推理等需要多跳事实链接的场景
· 调研报告与情报分析:金融研报、竞争情报、政策分析等需要跨文档聚合的领域
· RAG 增强型 Agent:让 AI Agent 在长程任务中持久维护实体关系,作为结构化长期记忆
· 合规与法务:基于图谱的法律条文-案例-事实关联检索,提升合规问答准确度
8、优缺点 / 局限性:
优点:解决多跳推理:相比纯向量 RAG,能显式建模实体间关系,应对「A 与 B 的合作公司」类多跳问题;全局性更强:通过 Leiden 社区与 Map-Reduce,能生成跨文档的全局性总结而非孤立答案;可解释性高:检索路径是显式的图边,便于人工审计与可追溯;降低幻觉:实体-关系-来源三元组让模型更容易引用结构化证据
缺点:构建成本高:实体/关系抽取依赖 LLM 调用,预处理 Token 成本显著高于纯向量 RAG;图维护复杂:知识更新时需要增量更新图谱,社区检测重算成本不低;延迟较高:相比向量 ANN 检索,图遍历与多跳扩展增加推理延迟;对图谱质量敏感:实体抽取错误会沿关系链传播,’garbage in, garbage out’ 效应更明显
9、常见误区:
· GraphRAG = 知识图谱(错:知识图谱是数据结构与基础设施,GraphRAG 是基于图谱的 RAG 应用架构;二者是层与层的关系)
· GraphRAG 一定优于向量 RAG(错:对于单跳事实问答,纯向量 RAG 反而更快更便宜;GraphRAG 在多跳与全局性问题才显优势)
· GraphRAG 取代传统 RAG(错:GraphRAG 与 Self-RAG、Agentic RAG 等是互补关系,混合架构(如向量+图)才是企业主流)
· GraphRAG 接入即生效(错:需要根据业务问题类型选择 Local/Global 模式,并持续治理图谱质量)
10、相关术语:
父概念:RAG · 检索增强生成、大语言模型 Large Language Model、知识图谱
子概念:知识图谱、向量检索、Vector DB、Embeddings、RAG 评测
兄弟概念:RAG · 检索增强生成、Self-RAG、AI Workflow、Agentic Workflow、图增强检索增强生成
对比概念:RAG · 检索增强生成、知识图谱、Self-RAG、Agentic Workflow
应用相关:RAG · 检索增强生成、Self-RAG、知识图谱、RAG 评测、AI智能体 AI Agent
11、参考资料:
· 来源:Edge et al. 《From Local to Global: A Graph RAG Approach to Query-Focused Summarization》arXiv:2404.16130(2024)
· 来源:Microsoft Research GraphRAG GitHub 项目
· 来源:Neo4j + LLM 集成文档
· 来源:LlamaIndex Property Graph Index 文档
· 来源:LangChain Neo4j 集成文档