1、英文名 / 缩写:
Large Language Model(缩写 LLM),别名:大模型、语言大模型、LLM
2、标准定义:
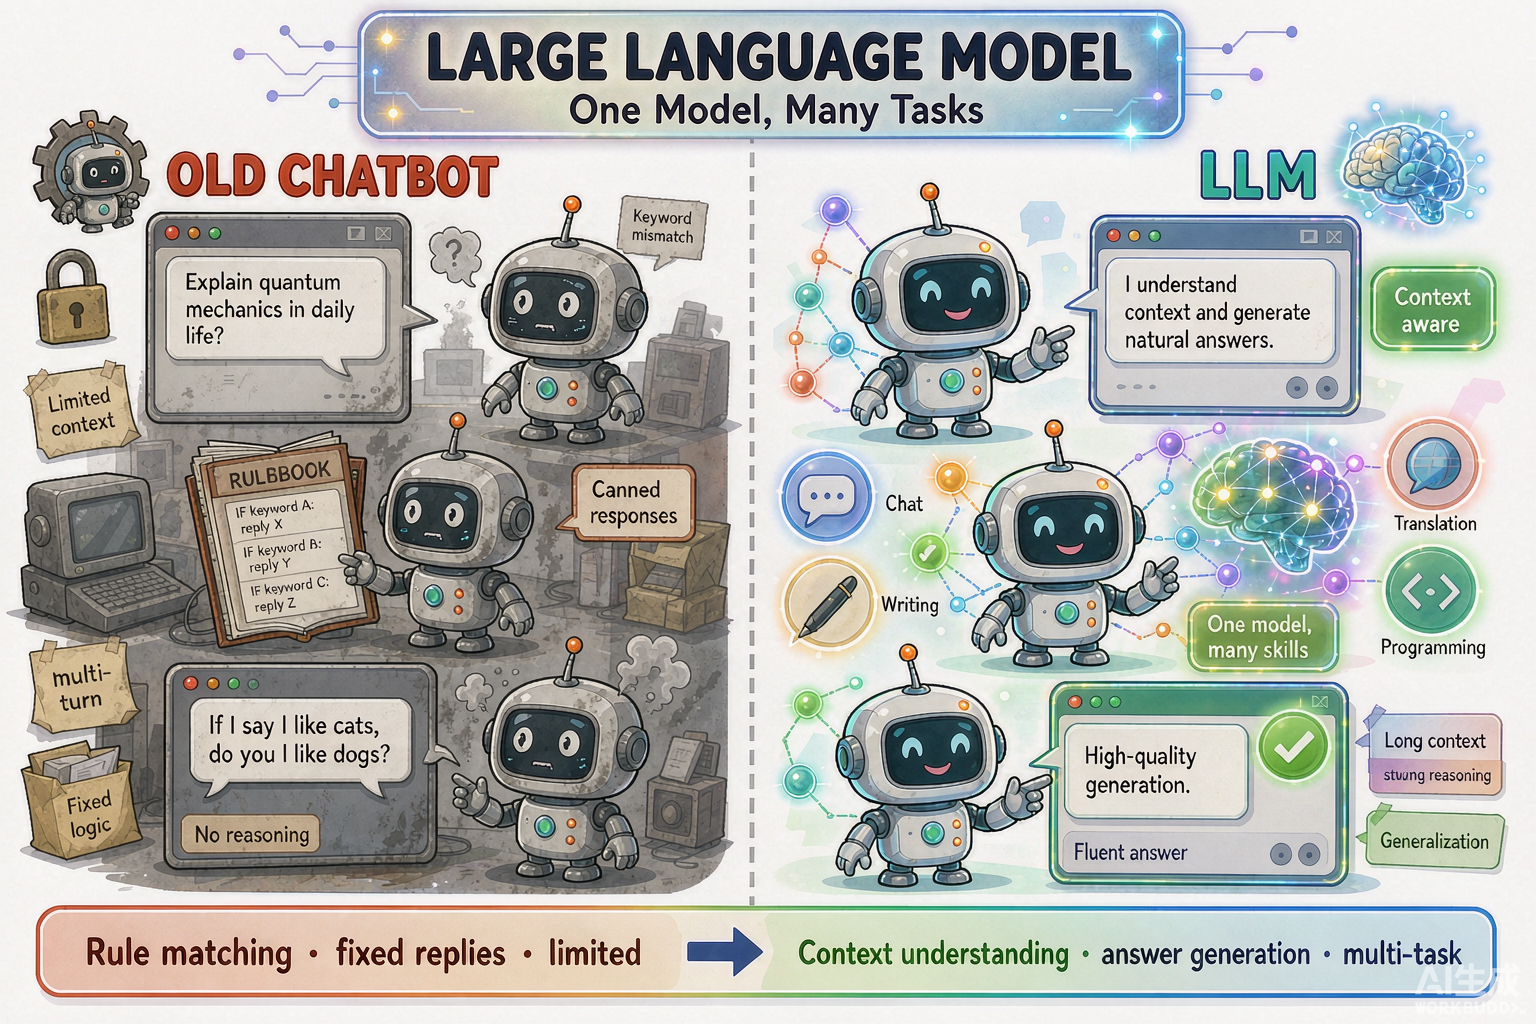
大语言模型(Large Language Model,LLM)是基于海量语料预训练得到的、参数规模达数百亿至数千亿级别的深度学习模型,通常采用 Transformer架构,通过预测下一个 token 的方式学习语言与世界知识,具备强大的语言理解、文本生成、逻辑推理与跨任务泛化能力。代表模型包括 OpenAI GPT 系列、Anthropic Claude、Google Gemini、Meta Llama、阿里通义、DeepSeek 等。LLM 是 AIGC · 人工智能生成内容、Agent、Function Calling、RAG · 检索增强生成 等企业级 AI 应用的事实底座,也是当前 AGI · 通用人工智能 探索的主要载体。
3、核心信息卡:
| 中文名 | 大语言模型 |
| 英文名 | Large Language Model |
| 缩写 | LLM |
| 别名 | 大模型、语言大模型、LLM |
| 提出者 | 架构奠基:Google(Transformer,2017);GPT 系列:OpenAI;开源代表:Meta(Llama)、Mistral、阿里(Qwen)、DeepSeek |
| 提出时间 | 2017 年(Transformer);2018 年(GPT-1、BERT);2020 年(GPT-3 展现涌现能力);2022 年(ChatGPT 引爆) |
| 所属类别 | AI 技术 > 深度学习 > 自然语言处理 > 预训练大模型 |
| 核心技术 | Transformer、自监督预训练、指令微调 SFT、RLHF人类反馈强化学习 / DPO直接偏好优化、MoE · MoE混合专家模型、推理时计算(CoT、Reasoning Model · 推理模型) |
| 主要应用 | 智能客服、AI 搜索、企业知识库、代码生成、AI 写作、AI 翻译、AI Agent 与 Function Calling |
4、工作原理:
1. 预训练:在万亿级 token 语料上以「预测下一个 token」为损失进行自监督训练,学习语言结构与世界知识 → 2. 指令微调(SFT):用人工编写的指令-响应对微调模型,使其对齐人类意图与对话格式 → 3. 偏好对齐:通过 RLHF人类反馈强化学习 或 DPO直接偏好优化 用人类偏好数据进一步对齐,让输出更符合期望 → 4. 推理增强:通过 Prompt工程、思维链 CoT、ReAct框架 与工具调用(Function Calling)扩展模型解决复杂问题的能力 → 5. 部署与压缩:将模型通过 LLM 蒸馏、模型量化 压缩到消费级或端侧设备,或以 API 形式对外服务 → 6. 应用编排:通过 RAG · 检索增强生成、AI智能体 AI Agent、多智能体系统 等架构构建企业级应用
5、发展历程:
· 2017 年:Google 提出 Transformer架构,奠定现代 LLM 的结构基础
· 2018 年:OpenAI 发布 GPT-1,Google 发布 BERT,预训练-微调范式成为 NLP 主流
· 2020 年:GPT-3(175B 参数)展现 Few-shot 涌现能力,证明「规模即能力」
· 2022 年 11 月:OpenAI 发布 ChatGPT,引爆大模型与 AIGC · 人工智能生成内容 全球浪潮
· 2023 年:GPT-4、Claude 2、Gemini、通义千问、文心一言、Llama 2 集中发布,开源与闭源生态并行
· 2024 年:GPT-4o、Claude 3.5、Gemini 1.5 进入多模态时代;o1、DeepSeek-R1 等 Reasoning Model · 推理模型 引入大规模 RL
· 2025 年:MoE · MoE混合专家模型(DeepSeek V3)、端侧小模型、多模态 Agent 推动 LLM 工业化落地
6、主要类型 / 分类:
· 按架构密度:Dense 模型(GPT-3、LLaMA)vs MoE · MoE混合专家模型(Mixtral、DeepSeek-V3)
· 按模态:纯文本 LLM、多模态 LLM(视觉-语言、语音-语言、视频-语言)
· 按能力层级:基础 LLM、指令微调 LLM、对话 LLM(Chat LLM)、Agent LLM、Reasoning Model · 推理模型
· 按部署形态:云端闭源 API(GPT、Claude、Gemini)、开源权重(Llama、Qwen、DeepSeek)、端侧 LLM(AI PC、本地推理)
· 按行业领域:通用 LLM、领域 LLM(医疗、金融、法律、教育)、企业定制 LLM(Fine-tuning 后)
7、应用场景:
· 智能客服与对话系统:基于 LLM 的 7×24 小时问答、工单自动化(替代传统 NLP · 自然语言处理 流水线)
· AI 搜索与知识库:通过 RAG · 检索增强生成 把企业私域知识接入 LLM,提升专业问答与可追溯性
· AI 写作与内容生成:营销文案、新闻摘要、报告撰写、代码生成(与 AIGC · 人工智能生成内容 融合)
· AI Agent 与自动化:Function Calling + 工具调用让 LLM 自主完成多步骤业务任务(Coze智能体平台、Dify 等)
· 代码与研发辅助:代码补全、Bug 定位、测试生成、代码审查(GitHub Copilot、通义灵码等)
· 行业大模型:医疗、法律、金融、政务等垂直领域通过 Fine-tuning 与领域知识微调提升专业度
8、优缺点 / 局限性:
优点:通用能力强:单一模型可处理翻译、写作、问答、推理、代码等多种任务,泛化性突出;涌现能力:参数与数据规模达到临界点后出现少样本推理、思维链等新能力;对齐可控:通过 RLHF / DPO 让模型行为更符合人类偏好与安全规范;生态成熟:Hugging Face、LangChain、LlamaIndex 等开源生态快速放大工程红利
缺点:推理成本高:千亿级模型单次推理算力与延迟均较高,需 LLM 蒸馏、模型量化 才能降低成本;存在幻觉:大模型可能编造事实或引用错误来源,企业落地需 RAG · 检索增强生成 兜底;可解释性弱:内部决策难以追溯,金融、医疗等场景需配合 AI安全 与评测体系;数据与算力依赖:高质量语料与 GPU 集群 仍是硬门槛,中小企业面临成本压力
9、常见误区:
· LLM = GPT(错:LLM 是技术范式统称,开源 Llama、Qwen、DeepSeek 等也属于 LLM)
· LLM 越大越聪明(错:能力受数据质量、对齐方法、推理策略等多因素影响)
· LLM 等同于 AGI · 通用人工智能(错:当前 LLM 仍缺乏持续学习、因果推理与世界模型,与 AGI 有本质差距)
· LLM 能直接替代企业知识库(错:必须配合 RAG · 检索增强生成、Function Calling、Fine-tuning 等工程链路才能落地)
10、相关术语:
父概念:深度学习 Deep Learning、NLP · 自然语言处理、人工智能 Artificial Intelligence
子概念:MoE · MoE混合专家模型、Function Calling、Embeddings、Reasoning Model · 推理模型、小语言模型
兄弟概念:多模态人工智能、AIGC · 人工智能生成内容、Reasoning Model · 推理模型
对比概念:传统 NLP、小语言模型、判别式AI
应用相关:RAG · 检索增强生成、AI智能体 AI Agent、Fine-tuning、LLM 蒸馏、模型量化
11、参考资料:
· 来源:Vaswani et al. 《Attention Is All You Need》NIPS 2017(Transformer 原始论文)
· 来源:Brown et al. 《Language Models are Few-Shot Learners》GPT-3 论文 arXiv:2005.14165(2020)
· 来源:OpenAI ChatGPT 官方介绍页
· 来源:Hugging Face 开源 LLM Hub
· 来源:中国信通院《大模型白皮书》