1、英文名 / 缩写:
Model Quantization(缩写 Quantization),别名:量化、精度压缩、INT8/INT4 量化
2、标准定义:
模型量化(Model Quantization)是将模型参数与计算从高精度浮点(FP32/FP16)映射到低精度整数(INT8/INT4)或更低比特的过程,目的是压缩模型体积、加速推理、降低显存与能耗,同时尽量保持模型精度。它是大模型走向低成本部署与端侧推理的关键技术之一,正在重塑 AI 推理成本结构。常见量化方案包括 PTQ(训练后量化)、QAT(量化感知训练)、GPTQ、AWQ、GGUF(llama.cpp)等。
3、核心信息卡:
· 中文名:模型量化
· 英文名:Model Quantization
· 缩写:Quantization
· 别名:量化、精度压缩、INT8/INT4 量化
· 提出者:学术:Jacob 等(2018);生态:NVIDIA(TensorRT-LLM)、Hugging Face(Optimum)、开源社区(llama.cpp、AutoGPTQ、AutoAWQ、BitsandBytes)
· 提出时间:2018 年(量化基础论文);2023-2025 年(GPTQ、AWQ、GGUF 等 LLM 量化方案爆发)
· 所属类别:AI 技术 > 模型压缩 > 精度压缩
· 核心技术:PTQ 训练后量化、QAT 量化感知训练、GPTQ、AWQ、GGUF、KV Cache 量化、混合精度
· 主要应用:端侧 LLM 部署、低成本推理服务、AI PC 与移动端、边缘计算、嵌入式 AI
4、工作原理:
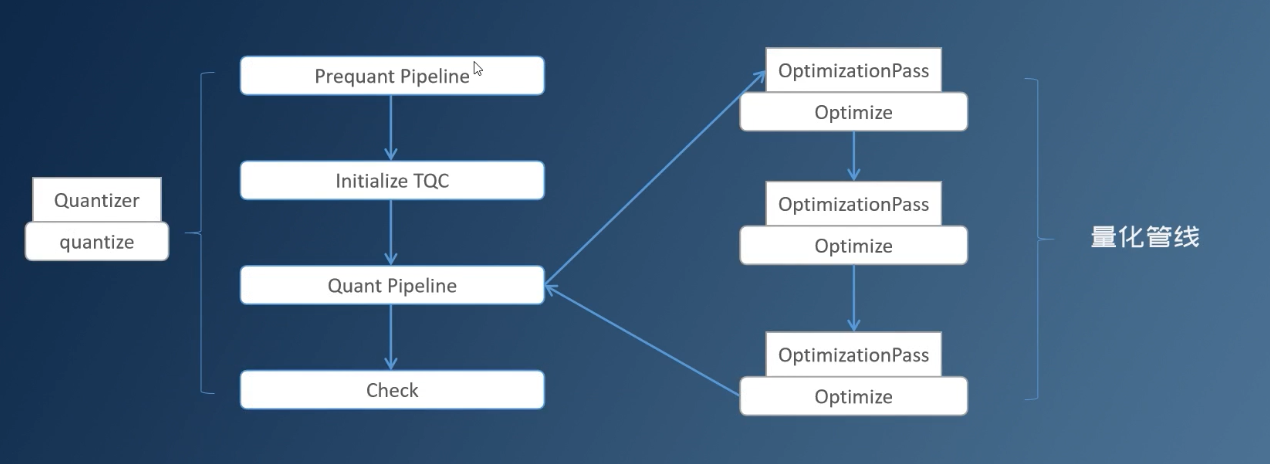
1. 精度映射:把 FP32/FP16 的权重与激活值映射到 INT8/INT4/FP8 等低精度数值范围 → 2. 校准数据准备:选定一组代表性校准数据用于统计激活分布 → 3. 量化方案选择:按部署硬件选择 PTQ(训练后量化)还是 QAT(量化感知训练),或选用 GPTQ/AWQ 等更优方案 → 4. 量化执行:用对称/非对称量化、Per-tensor/Per-channel 粒度执行缩放因子(Scale)与零点(ZeroPoint)计算 → 5. 精度评估:用困惑度(PPL)、下游任务准确率等指标评估量化损失 → 6. 推理部署:将量化模型部署到 GPU(TensorRT-LLM)、CPU(llama.cpp GGUF)或端侧 NPU,启用 INT4/INT8 推理
5、发展历程:
· 2018 年:Jacob 等提出量化基础论文《Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference》
· 2019-2021 年:BNN、INT8 推理在 CV 模型中普及;TensorRT、ONNX Runtime 提供原生 INT8 支持
· 2022-2023 年:GPTQ(2022)、AWQ(2023)、BitsandBytes 等 LLM 量化方案陆续开源,LLM 量化进入主流
· 2023-2024 年:GGUF(llama.cpp)格式让大模型在 Mac、CPU、消费级 GPU 上本地运行;端侧 LLM 兴起
· 2025 年:FP8 推理成为云端主流(H100/H200 原生 FP8);KV Cache 量化、Attention 量化、混合精度成为研究前沿
6、主要类型 / 分类:
· 按量化时机:PTQ(训练后量化)vs QAT(量化感知训练)vs 动态量化
· 按比特粒度:FP32 → FP16/BF16 → FP8 → INT8 → INT4 → INT2/1bit
· 按算法:对称/非对称、Per-tensor/Per-channel、GPTQ、AWQ、ZeroQuant、KV Cache 量化
· 按硬件:GPU 量化(TensorRT-LLM)、CPU 量化(GGUF/llama.cpp)、NPU 量化(端侧芯片)
· 按混合方式:权重量化 vs 激活量化 vs KV Cache 量化;混合精度推理
7、应用场景:
· 端侧 LLM 部署:把 7B-70B 模型量化到 INT4 后部署到 AI PC、手机、Mac(GGUF)、端侧 NPU
· 低成本推理服务:用 INT8 量化把单次推理成本降低 2-4 倍,显存占用减半
· 边缘计算 与嵌入式 AI:智能摄像头、自动驾驶、机器人等边缘场景的实时 AI 推理
· 云端大模型服务:用 FP8/INT8 量化降低单 token 推理成本,提升吞吐量
· 配合 LLM 蒸馏:先用 LLM 蒸馏 缩小模型,再 量化 进一步压缩,形成端到端压缩流水线
· 消费级显卡推理:让 8GB-24GB 消费级显卡能跑 70B 模型(AWQ、GPTQ)
8、优缺点 / 局限性:
优点:显著降低显存:INT4 相比 FP16 显存占用降低约 4 倍;提升推理速度:低精度算子吞吐更高,单 token 延迟降低 30-70%;降低能耗与成本:适配边缘设备与成本敏感场景;生态成熟:llama.cpp、TensorRT-LLM、AutoGPTQ、AutoAWQ 等工具链完善
缺点:存在精度损失:低比特量化可能引入 PPL 上升与下游任务掉点;校准数据敏感:PTQ 质量高度依赖校准集分布,校准不当会显著掉精度;推理框架绑定:不同格式(GGUF、GPTQ、AWQ)需匹配推理框架,生态碎片化;微调与对齐受限:量化模型再 Fine-tuning 时需 QAT,否则精度难以恢复
9、常见误区:
· 量化 = 压缩(错:模型量化 是精度压缩,与 LLM 蒸馏、剪枝属于不同维度的压缩,常配合使用)
· INT4 一定掉精度(错:GPTQ、AWQ 等高级算法在 INT4 下可保留 95%+ 原始能力)
· 量化只用于推理(错:QAT 量化感知训练把量化引入训练阶段,可显著降低精度损失)
· 量化模型不能继续训练(错:QLoRA 等方法可在量化模型上继续 Fine-tuning)
10、相关术语:
父概念:模型压缩、大语言模型 Large Language Model
子概念:PTQ 训练后量化、QAT 量化感知训练、GPTQ、AWQ、GGUF/llama.cpp
兄弟概念:LLM 蒸馏、模型剪枝、LoRA微调
对比概念:LLM 蒸馏、模型剪枝、FP16/BF16 训练
应用相关:AI PC、端侧 LLM、LLM 蒸馏、GPU 集群、TensorRT-LLM