一、什么是语音合成 TTS
TTS(Text-to-Speech,语音合成)是将文本自动转换为自然流畅语音输出的 AI 技术,经历了从拼接合成、参数合成到基于深度神经网络的端到端合成等多代技术演进。当前基于 Transformer 与扩散模型的神经 TTS 已能在音色自然度、情感表达、多语种、个性化音色克隆等方面接近真人水平。TTS 是智能客服、有声读物、虚拟主播、无障碍交互、语音交互产品等场景的核心技术,也是 GPT-SoVITS 等少样本音色克隆技术的重要支撑。
二、原理
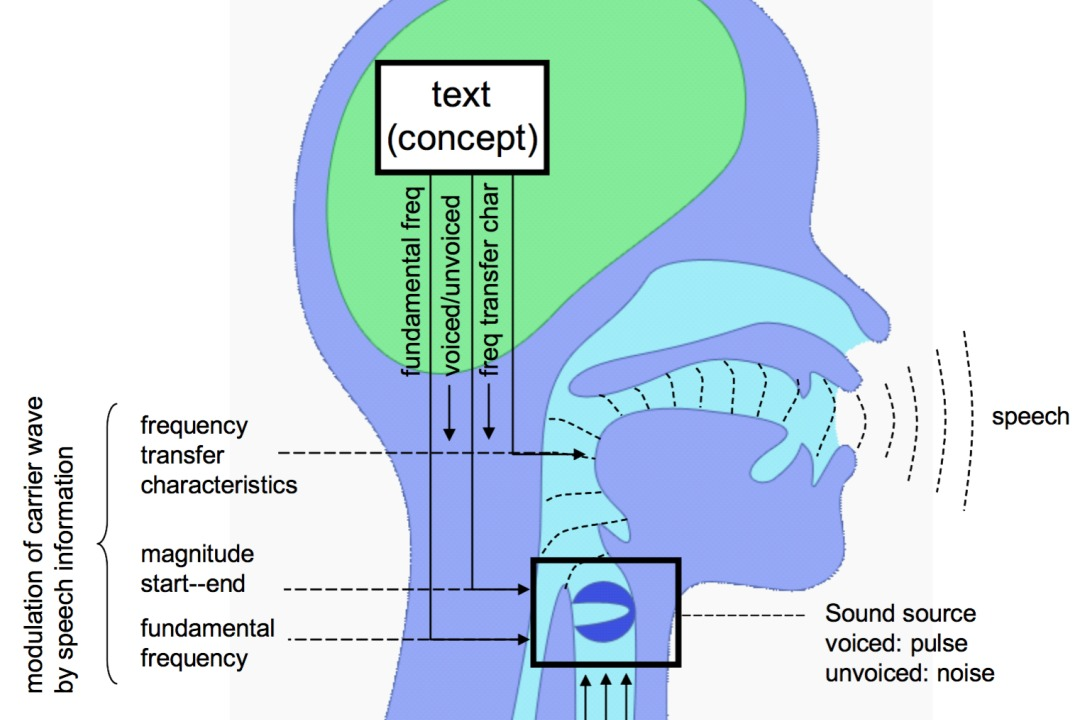
1. 文本分析 → 对输入文本进行分词、词性标注、多音字消歧、韵律预测(停顿、重音、语调) → 2. 声学模型 → 将文本特征(音素序列)转换为声学特征(梅尔频谱图),主流模型包括 Tacotron、FastSpeech、VITS → 3. 声码器 → 将声学特征(频谱图)转换为波形音频,HiFi-GAN 是当前主流方案 → 4. 音色与情感控制 → 通过参考音频(音色克隆)或情感标签控制合成声音的特性 → 5. 后处理 → 音频增强、噪声去除、响度标准化 → 6. 流式输出(可选)→ 对于实时场景,边合成边输出,延迟控制在数百毫秒内
三、信息卡片
| 中文名 | 语音合成 |
| 英文名 | Text-to-Speech Synthesis |
| 缩写 | TTS |
| 别名 | 语音合成、文本转语音、TTS |
| 提出者 | 学术研究:1980 年代 Bell Labs;工业落地:2017 年 WaveNet(DeepMind) |
| 提出时间 | 1980 年代(拼接合成商业化);2016-2017 年(WaveNet 神经 TTS 突破) |
| 所属类别 | AI 技术 > 语音 AI > 语音生成 |
| 核心技术 | 文本分析(分词/韵律预测)、声学模型(Tacotron/FastSpeech/VITS)、声码器(HiFi-GAN)、音色克隆 |
| 主要应用 | 智能客服、有声读物、虚拟主播、无障碍交互、语音导航 |
四、历史时间线
1980 年代:基于拼接合成的商业 TTS 系统(如 AT&T Bell Labs)成熟,但自然度有限
- 1990-2000 年代:参数合成(HMM-based TTS)替代拼接合成,音质有所提升但仍机械感强
- 2016-2017 年:DeepMind WaveNet 发布,神经声码器使合成音质大幅提升
- 2017-2018 年:Tacotron、Transformer TTS 等端到端模型相继出现,进一步提升自然度
- 2020-2022 年:VITS、NaturalSpeech 等模型将 TTS 质量推向更高水平
- 2023-2024 年:GPT-SoVITS 等少样本音色克隆走向大众,情感 TTS、低延迟流式 TTS 规模化
五、分类
按技术路线:拼接合成(早期)、参数合成(HMM-based)、端到端神经 TTS(Tacotron/FastSpeech/VITS)
- 按声码器类型:WaveNet 类(自回归)、GAN 类(HiFi-GAN)、Flow 类、Diffusion 类
- 按声音来源:标准音色(预训练通用声音)、定制音色(克隆)、多说话人模型
- 按控制维度:音色控制、语速控制、情感控制、停顿控制、多语言/方言控制
六、应用场景
- 智能客服与语音助手:7×24 小时语音问答与业务处理,替代部分人工客服
- 有声读物与电子书:将文字内容自动转化为自然朗读,解决阅读障碍人群的信息获取问题
- 虚拟主播与数字人:为数字人提供自然的声音输出,是虚拟主播的核心技术组件
- 无障碍辅助:为视障用户朗读屏幕内容、导航播报、电子邮件朗读等无障碍场景
- 短视频与内容创作:自动为视频配音、旁白,支持多语言本地化
七、优缺点
优点:自然度接近真人:神经 TTS 在音色、韵律、情感上已接近人类自然语音;低成本规模化:一次性训练后边际成本极低,适合大规模内容生产;多语言与定制能力:可快速支持多语种,并通过少量音频克隆个性化音色;赋能无障碍:显著改善视障、阅读障碍人群的信息获取与生活质量
- 缺点:情感表达仍有局限:复杂情感与微妙的韵律变化仍不及专业播音员;实时性挑战:高保真声码器计算量大,低延迟流式 TTS 技术要求高;音色克隆伦理风险:恶意使用音色克隆进行诈骗、伪造的风险引发社会担忧;多音字与专有名词错误:特定领域词汇、专有名词的发音准确率仍需提升
八、常见误区
- TTS 已经和真人一模一样了(错:专业聆听下仍可分辨机器合成,专业播音场景仍需人工)
- TTS 只是「读文字」(错:优秀的 TTS 需要处理韵律预测、情感表达、多音字消歧等复杂问题)
- TTS 技术已经成熟不需要改进(错:情感表达、实时性、个性化仍是活跃的研究方向)
九、关联概念
- 父概念:语音 AI、人工智能 Artificial Intelligence、多模态人工智能
- 子概念:声码器、HiFi-GAN、音色克隆、情感 TTS
- 兄弟概念:语音识别 ASR、数字人、ASR 语音识别、多模态大模型
- 对比概念:语音识别 ASR、传统拼接合成、真人配音
- 应用相关:智能客服、有声读物、数字人、无障碍辅助、短视频配音