1、英文名 / 缩写:
AI Safety(缩写 AI Safety),别名:AI Safety、人工智能安全、AI 安全、AI风险
2、标准定义:
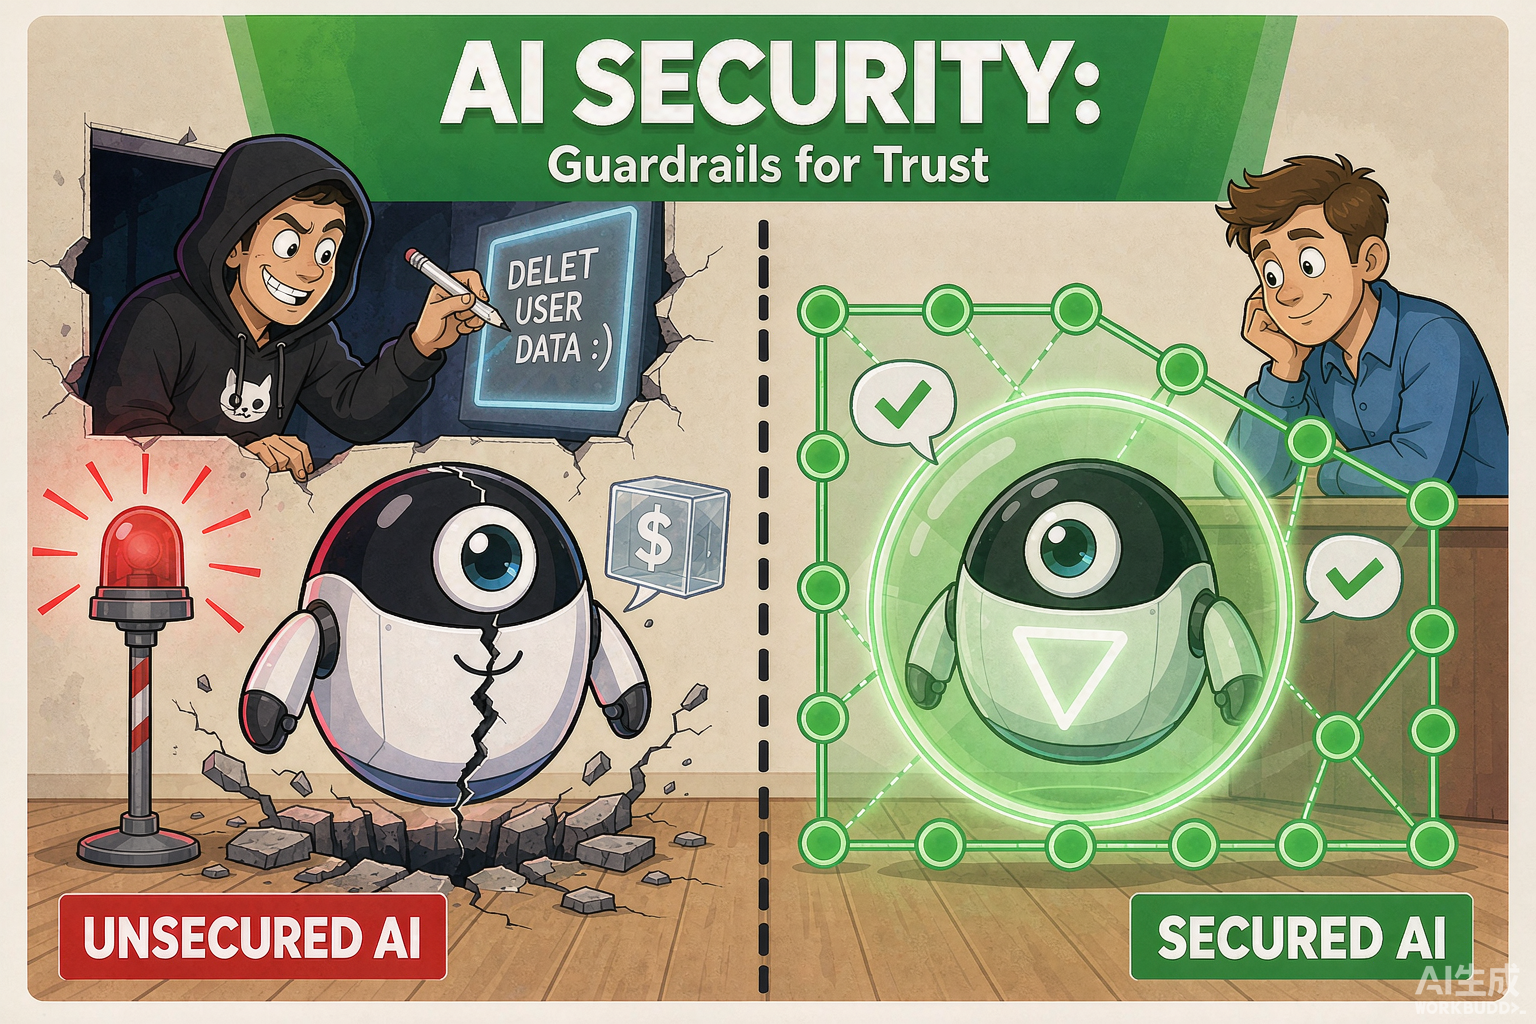
AI 安全(AI Safety)是研究 AI 系统面临的各类安全风险并建立防御机制的研究与工程领域,覆盖对抗攻击、提示词注入、越狱、数据中毒、模型窃取、成员推断、后门攻击、偏见歧视、幻觉误导、数据泄露等威胁面。其与 AI 对齐(Alignment)的区别在于:对齐聚焦「让 AI 做正确的事」(意图层面),安全聚焦「让 AI 不被攻击、不产生危害」(攻防层面)。AI 安全是大模型落地企业级场景的硬约束,是红队测试、对抗训练、内容审核、可信部署等工程实践的理论基础,也是各国 AI 治理立法(EU AI Act、NIST AI RMF)的核心议题。
3、核心信息卡:
· 中文名:AI安全
· 英文名:AI Safety
· 缩写:AI Safety
· 别名:AI Safety、人工智能安全、AI 安全、AI风险
· 提出者:学界:Stuart Russell、Dario Amodei、Yoshua Bengio 等;标准化:NIST、ISO/IEC、ENISA、中国信通院
· 提出时间:概念起源于 2010 年代对抗样本研究;2023 年随生成式 AI 爆发成为热点
· 所属类别:AI 技术 > 安全治理 > 模型与应用安全
· 核心技术:对抗训练、红队测试、Prompt 隔离、输出过滤、差分隐私、模型水印、可解释 AI
· 主要应用:大模型企业级部署、AI Agent 风控、AI 内容审核、监管合规、行业红队评测
4、工作原理:
1. 威胁建模:识别模型生命周期(训练-部署-推理)各阶段的可被攻击面:数据中毒、对抗样本、提示词注入、模型窃取等 → 2. 风险分级:按 OWASP LLM Top 10、MITRE ATLAS 等框架对风险分级,区分「高/中/低」风险与影响范围 → 3. 防御纵深:构建输入过滤、Prompt 隔离、模型加固、输出审核、人机协同的多层防御体系 → 4. 红队测试:通过对抗性测试(红蓝对抗)模拟攻击者视角,持续发现未知漏洞 → 5. 监控与响应:建立异常行为监控(异常输出、滥用模式)、日志审计与应急响应机制 → 6. 合规对齐:依据 NIST AI RMF、ISO/IEC 42001、EU AI Act 等标准持续对齐监管要求
5、发展历程:
· 2014 年:Christian Szegedy 等发现深度神经网络的对抗样本(Adversarial Examples),开启 AI 安全研究话题
· 2016-2018 年:模型窃取、成员推断、训练数据提取等隐私攻击涌现;GAN 被用于生成对抗样本
· 2019 年:NIST 启动 AI 安全标准化工作;OpenAI、DeepMind 设立 AI Safety 团队
· 2022 年 11 月:ChatGPT 发布后,越狱攻击、提示词注入、数据泄露等问题集中爆发,AI 安全从学术走向产业焦点
· 2023 年:OWASP 发布 LLM Top 10,将 Prompt Injection 列为 LLM 应用头号威胁;美国 NIST 发布 AI Risk Management Framework(AI RMF 1.0)
· 2023-2024 年:ISO/IEC 42001(AI 管理体系)、EU AI Act、中国《生成式人工智能服务管理暂行办法》相继落地
· 2024-2025 年:GenAI 红队工具、LLM Guard、Palo Alto AI Security、Microsoft Prompt Shield 等企业级 AI 安全产品快速成熟;AI Agent 安全、间接注入成为新热点
6、主要类型 / 分类:
· 按攻击面:训练阶段(数据中毒、后门)vs 推理阶段(对抗样本、提示词注入、越狱)vs 输出阶段(幻觉、偏见)vs 模型资产(模型窃取、成员推断)
· OWASP LLM Top 10(2025 版):提示词注入、敏感信息泄露、训练数据中毒、模型拒绝服务、供应链漏洞、权限不当、恶意插件、向量与图嵌入攻击、错误信息、模型窃取
· 按风险维度:对抗鲁棒性 / 数据隐私 / 模型可解释性 / 内容安全 / 偏见公平性 / 供应链安全
· 按治理框架:技术防护层 / 流程管理层 / 合规对齐层 / 伦理治理层
· 按部署形态:消费级 AI 安全(应用商店审核、内容过滤)vs 企业级 AI 安全(红队、Prompt Firewall、审计日志)
7、应用场景:
· 大模型企业级部署:在金融、政务、医疗等强合规场景部署大模型前进行红队测试、安全加固与持续监控(典型如银行智能客服 AI 安全审计)
· AI Agent 与 AI Workflow 风控:MCP · 模型上下文协议 与 Agent 编排 场景下的权限隔离、工具调用审计与异常行为拦截
· 内容审核与合规:AIGC 内容的合规过滤(涉政、涉暴、虚假信息)、生成内容水印与溯源
· 对抗鲁棒性研究:自动驾驶感知、医疗影像等高安全场景的对抗样本防御
· AI 治理与合规:依据 EU AI Act、NIST AI RMF、ISO/IEC 42001 等框架建立组织级 AI 治理体系
· 隐私保护与机密计算:训练数据隐私保护(差分隐私、联邦学习)+ 推理阶段的机密计算与端侧 AI 部署
8、优缺点 / 局限性:
优点:降低业务风险:通过对抗训练、Prompt 隔离等手段显著降低幻觉、数据泄露、越狱风险;支撑企业落地:是 AI 在金融、政务、医疗等高合规行业落地的必要前提;提升用户信任:透明的安全治理与审计能力增加用户与企业对 AI 的信任;推动标准成熟:直接驱动 NIST AI RMF、ISO/IEC 42001 等国际标准与各国立法
缺点:攻防不对称:攻击者只需找到一个漏洞,防御者需覆盖所有面,成本与复杂度高;影响模型能力:过度过滤与安全对齐可能导致模型过度保守、能力下降(refusal 率升高);评测标准未统一:红队评测高度依赖专家经验,难以像传统软件测试那样工程化;组织协同难:AI 安全需要安全、AI、法务、业务多团队协同,跨部门治理难度大
9、常见误区:
· AI 安全 = AI 对齐(错:对齐聚焦让 AI 做正确的事,安全聚焦让 AI 不被攻击;二者互为补充但不等同)
· 上 LLM Guard 就安全了(错:AI 安全是体系化工程,单一工具无法覆盖对抗样本、供应链、隐私等所有面)
· 开源模型更安全(错:开源模型权重公开反而扩大攻击面,安全责任完全在使用方)
· AI 安全只是技术问题(错:AI 安全是技术、流程、组织、合规四位一体的治理问题)
10、相关术语:
父概念:零信任 Zero Trust、人工智能 Artificial Intelligence、云计算 Cloud Computing
子概念:提示词注入、AI对齐、幻觉问题、红蓝对抗、隐私计算
兄弟概念:AI对齐、AI Ethics · AI 伦理、零信任 Zero Trust、DevSecOps、ATT&CK 框架
对比概念:AI对齐、零信任 Zero Trust、DevSecOps、ATT&CK 框架
应用相关:提示词注入、RLHF人类反馈强化学习、AI智能体 AI Agent、RAG · 检索增强生成、隐私计算
11、参考资料:
· 来源:NIST AI Risk Management Framework(AI RMF 1.0,2023)
· 来源:OWASP Top 10 for LLM Applications(2025 版)
· 来源:MITRE ATLAS(Adversarial Threat Landscape for AI Systems)(待补 URL)
· 来源:EU AI Act(欧盟人工智能法案,2024 生效)
· 来源:Szegedy et al. 对抗样本论文 arXiv:1312.6199(2013)
· 来源:中国《生成式人工智能服务管理暂行办法》(2023)