1、英文名 / 缩写:
Large Language Model Distillation(缩写 LLM Distillation),别名:大模型蒸馏、知识蒸馏、Knowledge Distillation
2、标准定义:
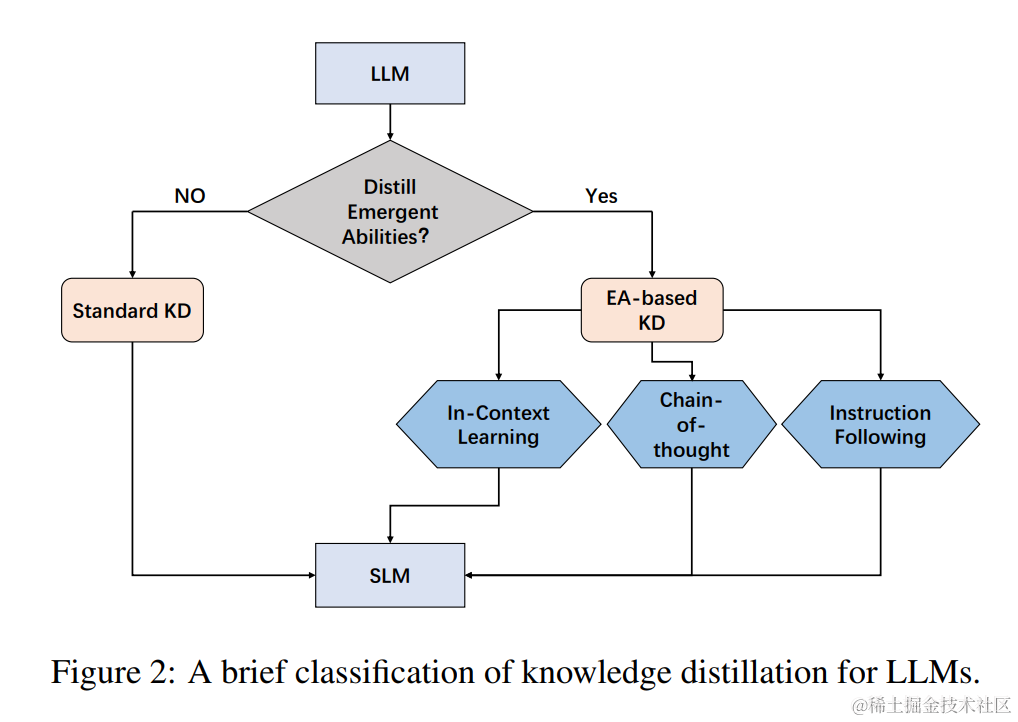
LLM 蒸馏(Large Language Model Distillation)是把大模型的能力迁移到小模型上的技术过程,让小模型在保持较高任务表现的同时降低推理成本与部署门槛。它通过监督微调(SFT)、特征对齐、Logit 蒸馏、偏好学习(DPO直接偏好优化)等多种手段让小模型「模仿」大模型的行为与思考模式,是大模型走向低成本、端侧与边缘场景的关键技术。代表工作包括 DistilBERT、TinyLLAMA、Phi、DeepSeek 蒸馏系列、Qwen 蒸馏系列等。
3、核心信息卡:
· 中文名:LLM 蒸馏
· 英文名:Large Language Model Distillation
· 缩写:LLM Distillation
· 别名:大模型蒸馏、知识蒸馏、Knowledge Distillation
· 提出者:概念奠基:Hinton 等(2015《Distilling the Knowledge in a Neural Network》);LLM 蒸馏代表:Hugging Face(DistilBERT)、Microsoft(Phi 系列)、Meta(TinyLLAMA)、DeepSeek、阿里 Qwen
· 提出时间:2015 年(知识蒸馏概念提出);2019 年(DistilBERT);2023-2025 年(LLM 蒸馏与端侧小模型爆发)
· 所属类别:AI 技术 > 模型压缩 > 知识蒸馏
· 核心技术:SFT 监督微调、Logit 蒸馏、特征对齐、偏好蒸馏(DPO直接偏好优化)、Reasoning 蒸馏、模型量化 配合压缩
· 主要应用:端侧 LLM、AI PC 部署、边缘计算 设备、低成本推理服务、企业低成本 AI 落地
4、工作原理:
1. 教师模型准备:选定性能强大的大模型(Teacher)作为知识源 → 2. 数据构造:通过 Teacher 模型对大规模指令/无标注数据生成回答(Self-Instruct、Rejection Sampling),构造高质量 SFT 数据集 → 3. 学生模型选择:选定轻量级架构(LLaMA-3.2-1B、Qwen-1.5B、Phi-3-mini 等)作为 Student → 4. 蒸馏训练:用 SFT、Logit 蒸馏或特征对齐损失让学生模型拟合教师行为,必要时叠加 DPO 直接偏好优化 提升对齐质量 → 5. Reasoning 蒸馏:让 Student 模仿 Teacher 的思维链 CoT 与推理过程(如 DeepSeek-R1 蒸馏到 Qwen/Llama 系列)→ 6. 后压缩与部署:配合 模型量化、剪枝进一步压缩,部署到端侧或边缘设备
5、发展历程:
· 2015 年:Hinton 等在《Distilling the Knowledge in a Neural Network》中正式提出知识蒸馏概念
· 2019 年:Hugging Face 发布 DistilBERT,首次把蒸馏落地到 NLP 主流模型,体积缩小 40%、性能保留 97%
· 2020-2022 年:TinyBERT、MiniLM、TinyLLAMA 等持续推动小模型化
· 2023 年:Microsoft Phi 系列、阿里 Qwen 蒸馏版展示「小而强」的可能性
· 2024-2025 年:DeepSeek-R1 蒸馏(Distill Qwen、Distill Llama)、Reasoning Distillation 成为前沿,端侧 LLM(AI PC、手机端)走向实用
· 2025 年:LLM 蒸馏与 模型量化、SFT、DPO 直接偏好优化 形成完整压缩流水线,支撑端侧与边缘场景
6、主要类型 / 分类:
· 按蒸馏对象:Logit 蒸馏(输出概率)、Feature 蒸馏(中间表征)、Attention 蒸馏(注意力图)
· 按训练范式:SFT 蒸馏、DPO 直接偏好优化 蒸馏、Reasoning 蒸馏(思维链 蒸馏)、多教师蒸馏(Ensemble Teacher)
· 按学生模型形态:同构蒸馏(同架构小模型)vs 跨构蒸馏(不同架构)
· 按目标场景:通用任务蒸馏、垂直领域蒸馏、多语言蒸馏、多模态蒸馏
· 按蒸馏阶段:预训练阶段 蒸馏、SFT 阶段蒸馏、RLHF/DPO 阶段蒸馏
7、应用场景:
· 端侧 LLM:把 70B/175B 教师模型蒸馏到 1B-7B,部署到 AI PC、手机、IoT 设备
· 低成本推理服务:用蒸馏小模型提供近似 GPT-4 的能力,单次推理成本降低 10x-50x
· 企业私有部署:把云端大模型能力蒸馏到本地小模型,兼顾数据隐私与成本
· 垂直领域小模型:在法律、医疗、金融等行业用领域数据蒸馏专用小模型
· 边缘计算 设备:自动驾驶、机器人、智能摄像头等边缘场景的实时 AI 推理
· Reasoning 模型普及:通过 Reasoning Distillation 让小模型也具备 o1 类推理能力
8、优缺点 / 局限性:
优点:显著降低成本:推理显存与延迟下降一个数量级,部署门槛大幅降低;保留大部分能力:在多数任务上小模型可保留教师 80-95% 的能力;支持端侧与离线:小模型可部署到 AI PC、手机等无网络场景;数据隐私友好:本地部署无需上传数据到云端
缺点:能力上限受限:小模型在复杂推理、长上下文、专业领域仍弱于教师;蒸馏数据成本:构造高质量 SFT 数据需大量 Teacher 推理,Token 成本可观;能力「幻觉」可能放大:教师模型偶尔错误行为可能在学生中放大;维护多版本:模型矩阵多,教师升级时需同步蒸馏新版本学生
9、常见误区:
· 蒸馏 = 模型量化(错:蒸馏是知识迁移,模型量化 是数值精度压缩,二者常配合但不等同)
· 小模型一定不如大模型(错:在垂直领域蒸馏的小模型可超越通用大模型在该领域的表现)
· 蒸馏只能从大到小(错:可同构、跨构、多教师蒸馏,形式多样)
· 蒸馏后会丧失 Reasoning 能力(错:DeepSeek-R1 蒸馏等证明 Reasoning 可被有效蒸馏到小模型)
10、相关术语:
父概念:模型压缩、大语言模型 Large Language Model
子概念:Reasoning Distillation、SFT 监督微调、DPO直接偏好优化、小语言模型
兄弟概念:模型量化、Fine-tuning、LoRA微调
对比概念:模型量化、从头训练小模型、模型剪枝
应用相关:AI PC、端侧 LLM、边缘计算(Edge Computing)、数字员工
11、参考资料:
· 来源:Hinton et al.《Distilling the Knowledge in a Neural Network》arXiv:1503.02531(2015)
· 来源:Sanh et al.《DistilBERT》论文 arXiv:1910.01108(2019)
· 来源:DeepSeek-R1 蒸馏技术报告(2025)
· 来源:Microsoft Phi 系列技术报告
· 来源:Hugging Face Distillation 教程