1、英文名 / 缩写:
Computer Vision(缩写 CV),别名:机器视觉、图像理解、视觉智能
2、标准定义:
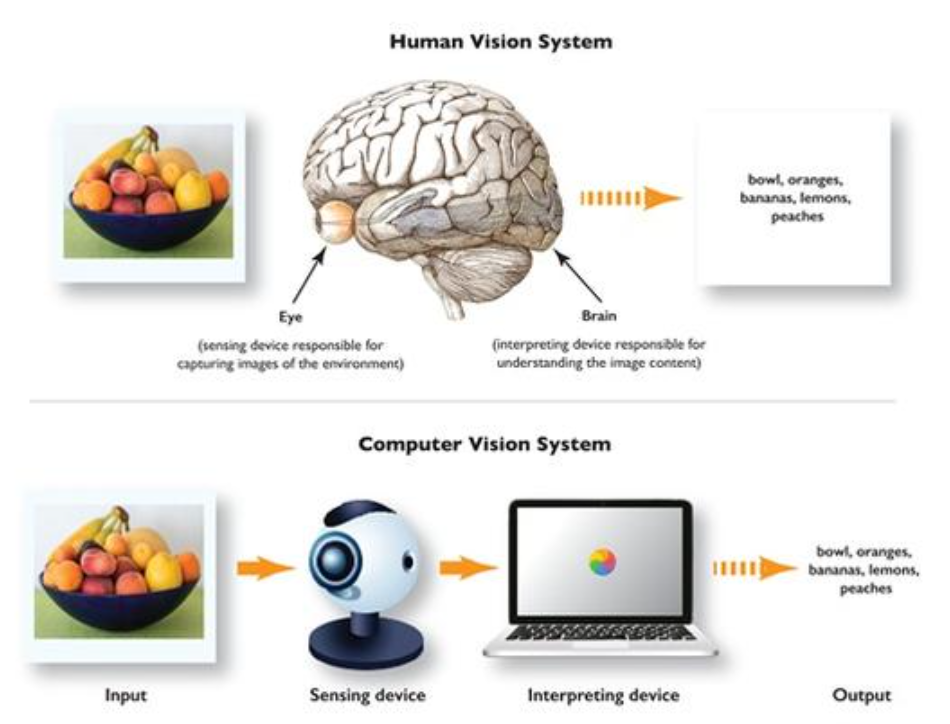
计算机视觉(Computer Vision,CV)是人工智能的核心子领域,研究如何让计算机从图像或视频中理解视觉内容,涵盖图像分类、目标检测、图像分割、人脸识别、姿态估计、光学字符识别(OCR 光学字符识别)、视频分析、3D 重建等任务。从传统特征工程(SIFT、HOG)到深度卷积神经网络(CNN)、再到视觉 Transformer 与多模态大模型,CV 经历了三次能力跃迁。当下以视觉大模型、视觉-语言模型(VLM)与具身智能 Embodied AI 为代表的前沿方向,正在推动 CV 从感知走向认知与决策,是自动驾驶、机器人、安防、医疗影像、AIGC · 工业生成内容 等场景的关键支撑。
3、核心信息卡:
· 中文名:计算机视觉
· 英文名:Computer Vision
· 缩写:CV
· 别名:机器视觉、图像理解、视觉智能
· 提出者:奠基:David Marr(1982 视觉计算理论);深度学习派:Yann LeCun(LeNet)、Krizhevsky(AlexNet)、何恺明(ResNet);多模态派:Google(ViT)、OpenAI(CLIP、DALL·E)
· 提出时间:1960 年代(模式识别起步);1980-2000 年代(特征工程时代);2012 年(AlexNet 开启深度 CV 时代);2017 年(ViT、CLIP)
· 所属类别:AI 技术 > 深度学习 > 视觉感知
· 核心技术:CNN、ResNet、Vision Transformer、CLIP、目标检测(YOLO/DETR)、图像分割(SAM)、扩散模型 生成、视频理解
· 主要应用:人脸识别、自动驾驶感知、安防监控、医疗影像、工业质检、AR/VR、AIGC · 工业生成内容、机器人视觉
4、工作原理:
1. 图像输入与预处理:对原始图像/视频做归一化、增强、Resize 等处理,统一输入尺度 → 2. 特征提取:用 CNN、ResNet、ViT 等骨干网络从像素中提取从底层(边缘、纹理)到高层(物体、语义)的多尺度特征 → 3. 任务建模:依据分类、检测、识别、分割等任务设计特定 Head(如分类器、检测框、像素掩码)→ 4. 损失与优化:以交叉熵、IoU、对比损失等为目标,用梯度下降迭代训练 → 5. 后处理与部署:用 NMS、CRF 等算法优化输出结果,部署到 GPU、端侧 NPU 或边缘计算 设备 → 6. 多模态融合:与 NLP、语音融合形成视觉-语言模型(VLM)、数字人 等高级能力
5、发展历程:
· 1960-1970 年代:模式识别与边缘算子(Canny、Sobel)起步,CV 作为独立学科诞生
· 1980-1990 年代:David Marr《Vision》提出视觉计算理论;SIFT、HOG 等手工特征主导
· 2000-2010 年代:基于特征 + 分类器(SVM、AdaBoost)的方法工业化(人脸检测、OCR);ImageNet 推动数据规模
· 2012 年:AlexNet 在 ImageNet 大幅领先,深度 CNN 取代手工特征,CV 进入深度学习时代
· 2014-2017 年:R-CNN、YOLO、ResNet、Faster R-CNN 等推动检测/分割工业化;Mask R-CNN 进入实例分割
· 2017-2020 年:Vision Transformer(ViT)、CLIP、Swin Transformer 推动注意力机制成为 CV 主流
· 2021-2025 年:SAM(Segment Anything)、视觉大模型、多模态大模型、数字人、自动驾驶感知与具身智能 Embodied AI 推动 CV 从感知走向认知
6、主要类型 / 分类:
· 按任务:图像分类、目标检测、图像分割、人脸识别、姿态估计、OCR 光学字符识别、视频理解、3D 重建
· 按架构:CNN 时代(ResNet、EfficientNet)、Transformer 时代(ViT、Swin)、大模型时代(SAM、CLIP、视觉 LLM)
· 按模态:单图像、跨模态(视觉-语言、视觉-语音、视觉-3D)
· 按应用场景:安防 CV、自动驾驶 CV、医疗 CV、工业 CV、消费 CV(美颜、AR 滤镜)、AIGC 视觉生成
· 按学习范式:监督学习、自监督学习(DINO、MAE)、对比学习(CLIP)、扩散模型 生成
7、应用场景:
· 人脸识别与安防:刷脸支付、门禁、监控视频分析与异常事件检测
· 自动驾驶:车道线检测、交通标志识别、3D 目标检测、BEV 感知、Occupancy 网络(Tesla FSD、Waymo)
· 医疗影像:CT/MRI 病灶检测、病理切片分析、辅助诊断(肺结节、眼底病变等)
· 工业质检:产品表面缺陷检测、尺寸测量、自动化分拣(与 数字孪生 Digital Twin 融合)
· AIGC 与内容创作:图像生成、视频生成、数字人、虚拟主播(属于 AIGC · 工业生成内容 范畴)
· 机器人与具身智能:机械臂视觉伺服、人形机器人视觉感知、自动驾驶与无人机导航
8、优缺点 / 局限性:
优点:应用场景极广:覆盖安防、医疗、交通、制造、消费等几乎所有视觉相关行业;大模型加持:CLIP、SAM、视觉 LLM 让 CV 具备零样本与开放词汇识别能力;工程化成熟:YOLO、Detectron2、MMCV 等开源框架降低开发门槛;与硬件深度结合:与摄像头、NPU、自动驾驶芯片等结合形成端到端方案
缺点:数据与标注成本高:高质量标注数据获取困难,尤其在医疗、工业等长尾场景;鲁棒性挑战:对光照、遮挡、罕见样本敏感,分布漂移会显著降低性能;可解释性弱:深度模型黑盒决策,难以满足医疗等强解释场景;隐私与合规:人脸识别等场景受 GDPR 等法规严格约束
9、常见误区:
· CV = 人脸识别(错:人脸识别只是 CV 众多任务之一,目标检测、分割、生成同样重要)
· CV 模型可以通用(错:自动驾驶、工业质检、医疗影像等场景需要专门数据与算法)
· CV = 图像分类(错:CV 涵盖检测、分割、视频、3D、生成等远超分类的丰富任务)
· CV 不需要 NLP(错:多模态大模型 时代,视觉-语言联合建模成为主流方向)
10、相关术语:
父概念:深度学习 Deep Learning、人工智能 Artificial Intelligence
子概念:OCR 光学字符识别、数字人、AIGC · 人工智能生成内容、具身智能 Embodied AI
兄弟概念:NLP · 自然语言处理、语音识别 ASR、语音合成 TTS
对比概念:NLP · 自然语言处理、语音识别 ASR
应用相关:数字孪生 Digital Twin、智能制造、人形机器人、多模态人工智能、RAG · 检索增强生成
11、参考资料:
· 来源:Krizhevsky et al. AlexNet 论文(NIPS 2012)
· 来源:He et al. ResNet 论文 CVPR 2016
· 来源:Dosovitskiy et al. ViT 论文 ICLR 2021
· 来源:Radford et al. CLIP 论文 arXiv:2103.00020(2021)
· 来源:Kirillov et al. SAM 论文 arXiv:2304.02643(2023)