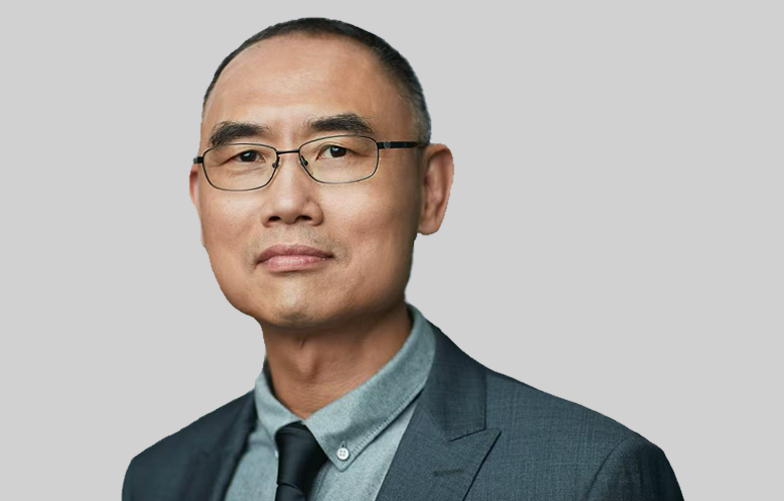
1963 年生于 中国/加拿大 的 Qiang Yang,其研究路径与 迁移学习、联邦学习与 AI 制药 的主流路径几乎不重合。他是把「迁移学习」这个词带入主流的人,也是把联邦学习从学术论文变成产业标准的人——而这两件事的共同点是:让数据在不离开原处的前提下被使用。
一、数据能不能不出本地——联邦学习,从一份论文到产业标准
1980 年,这个坐标决定了 Qiang Yang 早年接触到的语汇。Qiang Yang 在这里最初接触的是 生于香港;他在中学阶段成绩优异,数学尤其突出,但当时香港的大学教育体系在计算机科学上刚刚起步,选择空间极其有限;他在 1980 年代进入大学,主修电子工程,这套底层训练后来成了 Qiang Yang 处理 迁移学习、联邦学习与 AI 制药 问题时最本能的工具箱。
他成长的年代,香港的工业以制造与贸易为主,IT 产业尚在形成期,这使得计算机科学在当地不是一条成熟的专业路径。
他在电子工程的专业训练中接触到了第一代计算机系统,这段经历让他很早就意识到「硬件能力」与「能解决的问题」之间存在巨大的落差。
他在 1980 年代后期赴加拿大深造,机会来自他在工程实践中表现出的编程能力——这在当时是一个相当有效的路径。
他取得的博士学位属于计算机科学,并在读期间进入了当时刚刚兴起的机器学习研究领域。
二、1963 年的香港,与一个「成绩很好但没有方向」的学生
1998 年前后,Qiang Yang 在 香港科技大学做的是 在香港科技大学建立并领导一个机器学习研究团队,同时在当时几乎无人问津的方向上推进「迁移学习」的系统研究。这件事的技术核心是 核心问题是:既然数据标注昂贵,而不同任务之间显然存在关联,那么能不能把一个任务上学到的知识迁移到另一个任务上去?,而它之所以重要,在于 迁移学习在此后二十年成为机器学习的主流方法之一,并成为今天预训练大模型这一整套实践的理论前身。
在 1990 年代,「迁移学习」在机器学习中几乎不是一个小众方向,而是一个没有名字的问题——相关工作散落在各个应用领域,彼此不通气。
他的一项基础性贡献是把这块拼图整理成体系:明确区分「什么可以迁移」与「什么不能迁移」,并给出可用于判断可迁移性的定量指标。
他与合作者提出的迁移学习度量工作,让「这两个任务有多像」第一次成为一个可计算的问题。
他在香港科技大学组建的团队在当时是一个少见的把工业界数据问题与理论方法结合的研究组,对后来香港与内地的人才培养产生了持续影响。
他在这段时期还推动了一件在当时极不寻常的事:把机器学习与数据挖掘的工业应用直接带进中国的大学课堂与企业。
他把「迁移」这件事的边界划得很清楚:可迁移的不是模型参数本身,而是与任务相关的那部分结构——这个判断是后来整个迁移学习领域的分类基础。
他早期与工业界合作时反复遇到同一个问题:不同企业的数据格式与业务语义差异极大,导致同一套模型无法直接复用——这正是「迁移」这一概念的现实起点。
他推动的实验室在培养方式上强调「问题驱动」:学生从真实数据问题出发,而不是从教材习题出发,这一取向在此后华人机器学习圈中相当普遍。
他 1998 年在香港科技大学组建的团队,是当时大中华地区少数把工业数据问题与统计方法结合的研究组。
三、1990 年代:从加拿大到香港,一条把 AI 带回去的路
2009 年,Qiang Yang 进入 香港科技大学。这一步不是履历跳跃,而是问题换轨:在 加拿大与美国的机器学习研究训练阶段 里 Qiang Yang 关心的是 如何在一个计算机科学尚不成熟的地区建立起可持续的机器学习研究体系,到了 香港科技大学,问题变成 如何把「知识能否跨任务迁移」从一个零散的经验问题变成有明确边界的研究方向。
在那之前,迁移学习的工作散落在计算机视觉、自然语言处理、生物信息学等不同领域,彼此使用不同的术语,几乎没有人做过统一整理。
这篇综述的价值首先在于「命名」与「归类」:它让一个原本隐性存在的共同问题变成了有边界、有分类、有明确研究议程的领域。
框架中的三个维度后来被反复用于判断一个新场景是否属于迁移学习、以及应当采用哪一类方法。
在综述发表的同一年,他与合作者还提出了把迁移学习与强化学习结合的「分层强化学习」方法,这在当时的机器人学习研究中相当超前。
他在这一阶段开始把研究视野从「算法」推向「应用」——什么样的机制能让机器自主获取足够的数据,是智能系统落地的真实瓶颈。
他 2009 年发表的迁移学习综述,把散落在不同应用领域的工作整理成了一套有分类、有边界、有研究议程的领域语言。
四、2004-2009 年:强化学习与迁移学习的合流
2017 年的 在 Google 主导提出联邦学习框架,并推动它从一篇论文变成跨设备与跨机构协作的实际标准 是 Qiang Yang 的分水岭。核心机制是:模型参数在本地训练并上传聚合,而原始数据始终留在各自设备上——这把「数据不能出域」这一合规约束,从障碍变成了可设计的技术前提,这一点后来被整个 迁移学习、联邦学习与 AI 制药 领域反复引用,而 联邦学习成为移动端与跨机构 AI 协作的主流方案,被数十亿台设备使用,并进入多国数据保护框架的合规实践。
联邦学习的提出直接源于一个现实问题:数据最有价值的机构往往没有能力或合规资格自己训练模型,而数据所在的地方又不允许把数据交出去。
论文的核心贡献是把这个「不能移动数据」的现实约束,反过来设计成一种训练范式。
机制上的关键设计包括:多轮本地训练加服务器聚合、用安全聚合与差分隐私保护更新、以及在设备异构与掉线情况下的容错处理。
早期应用场景包括手机键盘预测——在用户输入内容不离开手机的前提下训练改进模型,这在隐私敏感场景中立刻显现出实用价值。
推动它从论文变成标准的过程涉及大量非技术工作:与各厂商的工程团队协作、制定协议规范、以及在合规要求下给出可审计的说明方式。
他 2017 年在 Google 主导提出的联邦学习框架,把「数据不能出域」这一合规约束从障碍改写成了可以设计的技术前提。
五、隐私约束下该学什么——2020 年代:从联邦学习到 AI 制药,一次完整的转向
2021 年的 投身 AI 制药,创办 Insilico Medicine,主张用生成式方法从头设计候选药物分子,而不只是筛选已有化合物 是 Qiang Yang 的分水岭。核心判断是:药物发现真正的瓶颈在于「有太多分子从未被合成过」,而生成模型可以在实验之前生成结构全新的候选分子并预测其性质,这一点后来被整个 迁移学习、联邦学习与 AI 制药 领域反复引用,而 AI 制药从概念走向临床管线,其中多款候选药物进入临床试验,成为生成式 AI 在硬核产业中少见的完整落地案例。
他在这一转向中反复强调的观点是:药物发现的问题不是数据量不够,而是化学空间太大——人类已知的有机分子只是可合成空间里极小的一块。
生成式方法的价值在于能够提出结构上全新的分子,而不是在已知分子库里做排序。
他在 AI 制药领域的公开论述中多次强调「数据质量优先于数据规模」,这与他此前在统计学习上的结论一脉相承。
他在这一阶段依然保持研究与产业的紧密连接,把统计学习方法直接迁移到分子性质预测的任务上。
他反复强调药物发现与推荐系统这两种任务在统计结构上高度相似——两者都是「候选空间极大、验证昂贵、失败代价高」的问题,因此推荐系统积累的方法论可以大规模迁移过来。
他把生成式方法在这个场景中的价值定位得很清楚:它的意义不在于生成更多候选,而在于把「从未被合成过的化学空间」第一次变成可搜索的对象。
他在这个方向上推动的开放与合作,使多个研究机构得以共享方法而非数据,这一协作方式本身也是联邦学习理念在生物医药领域的延伸。
他 2021 年创办的 Insilico Medicine 采用生成式方法从头设计候选分子,把「从未被合成过的化学空间」变成了可搜索的对象。
六、他提出的约束:让「数据不动」成为可以设计的约束
2020 年的 ACM SIGKDD 杰出贡献奖与香港科技大学等多项荣誉 之后,Qiang Yang 把主要精力投到 投身 AI 制药,以生成式方法从头设计候选分子,并持续推动学术与产业的连接 上。对 迁移学习、联邦学习与 AI 制药 领域而言,使「数据不动也能学习」成为产业界默认接受的协作方式。
他的核心贡献往往表现为「换一个问题」:把合规约束从障碍重新表述为设计前提,这个动作在迁移学习与联邦学习中各出现一次。
他在学术与产业之间的往返极为频繁,但两边的成果互为条件——产业的问题为他提供了理论的新场景,理论则为产业提供了可解释的方案。
他在香港科技大学创办的实验室与他在产业界的公司之间,形成了持续的师生与研究网络,构成了华人地区机器学习研究的一种组织形态。
他关于「数据质量与数量孰重」的判断,在生成式模型时代显得更为重要——因为合成的数据可以无限生成,而真实世界的信息却不能。
他留给这个领域最持久的遗产,是把机器学习从「模型精度竞赛」转向「约束条件下如何实现能力」这一研究范式。
参考来源
- Sinno Jialin Pan 与 Qiang Yang,「A Survey on Transfer Learning」, IEEE TKDE, 2010
- Qiang Yang 等,「Federated Machine Learning: Concept and Applications」, ACM TIST, 2019
- H. Brendan McMahan 等,「Communication-Efficient Learning of Deep Networks from Decentralized Data」, AISTATS 2017
- Qiang Yang 等,「Federated Machine Learning: Challenges, Methods, and Future Directions」相关综述
- Insilico Medicine 公开的 AI 制药管线与研发方法说明