1、英文名 / 缩写
Reinforcement Learning(缩写 RL),别名:强化学习、增强学习、RL
2、标准定义:
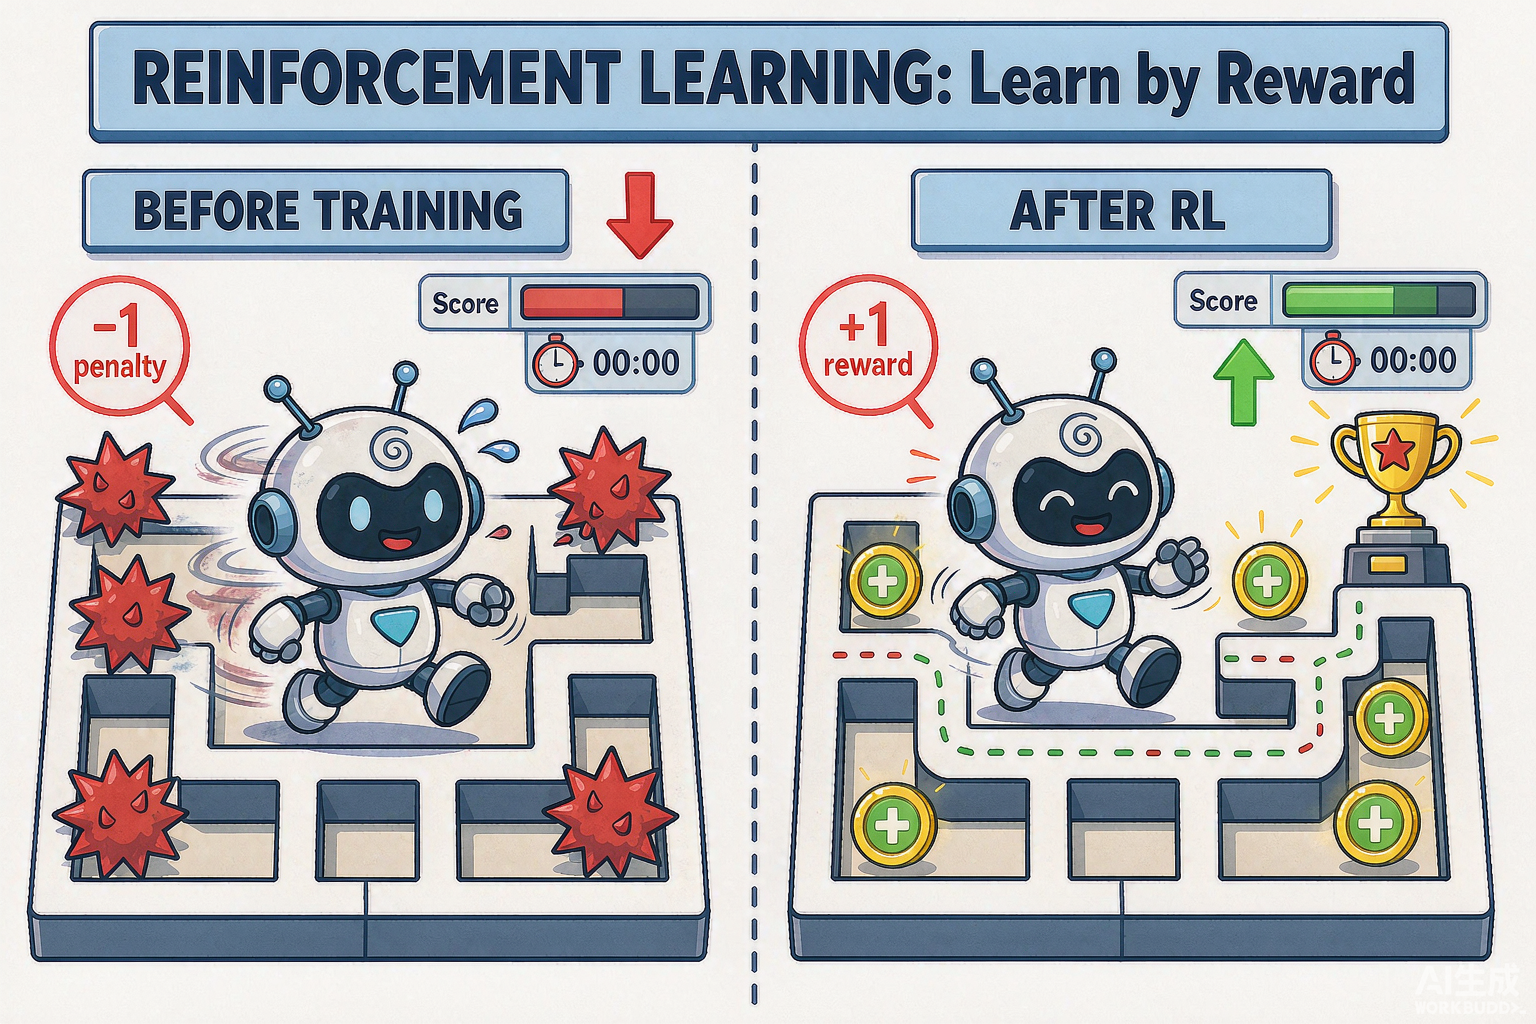
强化学习(Reinforcement Learning,RL)是通过智能体(Agent)与环境(Environment)不断交互、试错,基于奖励信号(Reward)学习最优策略(Policy)的机器学习范式。与监督学习依赖标注数据不同,强化学习依赖环境反馈信号,目标是最大化长期累计回报。强化学习是游戏 AI(AlphaGo、AlphaStar)、机器人控制、自动驾驶、推荐系统等决策类场景的核心技术,也是大模型对齐(RLHF / DPO)的理论基础。与「让模型学会给答案」的监督学习相比,强化学习解决的是「让模型学会做决策」的序列决策问题。
3、核心信息卡:
· 中文名:强化学习
· 英文名:Reinforcement Learning
· 缩写:RL
· 别名:强化学习、增强学习、RL
· 提出者:理论奠基:Richard Sutton、Andrew Barto(《Reinforcement Learning: An Introduction》);算法突破:DeepMind(DQN、AlphaGo)
· 提出时间:1980 年代(理论基础);2013 年(DQN 突破);2016 年(AlphaGo 公众认知)
· 所属类别:AI 技术 > 机器学习 > 决策学习
· 核心技术:策略网络 Policy、价值网络 Value、奖励函数工程、Q-Learning、Actor-Critic、PPO
· 主要应用:游戏 AI、机器人控制、自动驾驶、推荐系统、大模型对齐(RLHF)
4、工作原理:
1. 环境建模:把任务抽象为马尔可夫决策过程(MDP),定义状态空间 S、动作空间 A、转移概率 P、奖励函数 R → 2. 策略初始化:随机或基于启发式初始化策略网络 π(a|s),输出每个状态下选择动作的概率 → 3. 交互采样:智能体按当前策略与环境交互,生成状态-动作-奖励-下一状态轨迹(trajectory) → 4. 回报估计:基于折扣因子 γ 计算累积回报 G_t,并用价值网络 V(s) 或 Q(s,a) 估计期望回报 → 5. 策略更新与探索平衡:通过策略梯度(Policy Gradient)或时序差分(TD-Learning)更新策略参数,用 ε-greedy / UCB / 熵正则维持探索 → 6. 迭代收敛:重复采样—估计—更新直到策略稳定收敛或达到目标性能
5、发展历程:
· 1980 年代:Richard Sutton 与 Andrew Barto 系统化强化学习理论基础,《Reinforcement Learning: An Introduction》成为经典教材
· 1989 年:Chris Watkins 提出 Q-Learning 算法,成为无模型 RL 的奠基性工作
· 1990 年代:TD-Learning、SARSA 等时序差分算法成熟;与神经网络的初步结合(TD-Gammon)展示潜力
· 2013 年:DeepMind 在 NIPS 发表 DQN(Deep Q-Network),用深度网络逼近 Q 函数,在 Atari 49 款游戏上超越人类水平
· 2016 年 3 月:AlphaGo 以 4:1 战胜李世石,2017 年 AlphaGo Zero 完全自对弈超越人类,RL 引发全球关注
· 2017-2019 年:AlphaStar(StarCraft II)、OpenAI Five(Dota 2)等在复杂博弈场景取得突破;PPO(2017)成为事实标准策略优化算法
· 2022 年:RLHF(Reinforcement Learning from Human Feedback)成为 ChatGPT 等大模型对齐的主流方法
· 2024-2025 年:DeepSeek-R1、OpenAI o1 等推理模型引入大规模 RL 形成 Reasoning RL;Agent RL 与 RLHF / DPO 共同构成大模型后训练的核心技术栈
6、主要类型 / 分类:
· 按学习信号:基于价值(Value-Based,如 Q-Learning)vs 基于策略(Policy-Based,如 REINFORCE)vs Actor-Critic(A2C、PPO、SAC)
· 按环境模型:有模型 RL(Model-Based,需环境模型)vs 无模型 RL(Model-Free,如 DQN、PPO)
· 按策略类型:on-policy(同策略,如 PPO)vs off-policy(异策略,如 DQN)
· 按奖励来源:传统 RL(环境奖励)vs 模仿学习(IL,借鉴专家)vs 逆强化学习(IRL,从示范反推奖励)vs RLHF(人类反馈)vs DPO(偏好优化)
· 按应用层次:游戏博弈 RL、机器人 RL、工业控制 RL、大模型对齐 RL(RLHF / DPO)、Reasoning RL(推理模型训练)
7、应用场景:
· 游戏博弈:AlphaGo、AlphaStar、OpenAI Five 在围棋、星际争霸、Dota 2 等复杂博弈上超越人类顶尖选手
· 机器人控制:机械臂抓取、四足机器人步态、自动驾驶决策(Waymo、Tesla FSD 中的决策模块大量使用 RL)
· 推荐与广告:电商、短视频平台的实时个性化推荐(RL 处理长期用户参与度而非即时点击)
· 大模型对齐:RLHF / DPO 让 ChatGPT、Claude 等大模型更符合人类偏好与安全约束,是 2022 年以来大模型训练流程的标准环节
· 运筹优化:物流调度、供应链管理、能源调度等组合优化场景,用 RL 学习近似最优策略
· 金融交易:高频交易、衍生品定价、组合管理中的序列决策问题
8、优缺点 / 局限性:
优点:解决序列决策:天然适合环境-动作-反馈闭环,是决策类问题的事实标准;长期回报优化:相比监督学习只看即时标签,RL 显式建模长期累计回报,更贴合真实业务目标;无需大量标注数据:与环境交互而非依赖人工标注,降低数据成本;可发现超越人类策略:AlphaGo Zero 等案例表明 RL 能发现人类未知的策略空间
缺点:样本效率低:需要大量环境交互样本,机器人、自动驾驶等真实环境训练成本极高;奖励函数难设计:奖励设计不当会导致 reward hacking 与意外行为;训练稳定性差:策略梯度方法对超参敏感,训练曲线波动大、复现性差;安全与可解释性弱:在金融、医疗等高风险场景的部署仍面临鲁棒性与审计挑战
9、常见误区:
· 强化学习 = 监督学习(错:监督学习依赖静态标注数据,RL 依赖与环境交互的奖励信号,二者范式不同)
· RL 只能用于游戏(错:RL 在机器人、推荐系统、自动驾驶、大模型对齐等众多领域已规模化应用)
· RLHF 等同于 RL(错:RLHF 只是 RL 在大模型对齐场景的应用,RL 还覆盖大量决策类任务)
· RL 一定能找到最优策略(错:在状态/动作空间巨大、奖励稀疏的场景,RL 只能找到近似策略甚至陷入局部最优)
10、相关术语:
父概念:机器学习 Machine Learning、人工智能 Artificial Intelligence
子概念:LLM 蒸馏、模型量化、Fine-tuning、RLHF人类反馈强化学习、DPO直接偏好优化
兄弟概念:机器学习 Machine Learning、深度学习 Deep Learning、联邦学习、RLHF人类反馈强化学习、DPO直接偏好优化
对比概念:机器学习 Machine Learning、联邦学习、RLHF人类反馈强化学习、LoRA微调
应用相关:AI智能体 AI Agent、AI Ops · AIOps智能运维、具身智能 Embodied AI、人形机器人、AGI · 通用人工智能
11、参考资料:
· 来源:Sutton & Barto《Reinforcement Learning: An Introduction》(MIT Press,2018 第二版)
· 来源:Mnih et al. DQN 论文 arXiv:1312.5602(2013)
· 来源:Silver et al. AlphaGo Nature 529:484(2016)
· 来源:Schulman et al. PPO 论文 arXiv:1707.06347(2017)
· 来源:Christiano et al. RLHF 论文 arXiv:1706.03741(2017)
· 来源:Wikipedia: Reinforcement learning(待补 URL)