1、英文名 / 缩写:
Deep Learning(缩写 DL),别名:深度学习、深度神经网络、DL
2、标准定义:
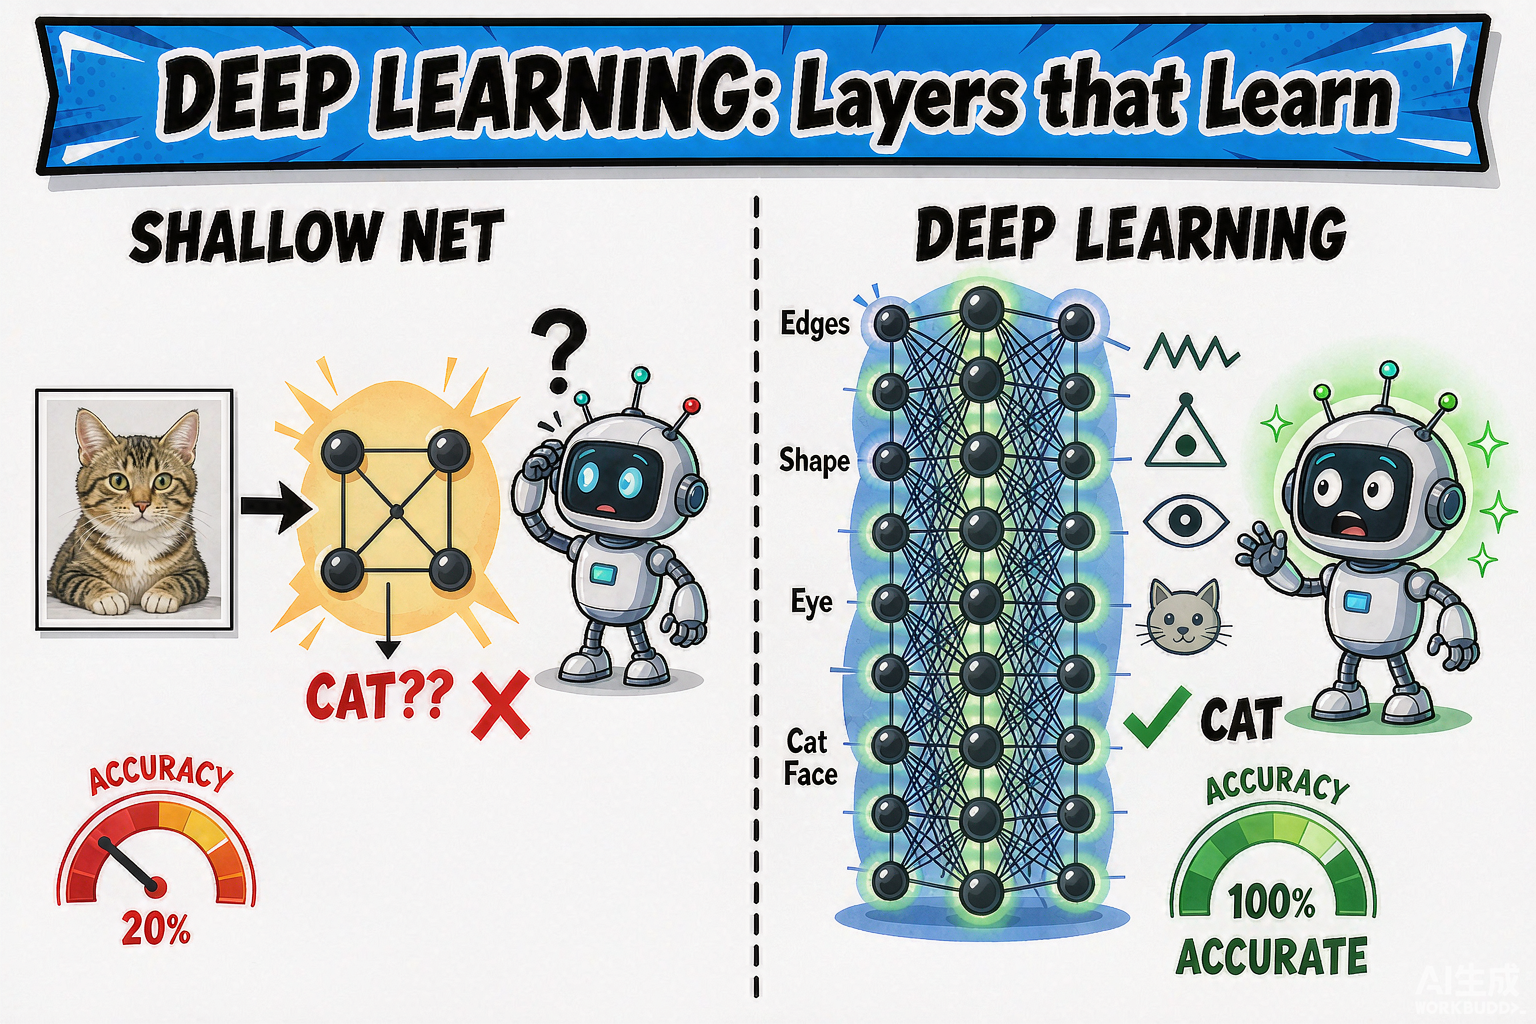
深度学习(Deep Learning,DL)是机器学习的一个分支,通过构建具有多个层次的神经网络自动学习数据的深层特征表示,摆脱传统机器学习对人工特征工程的依赖。它在图像、语音、自然语言处理、强化学习等领域取得突破性进展,是过去十年人工智能复兴与 AIGC 浪潮的核心驱动力。深度学习的关键能力来自大规模参数、非线性激活、端到端训练与海量数据四者的协同,代表架构包括 CNN、RNN、Transformer、Diffusion 与 MoE · MoE混合专家模型 等。
3、核心信息卡:
· 中文名:深度学习
· 英文名:Deep Learning
· 缩写:DL
· 别名:深度学习、深度神经网络、DL
· 提出者:奠基:Geoffrey Hinton、Yann LeCun、Yoshua Bengio、Andrew Ng;突破:Alex Krizhevsky(AlexNet)、Ilya Sutskever(Transformer)
· 提出时间:1986 年(Rumelhart 等提出反向传播 BP);2006 年(深度信念网络概念复兴);2012 年(AlexNet 拉开 DL 时代)
· 所属类别:AI 技术 > 机器学习 > 表示学习
· 核心技术:反向传播、CNN、RNN/LSTM、Transformer、Diffusion、MoE 稀疏激活、自监督预训练
· 主要应用:图像识别、语音识别、自然语言处理、大语言模型、AIGC 内容生成、自动驾驶感知
4、工作原理:
1. 网络建模:用多层神经网络堆叠表示特征层级(底层→中层→高层语义),用非线性激活(ReLU、GELU)打破线性限制 → 2. 损失函数设计:依据任务定义交叉熵、对比损失、扩散损失、RLHF 奖励等目标 → 3. 反向传播:基于链式法则计算梯度,用 SGD/Adam 等优化器迭代更新参数 → 4. 规模化训练:依托 GPU 集群 与分布式并行(数据/张量/流水线并行)支撑亿级参数训练 → 5. 正则化与对齐:通过 Dropout、BN、数据增强、对抗训练、RLHF/DPO 等避免过拟合与对齐人类偏好 → 6. 推理与压缩:通过 模型量化、LLM 蒸馏 等手段将模型部署到端侧或低成本推理环境
5、发展历程:
· 1986 年:Rumelhart 等提出反向传播算法(Backpropagation),奠定深度学习理论基础
· 2006 年:Geoffrey Hinton 等提出深度信念网络与逐层预训练方法,深度学习概念复兴
· 2012 年:Alex Krizhevsky 等用 AlexNet(GPU 训练 CNN)将 ImageNet 错误率从 26% 降至 15%,深度学习时代正式开启
· 2014-2016 年:GAN 生成对抗网络、ResNet 残差网络、DeepMind 深度强化学习等密集突破,AlphaGo 战胜李世石
· 2017 年:Google 提出 Transformer架构,全面替代 RNN 成为 NLP 与多模态的事实基础
· 2018-2020 年:BERT、GPT 系列开启预训练-微调范式;GPT-3(2020)展现大规模参数带来的零样本能力
· 2022-2025 年:ChatGPT 引爆大模型浪潮;Diffusion、MoE · MoE混合专家模型、多模态、Reasoning Model · 推理模型 持续推动 AIGC · 人工智能生成内容 工业化
6、主要类型 / 分类:
· 按架构:CNN(图像)、RNN/LSTM(序列)、Transformer(语言/视觉)、Diffusion(生成)、MoE · MoE混合专家模型(稀疏大模型)
· 按任务:判别式(分类、检测、分割)与生成式(Diffusion、AR、GAN)
· 按训练范式:监督学习、自监督学习、对比学习、强化学习与 RLHF人类反馈强化学习 / DPO直接偏好优化
· 按模态:单模态(文本/图像/语音)vs 多模态(视觉-语言、语音-语言、3D 等)
· 按部署形态:云端推理、端侧部署(AI PC)、边缘计算(Edge Computing)
7、应用场景:
· 计算机视觉:图像分类、目标检测、图像分割、视频理解、自动驾驶感知
· 自然语言处理:机器翻译、文本生成、问答、摘要、检索增强生成 RAG 与 Embeddings 表示学习
· 语音技术:语音识别 ASR、语音合成 TTS、说话人识别、语音翻译
· AIGC 与多模态:图像生成、视频生成、音乐生成、数字人 与虚拟主播
· 自动驾驶与机器人:感知-决策-控制一体化系统,具身智能 Embodied AI 的核心算法栈
· 科学计算:AlphaFold 蛋白质结构预测、气象、材料、医学影像等领域的突破
8、优缺点 / 局限性:
优点:自动特征学习:摆脱手工特征工程,端到端从原始数据中提取高层语义;规模红利显著:模型参数、数据与算力三者同步放大时性能持续提升;通用架构:Transformer、Diffusion 等单一架构可跨多任务多模态复用;生态成熟:PyTorch/TensorFlow、Hugging Face、GPU 集群 与推理框架形成完整工程栈
缺点:依赖海量数据与算力:高质量标注与 GPU 集群是硬门槛;可解释性弱:黑盒决策,难以满足金融、医疗等强解释场景;存在幻觉与偏见:大语言模型 易产生事实性错误或放大训练数据偏见;部署成本高:需通过 LLM 蒸馏、模型量化 等压缩手段才能进入低成本/端侧场景
9、常见误区:
· 深度学习 = 大模型(错:深度学习是底层范式,CNN/RNN 也属于可用大模型;大模型属于深度学习应用方式)
· 深度学习可以替代传统机器学习(错:在结构化数据与小样本场景,XGBoost 等仍优于深度模型)
· 模型越大越好(错:存在数据-算力-收益递减,模型量化、LLM 蒸馏 表明小模型+好数据反而更优)
· 深度学习不需要特征工程(错:数据预处理、Tokenizer、Prompt 设计等仍属广义特征工程)
10、相关术语:
父概念:机器学习 Machine Learning、人工智能 Artificial Intelligence
子概念:大语言模型 Large Language Model、NLP · 自然语言处理、计算机视觉 Computer Vision、AIGC · 人工智能生成内容、MoE · MoE混合专家模型、Function Calling
兄弟概念:强化学习、联邦学习、LoRA微调
对比概念:传统机器学习(XGBoost、SVM)、强化学习、符号主义 AI
应用相关:LLM 蒸馏、模型量化、Fine-tuning、Embeddings、AI Ops · AIOps智能运维
11、参考资料:
· 来源:Goodfellow、Bengio、Courville《Deep Learning》(MIT Press,2016)
· 来源:LeCun、Bengio、Hinton 综述《Deep learning》Nature 521(2015)
· 来源:Krizhevsky et al. AlexNet 论文《ImageNet Classification with Deep CNN》NIPS 2012
· 来源:Vaswani et al. 《Attention Is All You Need》Transformer 论文(NIPS 2017)
· 来源:PyTorch 官方文档(待补 URL)