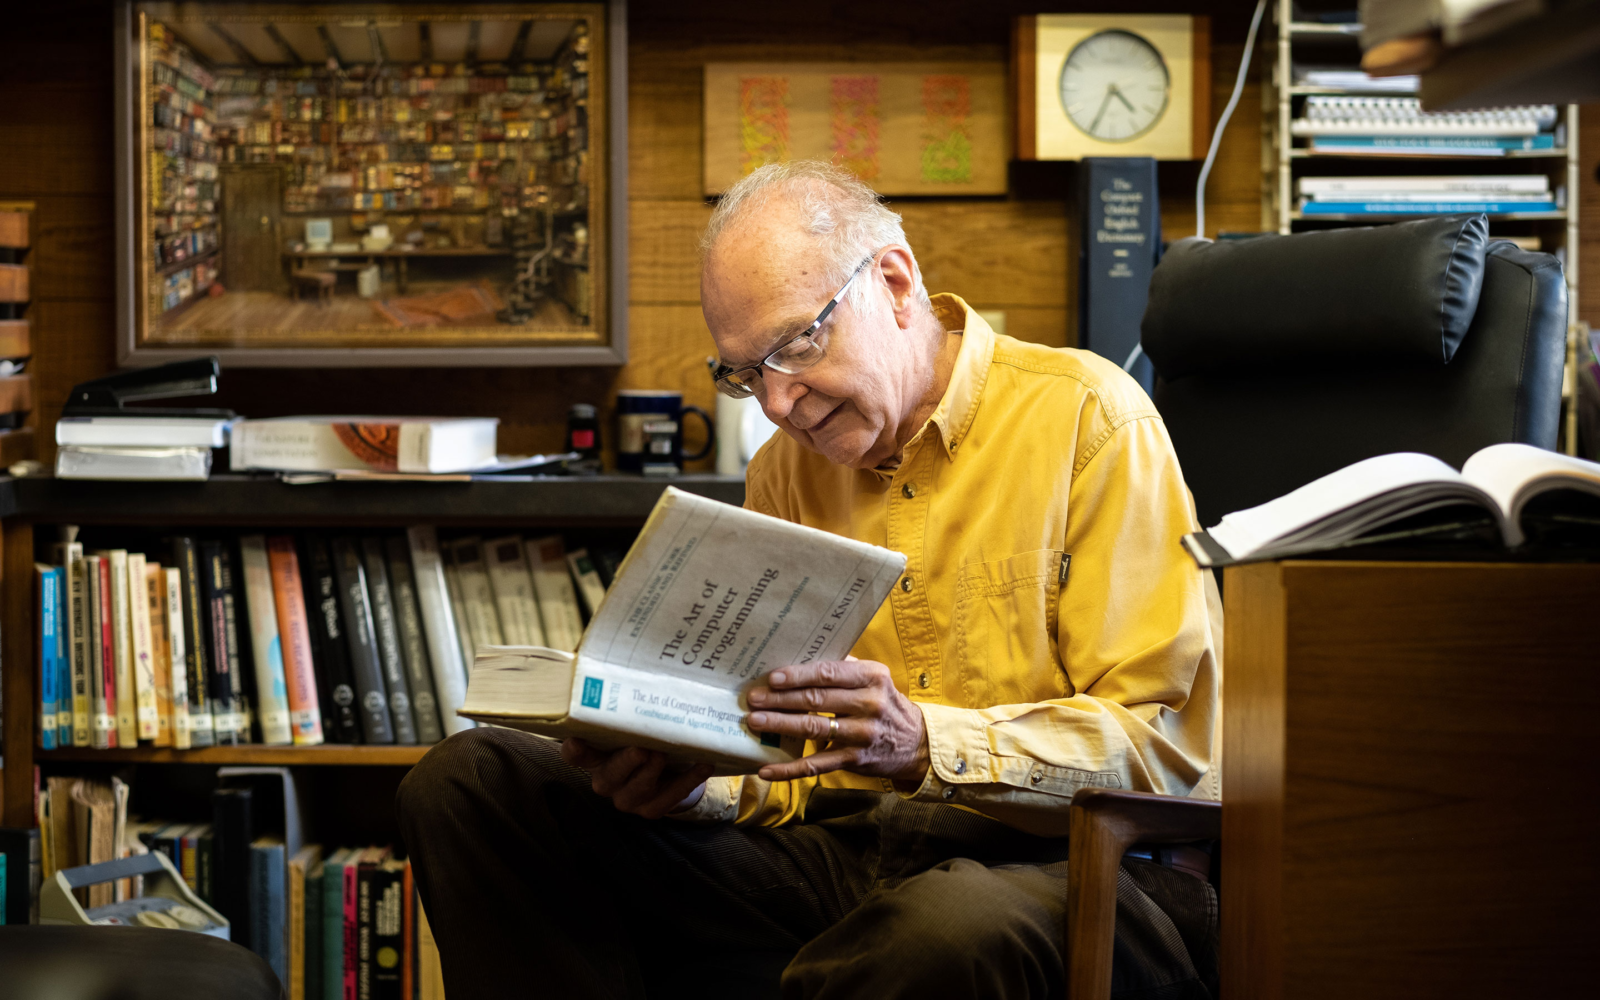
Donald Knuth(高德纳,美国,1938 年生)在 算法分析与计算文献学 领域的位置,很少有人能给出准确坐标。他花了二十多年写《计算机程序设计艺术》,这套书的深度至今没有后来者真正接得住。
一、问题一:编译器报错了,错误到底藏在哪——为什么拒绝”把错误藏起来”
美国威斯康星州密尔沃基,1938 年。这个坐标决定了 Donald Knuth 早年接触到的数学与工程语汇——父亲是记账发明人,配一份《路透社电讯打字稿》,八岁自学《世界年鉴》,十一岁拿化学竞赛银牌,十五岁进克勒技术学院,两年后进入克利夫兰凯斯理工学院
Knuth 的父亲是一套记账系统的发明人,这个家庭背景直接影响了他对”形式化系统”的早期兴趣。记账系统的本质是用固定规则把模糊的日常记录变成精确的结构,这与后来他用算法分析程序的思路完全一致。
他八岁自学《世界年鉴》全书,这本世界最大的统计年鉴教会他的不是地理,而是查找与组织海量信息的方法。他后来在书里专门写过这个经历——认为查字典的能力比记住答案更重要。
他十六岁进克勒技术学院(Case Institute of Technology),选择这所学校纯粹因为离家近、可以走读。这所学校当时是应用数学的强校,课程设置与他的兴趣高度匹配。
二、密尔沃基的数学少年与《南部快报》那份 FORTRAN 编译器
为《南部快报》编写 FORTRAN 编译器的诊断例程 落在 1960 年。核心机制是 他不是随手写编译器,而是为每个错误信息设计精确的现场描述,让使用者知道错在词法、语法还是语义哪一层,但真正的意义不在机制本身——在于 这本编译器至今仍在维护,他因此被《通信 ACM》列入计算机史十大学会著作。
他在加州大学伯克利分校读研时,因为当时商用的 Fortran 编译器在报错信息上过于简陋而闻名。多数编译器遇到语法错误只打印一个错误码,使用者必须自己反推哪里出了问题。
Knuth 的解法不是提高错误检测的精度,而是改写报错的表达方式。他让每个错误信息明确指出:是词法阶段的未定义标识符,还是语法阶段的括号不匹配,还是语义阶段的类型不兼容。这个设计把编译器从”验证器”变成了”教学工具”。
这项工作的影响远超伯克利。此后几十年间几乎所有编译器的错误信息都遵循了这个思路,包括指向出错行的”插入分号”建议、以及对未声明变量的友好提示。Knuth 逝世后,ACM 将《计算机程序设计艺术》列入”算法史上前十的书籍”之一,是程序设计领域唯一的著作入选。
这项工作也直接催生了编译器课程中的一门独立学科:诊断与错误恢复。它研究如何在尽可能少地重新扫描源码的前提下,尽可能多地报告独立错误,这个子问题在今天的工业编译器里仍然是一个活跃的研究方向。
三、问题二:算法怎么教——教科书的三卷与四十年
前后,学界的主流判断仍偏保守。同期多数编译器作者选择让运行时崩溃即止,但 Donald Knuth 选择 他相信错误信息本身就是文档,读者有权知道自己错在哪一行,代价是 他的编译器比同期同类慢约百分之二十,他花了额外的两年才接受这个代价。
这里的争论其实是一个设计哲学之争。当时的主流编译器追求的是”快速拒绝”——发现语法错误立即停止编译。这种设计的逻辑是:让程序员尽快拿到控制权。
Knuth 的观点正好相反。他认为编译器应该尽可能继续运行,尽可能多地报出所有错误,因为一次编译得到十条错误比分成十次编译快十倍要高效得多。这个思路后来被称为”错误恢复”,成了所有现代编译器的标准行为。
这种设计直接导致了性能代价:为了报出更多错误,编译器必须做错误恢复与状态回溯,这些额外工作拖慢了编译速度。在当时的硬件条件下,这个代价尤为明显。
更重要的是,Knuth 在《计算机程序设计艺术》里把这套理念完整地文本化了。他用 MIX 汇编机作为虚拟机器,每个算法都要手工追踪具体的指令执行过程,读者可以看到程序到底是哪一步出了错。这种手写级别的严谨,后来成了算法教学的标准范式。
四、TeX 与他对待”精确”的固执
1968 年的 《计算机程序设计艺术》第一卷出版 是 Donald Knuth 的分水岭。用 MIX 汇编机 + 语义化算法符号,让每个程序的执行成本可以用代数方式推导,这一点后来被整个 算法分析 领域反复引用,而 至今全球仍在使用的 Knuth 结构化同余算法就出自第一卷。
五、他坚持的那种洁癖:一份关于”正确性”的洁癖
Donald Knuth 反复申明的观点是 “计算机科学的任务不是让程序跑得快,而是让程序的行为完全可预测;任何依赖运气、依赖平台、依赖字长假设的写法,都应视为缺陷。”。这不是理论推演,而是 Donald Knuth 走过 斯坦福大学 与 之后的实际结论。