一、什么是RAG 评测
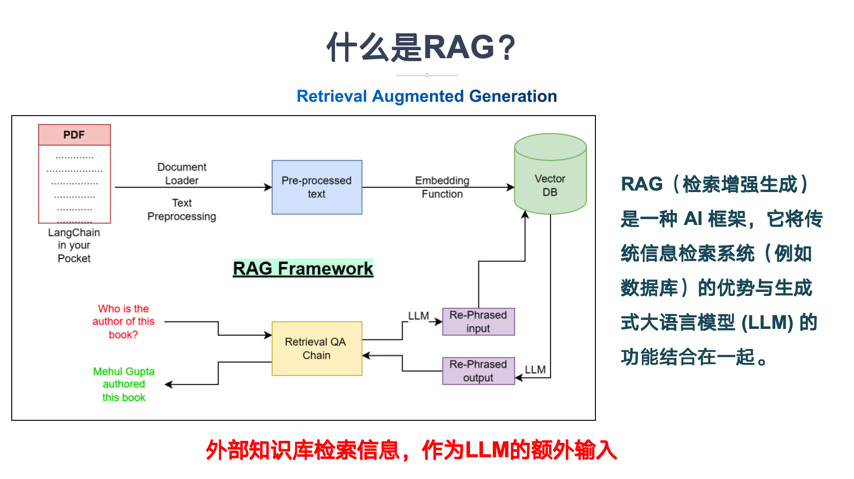
RAG 评测是指对检索增强生成系统在检索质量、生成质量、答案忠实度与端到端任务表现等维度进行系统化度量的方法体系,目的是发现系统弱点、指导模型与提示词的迭代优化。它既覆盖传统的检索指标(召回率、MRR、NDCG),也覆盖生成指标(忠实度、相关性、流畅性、引用准确率),近年还涌现出 RAGAS、ARES、TruLens 等端到端自动化评测框架。RAG 评测是 RAG 系统从「能跑」走向「可信、可对比、可生产」的关键工程支撑。
二、原理
1. 评测维度拆解:把 RAG 系统拆分为检索(Retrieval)、生成(Generation)、端到端(E2E)三层,每层定义独立指标 → 2. 检索指标:在文档级与段落级用 Recall@K、MRR、NDCG 评估召回质量,结合负样本挖掘提升区分度 → 3. 生成指标:用 BLEU、ROUGE、BertScore 等衡量与参考答案一致性,用忠实度(Faithfulness)衡量答案是否被证据支持 → 4. LLM-as-a-Judge:用强模型作为裁判评估开放性回答的相关性、完整性与安全性,降低人工评测成本 → 5. 端到端评测:通过 RAGAS、TruLens 等框架集成上述指标,自动输出多维度报告 → 6. 持续监控:把评测流水线接入生产流量,定期回放与监控线上表现漂移
三、信息卡片
| 中文名 | 检索增强生成评测 |
| 英文名 | Retrieval-Augmented Generation Evaluation |
| 缩写 | RAG Evaluation |
| 别名 | RAG 评测、检索增强生成评估、RAG Evaluation |
| 提出者 | 学界与开源社区共同推动;代表性框架:RAGAS(Exploding Gradients)、ARES(Stanford)、TruLens、Tonic Validate |
| 提出时间 | 2020-2021 年(早期 RAG 指标);2023-2024 年(RAGAS、ARES 等端到端框架爆发) |
| 所属类别 | AI 技术 > 工程层 > 模型评估 |
| 核心技术 | 检索指标、生成指标、忠实度检测、LLM-as-a-Judge、人类反馈、自动评测框架 |
| 主要应用 | RAG 系统上线前验收、A/B 测试、模型与提示词迭代、Self-RAG 与 GraphRAG 评测 |
四、历史时间线
- 2020 年:RAG 原始论文提出检索召回率与生成质量的初步评测方法
- 2021-2022 年:开放域问答基准(Natural Questions、TriviaQA、HotpotQA)成为 RAG 评测的事实载体
- 2023 年:随着 ChatGPT 引爆企业 RAG 落地,传统指标难以覆盖开放性回答,LLM-as-a-Judge 方法快速流行
- 2023 年底:Exploding Gradients 发布 RAGAS 框架,整合忠实度、答案相关性、上下文相关性等指标,成为事实标准之一
- 2024 年:ARES(Stanford)、TruLens、Tonic Validate 等框架相继发布,覆盖多领域、多语言的 RAG 自动评测;Self-RAG 与 GraphRAG 的对比评测成为热点
- 2025 年:RAG 评测与 RAG 评测平台化结合,成为大模型企业部署必过的「评测关」,并纳入 人工智能治理 框架
五、分类
按评测层次:检索指标(Recall、MRR、NDCG)vs 生成指标(忠实度、相关性)vs 端到端任务指标
- 按评测方式:人工评测 vs 自动指标 vs LLM-as-a-Judge vs 人机结合
- 按评测粒度:文档级 vs 段落级 vs 答案级 vs 引用级 vs 用户感知级
- 按场景:通用开放域 vs 企业知识库 vs 多跳问答 vs 多模态 RAG
- 按工具链:开源框架(RAGAS、TruLens、ARES)vs 商业平台(LangSmith、Weights & Biases、Helicone)
六、应用场景
- RAG 系统上线前验收:在金融、政务、医疗等强合规场景,RAG 评测是企业上线大模型的硬门槛
- 模型与提示词迭代:通过对比不同 Embeddings、Chunking、Prompt 的评测结果,指导版本迭代
- Self-RAG 与 GraphRAG 对比:用 RAGAS 等框架在多跳问答、复杂推理任务上横向对比 Self-RAG、GraphRAG、图增强检索增强生成 等方法
- AI Workflow 与 Agent 评测:在 Dify、Coze 等平台的 AI Workflow 中嵌入评测节点,对每条流程打分
- 持续监控与漂移检测:把评测流水线接入生产流量,定期回放与监控线上表现漂移
- AI 治理 与 合规:在 人工智能治理 框架下保留评测记录,作为可审计证据
七、优缺点
优点:把模糊好坏变可量化:用指标把「RAG 系统好不好」变成可对比的工程问题;降低上线风险:在金融、政务等强合规场景,评测是大模型落地的硬门槛;支持快速迭代:通过指标变化快速定位 Embedding、Chunking、Prompt 的优化方向;促进方法演进:统一的评测基准让 Self-RAG、GraphRAG 等新方法可被公平对比
- 缺点:评测与用户感知脱节:自动指标与最终用户体验相关性有限,仍需人工评测补足;LLM-as-a-Judge 偏差:裁判模型本身有偏,需要多模型投票或人类抽检校正;评测集构造昂贵:高质量企业级评测集需要大量人工标注;指标可被刷分:过度优化单一指标会引发「刷榜式」优化,牺牲整体质量
八、常见误区
- RAG 评测 = 看答案对不对(错:答案对只是表层,还需要评估忠实度、引用质量、拒答能力等多维度)
- LLM-as-a-Judge 取代人类(错:LLM 裁判有偏差,关键场景仍需人类抽检与对抗测试)
- RAG 评测是一次性工作(错:RAG 评测需持续运行,线上数据分布漂移会迅速劣化表现)
- 指标越高越好(错:过度优化单一指标会引发刷榜,损害整体与长期质量)
九、关联概念
- 父概念:RAG · 检索增强生成、大语言模型 Large Language Model
- 子概念:RAG · 检索增强生成、Self-RAG、GraphRAG、图增强检索增强生成、向量检索
- 兄弟概念:RAG · 检索增强生成、Self-RAG、GraphRAG、图增强检索增强生成、RAG 评测
- 对比概念:RAG · 检索增强生成、Self-RAG、GraphRAG、图增强检索增强生成
- 应用相关:RAG · 检索增强生成、Self-RAG、GraphRAG、图增强检索增强生成、AI Workflow