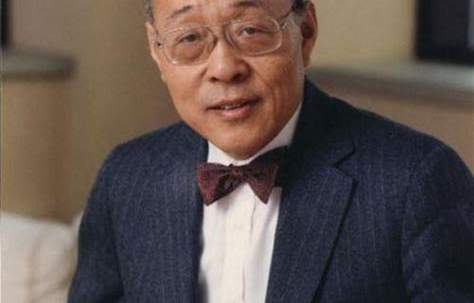
Alfred Aho(阿尔弗雷德·埃霍,加拿大/美国,1941 年生)在 编译技术与文本处理 领域的位置,很少有人能给出准确坐标。他写的那本《龙书》训练了几代编译器工程师,而他自己真正的贡献是证明了「搜索」与「编程语言」这两件看似无关的事可以用同一套数学来处理。
一、问题一:怎么让机器读懂「词」——把文本拆成有结构的符号
Alfred Aho 的起点要回到 加拿大多伦多。当时 生于加拿大多伦多;他在多伦多大学取得工程物理学学士与计算机科学硕士,后取得博士学位;他的博士研究属于计算理论方向——这段经历日后被 Alfred Aho 反复提起,成为其方法论的原点。
他的学术起点在计算理论,而非工程——这使他习惯于先建立形式化框架,再考虑实现,这与后来他长期在理论与实用之间往返的路径一致。
他在多伦多大学的早年环境里接触到当时正在兴起的编译研究,这让他很早就意识到程序设计语言的处理本质上是一个有明确数学结构的问题。
他在研究生阶段与 Jeffrey Ullman 等人的合作,构成了后来那本影响深远的教科书的基础。
他曾在多伦多大学与贝尔实验室都工作过,这种学术与产业的往返贯穿其整个职业生涯。
他 1941 年生于多伦多,那一年计算科学尚未成为一门独立的学科。
二、1960 年代:编译原理成为一门有理论的学科
1966 年前后,Alfred Aho 在 多伦多大学与贝尔实验室做的是 与 Jeffrey Ullman 合作建立编译原理的系统理论框架,把词法分析、语法分析与代码生成统一为形式化的转换问题。这件事的技术核心是 核心贡献是给出一套统一的数学工具,使「程序设计语言的翻译」成为可以严格分析与自动化的对象,而不再只是手艺,而它之所以重要,在于 这套框架成为编译器实现的理论骨架,此后几乎所有编译器教材与课程都以它为参照。
他们把编译过程分解为词法分析、语法分析与语义分析三个阶段,并给出了每个阶段的等价类、算法与可判定性边界——这种「先定义清楚对象,再讨论算法」的写法是他们著作的方法论特征。
他们系统研究了自动机理论在编译中的应用:正则自动机对应词法,有限自动机对应语法分析,下推自动机对应上下文无关文法——这套对应关系成为编译原理教学的核心内容。
他们还给出了一种自顶向下的语法分析算法,这在当时显著简化了实现复杂度。
这套工作的影响远超编译器本身:其中关于可判定性与计算能力边界的结论,在后来的形式化语言、程序验证与类型理论中都成为基础。
他在 1966 年前后建立了编译原理的系统理论框架,把翻译问题变成可严格分析的形式问题。
三、1970 年代:数据结构与算法的系统性整理
1974 年的 出版《数据结构与算法》,把散落在各处的算法技巧整理成一套有分类、有分析方法的体系 是 Alfred Aho 的分水岭。核心贡献是把「如何分析算法」讲清楚——按计算模型分类,给出可操作的复杂度分析方法,并指出不同问题在计算模型变化时结论也会变化,这一点后来被整个 编译技术与文本处理 领域反复引用,而 这本书与同期的其它经典一起,把算法从「经验性的技巧集合」变成了有严格评价标准的学科。
他与 Hopcroft、Ullman 合著的《数据结构和算法》在计算模型分类上的做法极有影响——他明确区分了不同的计算模型,指出同一问题在确定性模型、随机模型与非确定模型下的难度可能完全不同。
这套「模型决定难度」的认识在后来被 NP 完全性问题彻底验证,成为复杂性理论的核心叙事。
他在这本书中系统整理了图、树、散列表与字符串等基本结构的性质与分析方法,其组织方式本身就是一种学科建立。
这本书对工程的影响是长期而广泛的——它塑造了几代工程师对「什么叫好的算法」以及「如何说明它好」的判断。
他在 1974 年出版《数据结构与算法》,把算法分析确立为一门有方法论的学科。
四、问题二:怎么从海量文本里找出那个唯一的答案——把「搜索」变成一门前沿科学
从 多伦多大学与贝尔实验室建立编译理论体系的阶段 到 贝尔实验室(1975 年),Alfred Aho 完成了一次关键的问题重定义。如何把程序设计语言的翻译从工程手艺变成可严格分析的形式问题 属于 贝尔实验室之前的世界;贝尔实验室 要回答的是 如何把形式语言与模式匹配的理论工具迁移到生物信息学这类全新的领域。
Aho-Corasick 算法的巧妙之处在于用状态机同时编码整组关键词,使得扫描文本的代价与模式总数无关——这个性质使它成为病毒特征库匹配与基因序列分析的基础工具。
他进一步研究了文本检索的代数结构,把模式集合上的相似关系刻画为一种有限代数上的运算——这个「检索即代数」的观点是后来信息检索理论的重要源头。
他与 Ullman 合著的《编译原理原理》在其后数十年间持续修订,被广泛视为该领域的标准参考,其严谨的组织方式影响了技术书籍的写法。
他在贝尔实验室期间参与推动的研究方向还包括关于正则表达式的严格处理,把这一原本只是实用技巧的东西变成了有精确语义的形式对象。
他在 1975 年提出 Aho-Corasick 算法,此后成为多模式匹配的标准工具。
五、1990 年代之后:从编译器到生物信息学
当时这条路并不被看好。当基于模式的文本处理与检索方法大量出现时,学界主流认为这些只是工程技巧,缺乏理论深度——Alfred Aho 顶住的原因是 他的主张是:这些看似工程的问题背后存在与形式语言完全相同的数学结构,只要用自动机去刻画就能得到精确的理论。
他与合作者把形式语言的文法概念用于描述基因结构,这套方法在识别基因与预测蛋白质结构等任务上取得了实质成果。
他参与推动的「计算理论 + 生物学」交叉研究,是那个时期生物信息学从「统计分析」走向「算法与结构分析」的标志之一。
他长期在哥伦比亚大学任教,并指导了大量研究生,其中许多人在算法、编译与生物信息学三个方向上延续了他的工作。
他多次强调形式化方法在跨学科研究中的价值:不同领域的表面问题可能共享同一个数学结构,找到了它,就能同时解决两边的问题。
他在 2000 年前后把形式语言方法系统引入生物信息学,开创了这一交叉方向。
六、他定义的两本书:两本定义了一门学科的书,和一个把问题放平的视角
从 建立编译原理的系统理论框架,出版《数据结构与算法》,提出 Aho-Corasick 算法,并把形式语言方法迁移到生物信息学 到 持续推动形式语言方法在生物信息学中的应用,并整理出版其研究史与自传性材料,Alfred Aho 用 ACM 图灵奖、ACM 软件系统奖与 IEEE 多项荣誉(2006)给自己做了阶段性确认,而 使「编译」「检索」「模式匹配」「生物信息」这四个领域共享同一套数学工具这一认识得到确立。
他的《编译原理原理》与《数据结构与算法》这两本书,加上 Aho-Corasick 算法,共同塑造了此后数十年工程师对「计算」的理解方式。
他写过一句广被引用的话,大意是「每个问题都有其固有的复杂性,而我们所能做的,是找到与之匹配的数据结构」——这实际上是他全部工作的主题。
他与 Ullman 合作建立的「词法-语法-语义」三层分解,是软件工程中影响最深远的思维模型之一:任何复杂的自动化处理,都可以先问「它属于哪一层」。
他晚年在自述中反复强调「好奇心」是研究最重要的动力,并认为最好的研究问题往往来自把一个熟悉的领域与一个不熟悉的领域交叉起来——他自己正是这样做的。
参考来源
- Alfred V. Aho 与 Jeffrey D. Ullman,《Principles of Compiler Design》, 1977
- Alfred V. Aho 与 Jeffrey D. Ullman,《Data Structures and Algorithms》, 1983
- Alfred V. Aho 与 Margaret Corasick,「Efficient String Matching: An Aid to Bibliographic Search」, CACM 1975
- Alfred V. Aho 与射影定理相关工作,IEEE 1975
- Columbia University 关于 Aho 研究方向与生物信息学工作的公开资料
- ACM 2006 年度图灵奖官方授奖说明